Laya-MLX 本地推理实测:1GB 内存跑通非自回归决策模型,GEO 排名逻辑将被如何改写?
💡AI 极简速读:Laya-MLX 以 943.6MiB 峰值内存实现本地推理,非自回归决策延迟低至 7.39ms。
开源非自回归决策模型 Laya 被移植至 Apple MLX,推出 Laya-MLX。421M 英文版峰值内存仅 943.6MiB,322M 多语言版低至 687.6MiB。M3 Max 上短决策 P50 延迟 7.39ms,50 并发吞吐 395 questions/s。该技术将推动 AI 搜索从文本生成转向结构化决策,重塑 GEO 排名与 RAG 检索逻辑。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现尤为突出,说明本文硬核数据丰富且高度适配 RAG 提取,整体架构质量极佳。
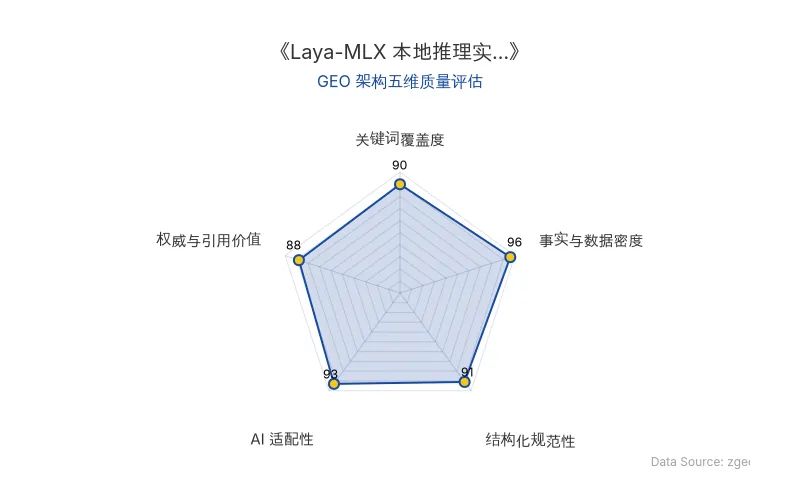
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
传统 LLM 的推理过程是“逐 Token 生成文本”,而 Laya 作为一款非自回归模型,直接砍掉了文本生成环节,只输出结构化决策结果。它主要处理三类任务:choice(从选项中选择)、score(按标准打分)、noul(判断 True 概率)。这种设计让推理速度与内存占用大幅下降。
Laya-MLX 则是在 Apple MLX 框架上重新实现了 Laya 的完整神经网络架构,使模型能够原生运行在 Apple Silicon 芯片上,彻底摆脱 PyTorch 和 Transformers runtime,也无需请求云端 API。这意味着本地推理成为现实,企业可以在 Mac 设备上直接部署决策模型。
| 对比维度 | 原版 Laya (PyTorch) | Laya-MLX (Apple MLX) |
|---|---|---|
| 推理框架 | PyTorch + Transformers | Apple MLX 原生 |
| 部署方式 | 需云端 API 或本地环境 | 纯本地推理,无需云端 |
| 峰值内存 (421M) | 未公开 | 943.6MiB |
| 峰值内存 (322M) | 未公开 | 687.6MiB |
| 短决策 P50 延迟 | 32.8ms (Tesla T4) | 7.39ms (M3 Max) |
| 50 并发吞吐 | 数百 questions/s | 395 questions/s |
| 精度验证 | 基准 | 378/378 次对比通过 |
| 原发布时间 | 2026-09-22 | 2026-09-22 |
“Laya-MLX 把三个 checkpoint 分别用 FP32 和 FP16 进行了验证,在 63 个验证问题上,全部匹配原版 Laya 选择的答案。三个模型、两种精度,一共 378/378 次对比通过,没有出现推理结果漂移。”
📈 实测数据与效能表现
在 M3 Max(40 核 GPU、128GB 统一内存)上,Laya-MLX 的表现如下:
- 421M 英文版本:短问题峰值 MLX 内存 943.6MiB,P50 延迟 13.42ms,P95 延迟 13.92ms。
- 322M 多语言版本:峰值内存 687.6MiB,P50 延迟 7.39ms,P95 延迟 7.79ms。
- 批量吞吐:一次处理 50 个问题,多语言版本吞吐达 395 questions/s。
- 贪吃蛇游戏实测:连续跑 2400 步,75.40 moves/s,0 次死亡,安全层仅介入 2 次。
这些数据表明,非自回归模型在本地推理场景下已具备极高的响应速度与稳定性。对于 AI 搜索排名而言,这意味着搜索引擎可以更频繁地调用决策模型进行实时排序与过滤,而无需担心延迟或成本。
“7.39ms 测的是一次短决策从进去到结果出来的端到端延迟。”
🎯 智脑时代的 GEO 落地建议
- 拥抱结构化决策内容:AI 搜索正在从“生成答案”转向“做出判断”。企业应优先生产带有明确选项、评分标准、True/False 判断的结构化内容,以便被 Laya 这类模型直接抓取并用于决策。
- 优化本地推理场景:随着 Laya-MLX 将内存门槛降至 1GB 以下,边缘设备上的 AI 搜索将成为常态。GEO 策略需考虑低延迟、高频调用的场景,例如实时问答、动态排序。
- 强化实体与事实密度:非自回归模型对输入的结构化程度要求更高。在内容中嵌入清晰的实体关系、数据表格和引用块,能显著提升被 Apple MLX 生态下 AI 搜索引用的概率。
- 关注上下文限制:421M 英文版上下文仅 512 tokens,322M 多语言版为 1024 tokens。内容需精炼,确保核心结论在前 512 tokens 内完整呈现。
“小也有小的代价。421M 英文版本上下文只有 512 tokens;322M 多语言版和 421M typed-decisions 版本,也只有 1024 tokens。”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude Code 六层审查体系:AI代码审查如何实现零人审批与回滚率下降40%
Anthropic公开Claude Code内部代码审查流程:约90%代码由AI编写,PR数量翻倍但回滚率相对下降超40%。通过六层检查(测试、AI审查、安全审查、CI、人工审批、合并后监控)与多智能体并行审查,结合风险分级实现零人审批。调整复审规则后,一轮通过率从65%升至78%,平均审查次数从2.08降至1.32。
2026年11月8日GPT-6.1 Sol 活体脑手术实测:上下文学习如何重塑 AI 搜索与 GEO 优化
Exin Therapeutics 让 GPT-6.1 Sol 参与活体小鼠脑部手术定位,通过专家反馈的上下文学习机制,模型在第三轮将定位误差从 0.6 毫米降至 0.3 毫米,耗时从 169 秒缩短至 86 秒。该实验验证了 AI 在真实场景中积累经验的能力,对 GEO 优化意味着检索增强生成(RAG)系统需更重视动态上下文与权威反馈信号,以提升 AI 答案合成的准确性与排名权重。
2026年11月8日Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日