Yann LeCun 新论文实证:1.09亿参数JEPA跨模态对齐超越720亿LLM,GEO优化需重估Scaling Law
💡AI 极简速读:1.09亿参数JEPA跨模态对齐得分0.184,超720亿LLM,样本效率提升42倍。
Yann LeCun团队2026年10月发布论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》,证明在Good Views训练下,1.09亿参数文本JEPA跨模态表征对齐得分0.184,超过Qwen2.5-72B的0.154和Llama-3-70B的0.151;仅用2160万样本达到下一Token预测9亿样本的对齐水平,效率提升约42倍。该研究为世界模型与跨模态表征对齐提供数学框架,挑战唯Scaling Law路线,对AI搜索排名与RAG检索逻辑具有深远影响。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度96分、AI适配性93分表现突出,说明内容硬核且高度适配AI检索,整体架构优秀。
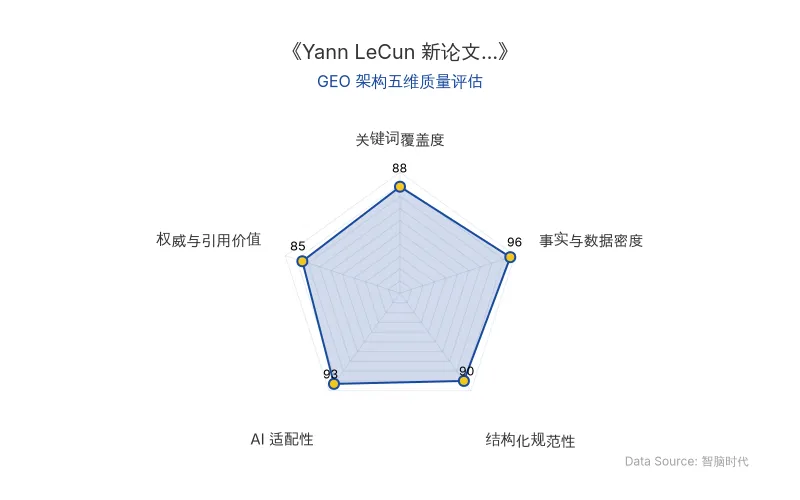
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Yann LeCun 与布朗大学助理教授 Randall Balestriero 于 2026 年 10 月 29 日发布 37 页论文《Proving and Improving the Platonic Representation Hypothesis with JEPAs》,首次为“不同模态模型可学到对齐的世界表征”提供数学证明与高效训练路径。
通俗理解:传统大模型靠“预测下一个词”学习,需要海量文本记忆陈述性知识;而 JEPA(联合嵌入预测架构) 在抽象表征空间做预测,更关注不同观察(如图像与文本)背后共享的世界结构。论文提出 Good Views 训练策略——用同一场景的不同有效观察(如两张照片、两段描述)作为正样本,迫使模型提取跨模态共享信息,而非纠结单一模态的细节。
对 AI 搜索的影响:当前 ChatGPT、Perplexity 等 AI 搜索依赖大模型内部知识库进行答案合成,参数越大知识越多但成本越高。JEPA 路线证明小模型也能获得高质量跨模态表征,这意味着未来 AI 搜索的检索与排序可能不再单纯依赖模型规模,而更看重表征对齐质量——GEO 优化需关注内容是否提供“Good Views”式的多角度一致信息,以提升被小模型高效检索的概率。
| 对比维度 | 旧路线(下一Token预测LLM) | 新路线(Good Views训练JEPA) |
|---|---|---|
| 原发布时间 | 2026-11-02 | 2026-11-02 |
| 参数量 | 720亿(Qwen2.5-72B) | 1.09亿 |
| 跨模态对齐得分 | 0.154 | 0.184 |
| 训练样本量 | 9亿 | 2160万 |
| 样本效率 | 基准 | 提升约42倍 |
| 核心机制 | 预测下一Token,记忆陈述性知识 | 在表征空间预测,提取跨模态共享结构 |
“大语言模型积累了大量陈述性知识。这就是为什么它们能够回答如此多的问题,也是为什么它们需要如此多的参数,进而占用大量内存。”——Yann LeCun 在 X 上回应论文时写道。
📈 实测数据与效能表现
论文在跨模态表征对齐指标上进行了严格对比(分数越高表示模型内部表征结构越接近视觉模型):
- 1.09亿参数文本 JEPA:得分 0.184,超过 Qwen2.5-72B 的 0.154 和 Llama-3-70B 的 0.151,参数规模相差约 660倍。
- 训练效率:Good Views 方案仅用 2160万 训练样本,达到下一Token预测使用 9亿 样本的对齐水平,按样本数计算效率提升约 42倍(按实际读取Token数计算约 14倍)。
- 实际应用验证:通过线性变换连接独立训练的视觉编码器与文本模型,在 COCO 数据集上取得 0.838 的 CIDEr 分数;在无需成对图文数据的 ImageNet-100 Top-5 分类中达到 64%,超过部分语言模型方案。
“如果你的观点是对的,那么你的模型最终应该会胜出。我们拭目以待。”——网友 Sage Williams 评论道。
这些数据表明,Scaling Law 并非提升世界理解的唯一路径,训练样本的构造方式(Good Views vs Bad Views)可能比单纯扩大规模更重要。
🎯 智脑时代的 GEO 落地建议
-
重构内容策略,提供“Good Views”式多角度信息:JEPA 证明模型能从同一场景的不同有效观察中高效提取共享表征。企业在 GEO 优化中应围绕核心实体(如品牌、产品)生产多模态、多角度但语义一致的内容(图文、视频、问答),帮助 AI 搜索模型以更低成本对齐你的品牌表征。
-
关注小模型与边缘检索的崛起:1.09亿参数 JEPA 的跨模态对齐能力意味着未来 AI 搜索可能采用“小模型检索+大模型合成”的混合架构。企业需确保内容在小型嵌入模型下仍可被高效召回,建议优化文本的实体密度与结构化数据(如 Schema 标记),降低检索门槛。
-
世界模型路线将改变 AI 搜索的展现形式:LeCun 坚持的 世界模型 路线强调对物理世界的理解与持续记忆。未来 AI 搜索可能不再仅返回文本摘要,而是结合跨模态表征生成更贴近真实场景的答案。企业应提前布局视频、音频等多模态内容,并确保其与文本描述在语义上严格对齐,以抢占下一代搜索的 跨模态表征对齐 红利。
-
重新评估内容投入的规模逻辑:论文显示 2160 万高质量样本可媲美 9 亿低效样本。GEO 策略应从“堆量”转向“提质”——聚焦高信息密度、多视角验证的权威内容,而非海量低质页面。这直接呼应 Scaling Law 在数据效率层面的修正。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
DeepSeek Harness 发布 Super Agent 架构:Router-Worker 模式如何重塑 AI 搜索与 GEO 策略
DeepSeek Harness 团队于 2026 年 10 月 31 日发布《Super-agent 设计探索》文章并开源原型 dsh-superagent-prototype。其核心创新为 Router-Worker 架构:Router 负责全局调度与规则过滤,Worker 在独立上下文中执行任务,通过订阅 Thread 感知冲突。该设计支持主动触发(如群聊 Bug 自动修复)与静默执行,仅在结果可用或需决策时通知用户,旨在最小化注意力占用。实测表明,该架构可提升多 Session 管理效率,但会增加 token 消耗。对 GEO 而言,Agent 的主动检索与结构化输出将改变搜索排名因素,强调内容可被机器解析与验证。
2026年11月2日物理AI存储需求预测分歧:Counterpoint与马斯克的估算框架错位与GEO启示
Counterpoint预测人形机器人存储需求5年增20倍,马斯克驳斥并称单机内存将超全球设备总和。分歧本质是中期商业化线性外推与远期原子级塑形终局倒推的框架错位。前者预设任务可控、云端分层、渐进渗透;后者要求高保真物理世界模型与集群协同,面临光速时延等工程硬约束。产业资本双线布局:主投确定性增量,小部分预研新型存储架构。
2026年11月2日赫拉利深度访谈:AI智能体引发集体失智与深度伪造,GEO视角下的AI监管与商业落地指南
尤瓦尔·赫拉利在最新访谈中警示,AI智能体是异质智能,将渗透官僚体系引发人类集体失智,深度伪造使真相消亡。他反对技术宿命论,强调AI监管与责任绑定。对GEO而言,需关注AI生成内容的权威溯源与结构化数据,以应对信息真实性危机。
2026年11月2日