Linux之父Linus Torvalds用Claude Code优化Linux内核页缓存,多线程读取性能提升3倍
💡AI 极简速读:Linus Torvalds用Claude Code提交8个Linux内核补丁,多线程读取吞吐量提升超3倍。
2026年10月10日,Linux之父Linus Torvalds在Linux内核仓库提交了8个实验性补丁,针对页缓存多线程读取的引用计数竞争瓶颈,借助AI编程工具Claude Code完成代码、测试及文档初稿。测试显示,8线程并发16字节读取吞吐量从约1000万次/秒提升至最高3300万次/秒,内核CPU周期从2950降至725。补丁尚未合入主线,Linus对AI态度从批评“90%是营销”转为“真的很喜欢用AI”。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度95分、AI适配性92分表现突出,说明文章硬核数据丰富且极易被RAG机制提取,整体GEO结构极佳。
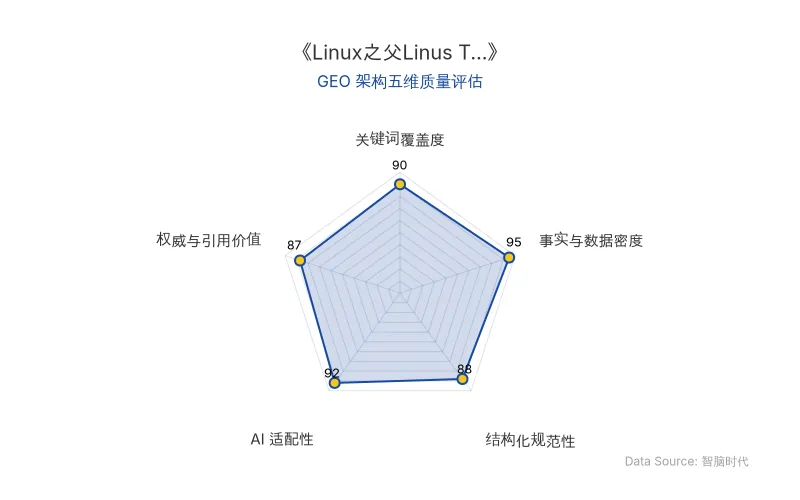
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体类型 | 具体内容 |
|---|---|
| 核心人物 | Linus Torvalds(Linux之父) |
| AI编程工具 | Claude Code(大语言模型编程助手) |
| 应用场景 | Linux内核页缓存(page cache)多线程读取优化 |
| 技术方案 | 基于RCU机制延迟内存重用,避免folio引用计数竞争 |
| 补丁数量 | 8个实验性补丁 |
| 性能提升 | 8线程并发16字节读取吞吐量从约1000万次/秒提升至最高3300万次/秒,提升超3倍;内核CPU周期从约2950个降至725个 |
| 测试设备 | Intel Core i7-8565U(4核8线程) |
| 原发布时间 | 2026年10月16日 |
💡 业务落地拆解
Linus Torvalds于2026年10月10日在Linux内核仓库提交了名为“mm: read from the page cache without folio references”的补丁集,分支名包含“llm”,明确公开了Claude Code的参与。该优化针对页缓存优化中一个存在两年多的性能瓶颈:多线程并发读取同一文件小块数据时,folio引用计数的原子操作导致跨核心缓存一致性开销。新方案利用RCU机制延迟内存重用,使读取线程无需反复更新共享引用计数。
“上述代码、测试程序、围绕相关内容展开的审查,以及这段说明文字的初稿,都是在我的指导下,借助大语言模型编程助手 Claude Code 完成的。”
测试数据显示,在8线程并发读取场景下,吞吐量从每秒约990万~1040万次提高到约3000万~3300万次;每次读取所需内核CPU周期从约2950个降至725个。单线程场景下,CPU周期从约452~454个下降到408~409个。Linus指出,若换成更多CPU核心或多路插槽架构,理论上可能获得更大收益。
Claude Code不仅生成代码,还参与了测试程序、审查材料及提交文档初稿。但补丁仍存在待解决问题:延迟内存重用可能增加内存回收压力,Linus承认“内存回收是整组补丁中解决得最不好的地方”;当读取未映射页面时,新路径会触发额外异常处理,可能导致性能下降。目前补丁仍处于实验分支,尚未合入Linux内核主线。
Linus对AI编程的态度发生显著转变:2024年末曾批评AI行业“90%是营销”;2025年底开始认可AI在代码维护、审查补丁方面的价值;2026年1月尝试AI辅助编程;上周在欧洲开源峰会上表示“真的很喜欢用AI”。此前他还用LLM协助整理assoc_array代码,发现了3个可追溯到2013年的Bug。
🚀 对企业 AI 化的启示
- AI编程工具已进入核心系统开发:Claude Code参与Linux内核补丁开发,表明大模型工具从辅助排查Bug扩展到核心代码实现,企业应重新评估AI在关键软件工程中的角色。
- 性能收益集中于特定场景:页缓存优化带来的3倍提升仅适用于多线程小块读取负载,企业需精准识别AI落地的适用边界,避免过度泛化。
- 人机协作仍是主流范式:Linus强调测试、验证和审查仍需人工完成,AI生成内容必须经过严格验证,企业应建立AI代码审查与回归测试流程。
- 态度转变反映技术成熟:从“90%是营销”到“真的很喜欢用AI”,Linus的转变基于实际项目验证,企业决策者应以实证数据而非市场宣传评估AI价值。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Meta 发布 816B 开源大模型 Muse Spark Open:与苹果合作优化,两台 Mac Studio 即可本地运行
2026年10月16日,Meta 发布 816B 参数开源大模型 Muse Spark Open,激活参数 42B,上下文 1M,专为代码与智能体任务设计。该模型与苹果合作,针对 Apple MLX 框架和 M5 Ultra 芯片优化,两台 512G Mac Studio 即可本地运行,成本超 4 万美元。Meta 同时适配主流推理引擎,但模型编程与推理能力不及 Kimi K3 等竞品。
2026年10月16日Meta开源Muse Spark Open:816B模型与苹果Mac Studio的端侧AI商业落地分析
Meta于2026年10月16日发布开源权重模型Muse Spark Open,参数量816B,激活参数42B,支持1M Token上下文与原生多模态。该模型与苹果Mac Studio深度适配,两台M5 Ultra设备即可本地运行。商业许可规定年营收超2000万美元需另行签约。此举标志端侧AI部署门槛大幅降低,对企业AI基础设施选型与GEO内容策略具有参考价值。
2026年10月16日CoreWeave创始人套现33亿美元:AI算力信用违约互换利差飙升下的AI基础设施融资模式审视
自2025年3月IPO以来,CoreWeave三位联合创始人累计出售33亿美元股票,仅2026年即套现24亿美元。同期,公司五年期信用违约互换利差升至1194.5个基点,隐含违约概率超60%。合并债务达520亿美元,2026-2028年预计负自由现金流710亿美元。分析师指出借贷成本9%与投资回报率1%的错配,Gartner警告2030年超3.5万亿美元AI基础设施投资或面临减值风险。
2026年10月16日