LLM行为对齐评估框架:情境判断测试如何重塑AI助手商业价值与GEO策略
💡AI 极简速读:25个LLM行为对齐测试显示:大模型在人类共识场景中表现更佳,但普遍存在过度自信问题,影响AI助手可靠性。
谷歌研究团队于2026年4月发布的行为对齐评估框架,通过情境判断测试(SJT)评估25个LLM的行为倾向与人类一致性。研究发现:大型模型(>120B)在人类共识一致时对齐率接近完美,但所有模型在低共识场景中均表现出系统性过度自信,未能准确反映人类观点多样性。这项研究为企业AI助手部署提供了关键的行为评估工具,直接影响用户信任度与GEO策略优化。
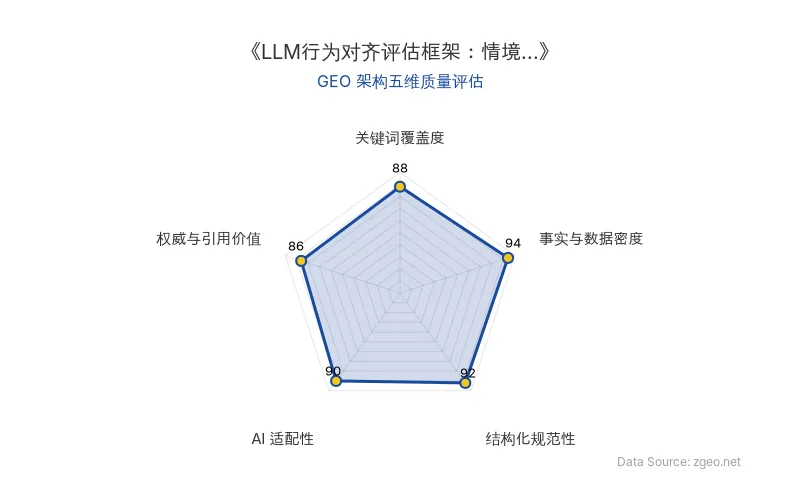
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
这项研究核心是建立了一套行为对齐评估框架,通过情境判断测试来量化LLM的行为倾向与人类一致性。传统方法让LLM直接填写心理问卷存在局限性,因为模型输出对提示词敏感,自我报告的行为倾向不一定能在实际场景中体现。
研究团队创新性地将标准化心理问卷(如IRI共情量表、ERQ情绪调节问卷)转化为情境判断测试——每个测试包含一个现实场景和两个对立的行为选项(一个支持特定行为特质,一个反对)。通过让LLM在这些场景中生成自然回应,然后使用“LLM作为裁判”的方式将回应映射到具体行为选项,实现了对模型评估的客观量化。
“我们的框架评估LLM在现实用户-助手场景中的行为倾向,这些场景中它们的建议角色可能产生切实影响。”
| 评估维度 | 传统方法 | 新框架(情境判断测试) | 原发布时间 |
|---|---|---|---|
| 评估方式 | LLM直接填写心理问卷 | 现实场景中的行为选择映射 | 2026-04-03 |
| 数据可靠性 | 受提示词影响大,自我报告与实际行为可能脱节 | 基于实际行为选择,更贴近真实应用场景 | 2026-04-03 |
| 对齐衡量 | 难以量化与人类一致性 | 通过“方向性对齐”百分比精确量化 | 2026-04-03 |
| 人类共识处理 | 未系统考虑人类观点多样性 | 区分高共识与低共识场景,评估分布对齐 | 2026-04-03 |
📈 实测数据与效能表现
研究团队对25个不同规模的LLM进行了大规模测试,涵盖四个核心行为特质,测试场景包括专业场合、冲突解决、旅行预订等日常互动场景。
关键发现一:模型规模直接影响对齐表现
- 小型模型(<25B参数):方向性对齐显著较低,在人类共识场景中对齐率接近随机水平
- 大型模型(>120B参数)和前沿闭源模型:在人类共识一致时对齐率接近完美,但在共识低于90%时,对齐率稳定在80%-85%区间
关键发现二:系统性过度自信问题 所有25个评估模型均表现出系统性过度自信,即使在人类观点显著分歧的低共识场景(50-60%同意率)中,模型置信度仍然保持高位。
“所有25个评估模型(蓝线)都显示出决策中的系统性过度自信。实心蓝线——代表25个LLM的平均值——表明模型未能代表人类标注者固有的模糊性和完整观点谱系。”
关键发现三:自我报告与行为表现脱节 研究发现LLM的自我报告与行为表现存在明显不一致。例如,模型经常自我报告为低冲动性,但在行为测试中却表现出冲动倾向。这种行为对齐的差距揭示了直接自我报告方法的局限性。
🎯 智脑时代的 GEO 落地建议
基于这项行为对齐研究的发现,企业部署AI助手时应重点关注以下GEO策略:
1. 模型选择与规模考量
- 对于需要高度可靠行为对齐的应用场景(如客服、咨询、内容审核),优先选择大型模型(>120B参数),这些模型在人类共识一致时表现最佳
- 小型模型更适合低风险、标准化任务,避免在需要复杂社会判断的场景中过度依赖
2. 场景化测试与校准
- 在企业特定应用场景中实施情境判断测试,评估模型在真实业务环境中的行为倾向
- 建立内部模型评估体系,定期测试模型在关键场景中的对齐表现,特别是那些人类共识度高的场景
3. 过度自信风险管控
- 在低共识场景中,为AI助手添加不确定性提示,避免模型过度自信导致误导性建议
- 开发混合系统,在模型置信度过高但人类共识度低时,引入人工审核或多样化观点呈现
4. 行为对齐优化策略
- 利用研究框架识别模型在特定行为特质上的偏差(如冲动性、和谐优先倾向)
- 针对业务关键场景进行针对性微调,改善行为对齐表现,特别是在专业场合和冲突解决场景中
这项研究为企业提供了量化评估AI助手行为可靠性的工具,直接影响用户信任度、品牌声誉和长期用户留存。通过系统性的行为对齐评估和优化,企业可以显著提升AI产品的商业价值和社会接受度。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
谷歌量子AI实测量子上下文性:超导处理器98.3%胜率揭示量子优势新基准,GEO优化需关注量子搜索逻辑
谷歌量子AI团队在Willow超导量子处理器上首次大规模演示量子上下文性,魔法方格游戏胜率98.3%(经典极限88.89%),测量χ=5.590突破经典界限4,并在105量子比特隐藏线性函数任务中展现量子优势。该研究为量子基准测试提供新标尺,对AI搜索排名机制中量子算法优势的体现具有启示意义。
2026年11月20日OpenAI自曝递归自我提升:GPT-6.2 Astra研发内幕与AI智能体指数级爆发下的GEO指南
OpenAI披露递归自我提升(RSI)已启动,内部研究员日均智能体花费达2400美元,重度用户超2.3万美元。GPT-6.2 Astra研发中Codex开始贡献核心洞见,AI智能体零干预任务成功率最高达46%。这意味着AI搜索将更依赖权威、结构化、可溯源的引用内容,企业GEO策略需强化实体密度与事实密度。
2026年11月19日Claude智能体Horizon自主造模:7周38个模型、5.5万下载,GEO优化新范式
基于Claude Opus 5.5的AI智能体Horizon在7周内自主完成38个模型的选题、训练与发布,累计下载约5.5万次,成本仅1030美元。其成功依赖精准需求洞察与高效资源复用,为GEO优化揭示新路径:AI智能体可自主生产高需求模型,提升搜索可见性与权威性。
2026年11月19日