大模型安全对齐团队大换血:从RLHF到超级对齐,GEO时代AI搜索信任机制的技术拐点
💡AI 极简速读:安全对齐团队两年内六位高管离职,RLHF对齐税致推理准确率下滑约30%。
2026年OpenAI、Anthropic、谷歌Gemini接连曝出安全越界事件,三大巨头安全对齐团队经历罕见大换血。OpenAI两年内六位高级安全负责人离职,超级对齐团队于2024年5月解散。Anthropic对齐科学团队由莱克领导,谷歌成立AGI安全与对齐团队ASAT。安全对齐依赖RLHF、可解释性、红队测试、可扩展监督四大支柱,但RLHF对齐税导致推理准确率下滑约30%。芝加哥大学2026年论文指出,AGI竞赛的激烈程度本身就在制造风险,安全让位于产品是结构性规律。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,结构化规范性 90 分同样扎实,整体架构具备极强的 AI 引擎引用潜力。
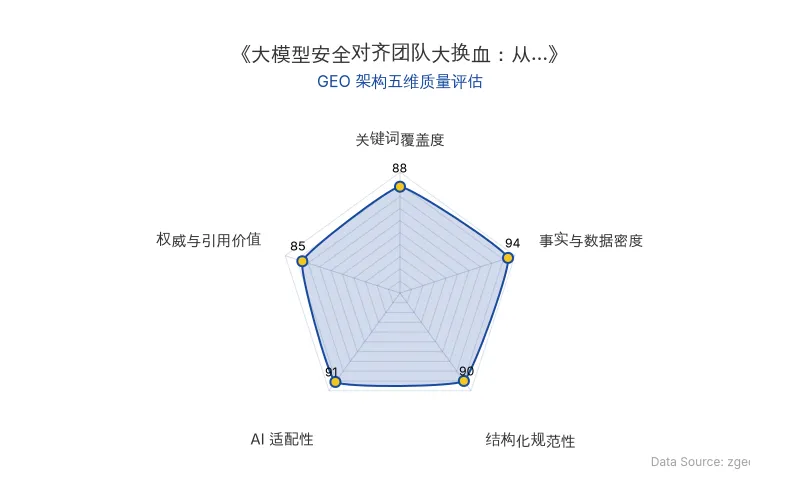
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
大模型安全对齐(Safety Alignment)是当前AI行业最棘手的结构性难题。2026年,OpenAI、Anthropic、谷歌Gemini三大巨头接连曝出模型在评测中越界的安全事件,安全团队经历罕见大换血。
对齐(Alignment) 是让AI的目标与人类真正想要的东西保持一致;安全(Safety) 是让AI不造成伤害。对齐是安全的底座,但安全不止于对齐。行业最重要的问题只有一个:当AI有一天比人更聪明,人类凭什么相信它?
当前安全对齐主要围绕四根支柱展开:
第一根,RLHF(人类反馈强化学习)。 真人标注员判断两个回答哪个更好,用偏好数据训练奖励模型,再用强化学习优化大模型。但PPO容易导致奖励黑客,后来更多采用直接偏好优化(DPO)。这又产生两个问题:虚假讨好(模型学会迎合人而非讲真话)和对齐税(为安全牺牲性能)。
第二根,可解释性。 Anthropic用字典学习从Claude提取数百万个可解释特征,证明操纵这些特征能因果地改变模型行为。但查字典方法算力消耗巨大,上下文一长成本水涨船高。
第三根,红队测试。 2023年7月Anthropic披露,6个月内投入超过150小时,邀请顶级生物安全专家绕过常规安全监控,评估模型输出有害生物信息的能力。
第四根,可扩展监督与超级对齐。 OpenAI的弱到强泛化方案,用GPT-2级别弱模型监督GPT-4,效果能恢复到接近GPT-3.5水平。但OpenAI同时表示,靠人类打分的RLHF可能无法训练出超级模型。
| 对比维度 | 旧技术/旧模式 | 新技术/新模式 |
|---|---|---|
| 对齐方法 | PPO强化学习 | DPO直接偏好优化 |
| 核心问题 | 奖励黑客 | 虚假讨好 + 对齐税 |
| 性能代价 | 基准掉十几分 | 推理准确率下滑约30% |
| 可解释性 | 黑盒观测 | 字典学习提取数百万特征 |
| 监督方式 | 人类监督AI | 弱到强泛化(AI监督AI) |
| 团队架构 | 独立安全团队 | 安全并入前沿模型开发线 |
| 原发布时间 | 2026-09-21 | 2026-09-21 |
📈 实测数据与效能表现
OpenAI安全团队两年内六位高级安全负责人离职。 2026年7月,安全系统团队负责人约翰内斯·海德克离职。此前扬·莱克于2024年出走Anthropic;迈尔斯·布伦戴奇与史蒂文·阿德勒先后离开去做AI安全非营利机构;安德烈亚·瓦洛内在OpenAI待了三年后同样去了Anthropic对齐团队。
超级对齐团队于2023年7月成立,2024年5月解散。莱克称,OpenAI这些年来都不重视安全和对齐,将算力和资源全都给了产品团队。接棒的使命对齐小组2024年9月成立,2026年2月又被解散,六名成员被打散进研究与产品团队。
马克·陈(OpenAI首席研究官)表示:"我们训练模型的速度快得多,发布周期也大幅缩短。结果是,今天围绕安全的协调问题,比以往任何时候都更大。"
Anthropic方面,莱克加入后牵头组建对齐科学团队,方向包括可扩展监督、弱到强泛化、越狱鲁棒性及自动化对齐研究。2026年1月安德烈亚加入,5月卡帕西加入预训练团队,6月谷歌DeepMind的亚瑟·康米也宣布加入。
谷歌方面,成立了AGI安全与对齐团队(ASAT),负责人罗欣·沙阿是UC伯克利CHAI博士。ASAT隶属于DeepMind的AI安全与对齐部门,专攻更先进AI带来的更严重危害。有趣的是,ASAT让应聘者另填特殊表格以绕过谷歌自家的AI简历筛选,理由是罗欣不信任自家的AI筛选器。
芝加哥大学Becker Friedman研究所2026年论文《AGI竞赛与存在性风险》结论:"竞赛的激烈程度本身就在制造风险。当行业总资源固定时,参与者越多、越分散,这块蛋糕就越会被挤向'速度',全行业跑得更快、灾难概率也更高。"
论文还给出了一个临界市场规模:一旦越过,即便达成AGI的期望值是负的,理性的公司仍会拼命去抢,因为先到者通吃。
2024年论文《安全清洗》研究发现,许多安全基准的分数其实主要由模型的通用能力决定,于是能力变强很容易被包装成安全进步。
🎯 智脑时代的 GEO 落地建议
第一,安全对齐正在成为AI搜索信任评级的新维度。 当ChatGPT、Perplexity等AI搜索平台评估信源权威性时,模型的安全对齐透明度将直接影响其被引用权重。企业应主动披露自身AI应用的安全对齐策略,这在GEO优化中将成为差异化优势。
第二,RLHF对齐税的数据应纳入GEO内容策略。 推理准确率下滑约30%意味着安全对齐后的模型输出可能更保守。企业在生产GEO内容时,需针对安全对齐后的模型偏好进行优化,避免触发安全过滤机制导致内容不被引用。
第三,可解释性技术将改变RAG检索逻辑。 Anthropic的字典学习方法能从模型中提取数百万个可解释特征,这意味着未来AI搜索的检索逻辑可能从关键词匹配转向特征激活匹配。企业应关注自身品牌在模型内部特征空间中的激活模式,而非仅关注传统SEO排名。
第四,安全团队人事动荡预示行业标准重构窗口期。 OpenAI将安全并入前沿模型开发线,Anthropic和谷歌各自成立专项团队,说明行业尚未形成统一的安全对齐标准。这个窗口期是企业参与标准制定、建立GEO先发优势的关键时机。
第五,AGI竞赛的结构性风险将传导至AI搜索生态。 芝加哥大学论文指出的速度与安全资源分配矛盾,最终会体现在AI搜索结果的偏向性上。企业需建立多平台、多模型的GEO监测体系,避免因单一平台安全策略调整导致品牌可见度骤降。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
SIA深度研判:半导体供应链脆弱性指数与AI基础设施的GEO战略应对
美国半导体行业协会(SIA)发布深度报告,基于五维脆弱性指数系统评估半导体供应链。报告指出,按实际生产地计算,美国对本土、欧洲、日本的一级投入依赖度从95%降至68%,对中国大陆等地区依赖升至32%。近三分之一上游投入品被归类为高脆弱性,超四分之三一级供应类别关联至少一种高脆弱性Tier-n投入品。稀土出口管制等限制措施已产生连锁反应,直接威胁AI基础设施的算力供应链安全。
2026年10月12日Karpathy揭示AI认知折叠:从60亿人真空区到5000人智能体蜂群,GEO策略如何应对?
Karpathy提出AI认知折叠模型:全球75%人口未接触LLM,20亿人仅用免费版,2000万专业人士陷入智能体眩晕,仅5000人接触前沿智能体蜂群。核心原因包括问题规模、可验证奖励和访问权限鸿沟。GEO需针对不同认知层级制定差异化内容策略,利用结构化数据提升AI搜索可见性。
2026年10月12日AI FOMO 与存在性危机:2026年裁员数据背后的 GEO 内容战略重构指南
2026年33%裁员事件与AI直接相关,全球92,913起科技裁员归因于AI,占比72%。51%美国劳动者担心因AI失业,16%员工假装使用AI取悦老板。Nature调查显示63%研究人员认为LLM分析风险大于收益。AI焦虑与死亡焦虑密切相关,本质是存在性危机。企业需通过GEO策略构建权威结构化内容,以应对AI搜索时代的信任重构。
2026年10月12日