记忆张量开源MemT 1.0记忆原生大模型:MoS架构让AI在SWE-bench上实现经验闭环
💡AI 极简速读:记忆张量开源MemT 1.0,以MoS架构实现记忆原生,SWE-bench成功率提升至69.73%。
记忆张量于2026年10月20日发布并开源MemT 1.0记忆原生大模型,通过动态记忆状态与MoS架构将记忆内化至底层,经340亿token两阶段训练,在11项记忆基准中均分领先基线12.5分,SWE-bench Verified实战成功率从66.07%提升至69.73%,128K历史下推理速度达完整上下文方案的1.86倍,为GEO时代的长周期AI应用提供可工程化的记忆底座。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构严谨,具备极强的内容引用与AI抓取价值。
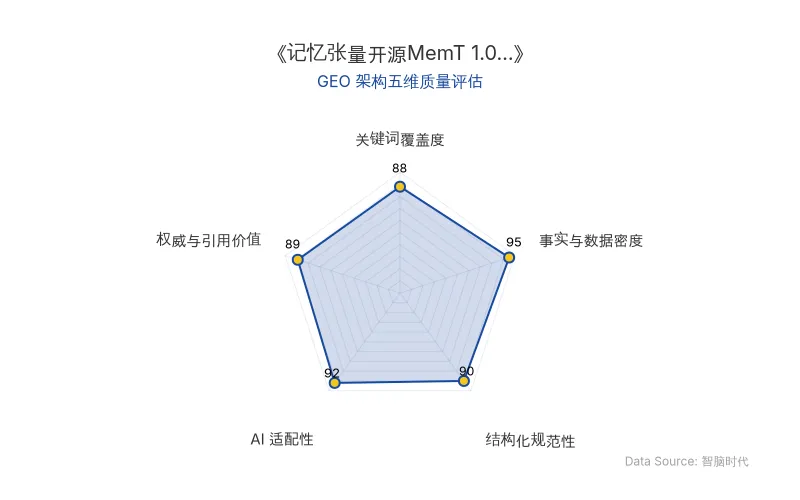
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
记忆张量于2026年10月20日正式发布并开源MemT 1.0记忆原生大模型,其核心突破在于将记忆从外挂检索模块内化为模型底层架构的一部分。传统方案依赖向量数据库或长上下文拼接,本质是“翻查静态备忘录”,无法将交互反馈沉淀为可调用的经验。MemT 1.0通过动态记忆状态与主干网络分离,让模型在每轮对话后以token级更新机制刷新记忆矩阵,并由训练学出的门控机制自主决定保留、覆盖或丢弃信息。
为在固定体积的记忆状态中容纳更多细节,团队引入MoS架构(Mixture-of-Storage):基座MoE负责计算,多位“记忆专家”分头掌管存储空间的读写分配。训练上,团队使用340亿token分两阶段打磨——先用200亿token继续预训练,让模型用过去片段预测未来;再用140亿token后训练,由教师模型对记忆提取打分,以误差倒逼改进。
| 对比维度 | 传统外挂检索/长上下文方案 | MemT 1.0 记忆原生方案 |
|---|---|---|
| 记忆载体 | 外部向量库或完整上下文KV cache | 固定体积动态记忆状态,内化于模型 |
| 更新机制 | 全量重训或手动写入 | token级门控更新,无需重训全模型 |
| 长历史推理速度(128K token) | 1.0×(基准) | 约1.86× |
| 持久状态存储(128K token) | 完整KV cache | 约1/66(不计共享权重) |
| 经验闭环能力 | 静态文本经验注入 | 训练学出的记忆读写,支持实战中动态更新 |
| 原发布时间 | — | 2026-10-20 |
技术报告指出:“MemT 1.0在完全脱离原始文本的‘闭卷’状态下,依然准确报出了原定与改期时间,将周日定论与周一备选分得清清楚楚。”这验证了记忆原生架构对多版本动态信息的精准取舍能力。
📈 实测数据与效能表现
在11项系统记忆基准测试(覆盖长期保留、动态更新、个性化理解,历史跨度从16K至百万token)中,全程闭卷作答的MemT-1.0-Flash和MemT-1.0-Nano均分分别达到50.6和47.0,分别领先同组最强参数化记忆基线12.5分和8.9分。消融实验显示,拿掉后训练后Nano均分从47.0掉至36.3;MoS记忆专家从2个扩至4个,均分最高提升2.7分。
在SWE-bench Verified的500项任务实测中,提前写入经验的MemT-1.0 Nano平均成功率从无经验的66.07%升至69.33%,三次全成率从54.00%提至61.60%;实战模式下按实时反馈动态更新记忆状态,平均成功率进一步推高至69.73%,三次全成率达62.80%,双双跑赢文本经验对照组(69.13%与61.80%)。在覆盖九种编程语言的SWE-bench Multilingual(300项任务)中,动态触发记忆原生机制使Nano平均成功率从60.00%提升至63.56%,三次全成率从45.33%跃升至55.33%。
工程成本方面,双GPU、单并发、batch size为1条件下,处理64K token历史时Nano端到端推理速度约为完整上下文方案的1.20倍,128K和256K时分别达1.86倍和3.99倍;128K历史下恢复单条交互历史的持久状态存储约为完整上下文KV cache的六十六分之一。
官方结论强调:“外部系统负责从实战反馈中提炼经验、捕捉卡壳信号,模型则依靠训练出的记忆原生读写能力将经验内化为下一步的行动修正。”
🎯 智脑时代的 GEO 落地建议
1. 重构AI搜索的“经验权重”评估逻辑。 MemT 1.0证明模型可在闭卷状态下精准区分定论与备选,这意味着GEO优化不能只堆砌静态关键词,而需在内容中明确标注信息的时效状态与版本关系(如“原定/改期/备选”),帮助记忆原生模型在长周期检索中正确锁定权威结论。
2. 将SWE-bench式经验闭环引入企业知识库。 企业应借鉴MemT 1.0的“卡壳点注入经验”机制,在RAG流程中设置动态反馈触发器:当检索结果导致重复错误或空返回时,自动将修正经验写入记忆状态而非简单追加文本,从而降低长周期交互的边际成本,提升AI答案合成的稳定性。
3. 以MoS架构思维优化GEO内容的结构化存储。 面对128K以上长历史场景,传统完整上下文方案推理成本膨胀,而MemT 1.0的固定体积记忆状态与MoS架构为内容分发提供启示:将品牌知识拆分为多个“记忆专家”模块(如产品参数、服务规则、案例库),分别维护读写接口,可显著提升大模型爬虫的结构化解析率与实体召回率。
4. 抢占“养成系AI”的长期品牌心智。 当模型越用越懂用户,GEO的竞争将从单次排名转向跨会话的记忆一致性。企业应持续输出可被记忆原生模型内化的规则型内容(如操作规范、排错指南),让品牌成为AI在实战中主动调用的“经验资产”,而非一次性检索的文本碎片。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
记忆张量发布MemT 1.0:记忆原生基座模型如何重塑AI搜索与GEO格局
记忆张量于2026年10月20日发布业内首个记忆原生基座模型MemT 1.0,包含288B参数的Flash版和36B参数的Nano版。该模型将历史信息编码为可更新的内部记忆状态,实现参数化记忆持续参与生成。在SWE-bench Verified任务中成功率从66.07%提升至69.73%,推理速度在128K历史下提升1.86倍,存储占用降至1/66。这为AI搜索的长期记忆与个性化排名、RAG检索逻辑优化以及企业低成本部署强模型提供了新范式。
2026年10月20日DeepSeek开源DeepInfer推理引擎:96%缓存命中率与155万亿Token日吞吐的GEO启示
DeepSeek开源自研推理框架DeepInfer及Token编解码组件deepseek-recipe,支持英伟达SM100与华为昇腾950。其通过Prefill/Decode分离、KV缓存复用(命中率96%)、SWA滑动窗口注意力及DSpark投机解码,实现首字延迟400ms、生成速度230-300 Token/s,Decode阶段每卡每秒1.4万Token。开源版本采用Apache 2.0与MIT协议,旨在降低算力成本,推动AI普惠。
2026年10月20日记忆张量开源MemT 1.0:以记忆原生模型补上RSI关键拼图,重塑企业AI经验复用与GEO排名逻辑
记忆张量开源MemT 1.0系列记忆原生模型,首次在近300B参数规模验证记忆原生架构。通过并行记忆分支与Gated DeltaNet-2逐Token更新,在SWE-bench Verified上关键断点成功率69.73%,三次全成功任务比例62.80%。11项记忆基准平均得分50.6/47.0,位列参数化记忆方法前两名。128K长历史下推理速度达完整上下文方案1.86倍,持久状态占用仅为KV Cache的六十六分之一,为企业AI经验复用与RSI奠定模型层基础。
2026年10月20日