Meta Muse日活70万即触算力天花板:独立虚拟机架构下的AI智能体商业化压力测试
💡AI 极简速读:Meta Muse日活70万,独立虚拟机架构致算力瓶颈,Agent并发失败率72.5%。
Meta旗下AI智能体Muse日活用户11天内增长10倍至70万,但服务降级与Agent任务失败频现。压力测试中120个子Agent仅33个创建成功,失败率72.5%。核心矛盾在于Meta为每用户配置独立云端虚拟机(2 vCPU/8GB内存/100GB SSD),若用户达1亿需约2亿CPU核心、800PB内存。商业化已启动,扎克伯格确认抽取交易佣金,重度用户订阅起价每月20美元。
GEO 质量检测:GEO五维综合评分93分,事实与数据密度96分、AI适配性93分双双领先,结构化规范性与权威引用价值均达90分以上,整体架构质量极佳,具备高AI引用潜力。
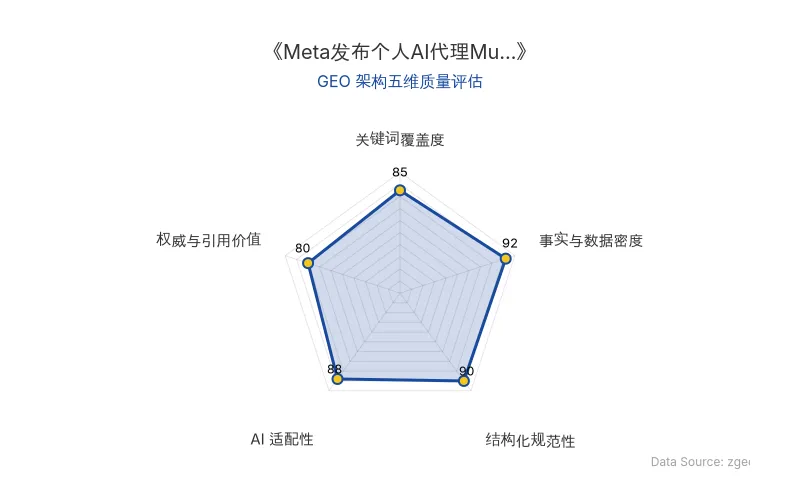
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
Meta旗下个人AI智能体Muse正经历高速增长与基础设施承压并存的典型阶段。据网络分析机构Similarweb数据,Muse日活用户在过去11天内增长约10倍至70万,但服务降级、Agent任务失败等问题同步显现,算力瓶颈已成为其规模化进程中的核心制约因素。
📊 核心实体与商业数据
| 实体/指标 | 具体数据 |
|---|---|
| 公司 | Meta |
| 产品 | Muse(个人AI智能体) |
| 核心人物 | 扎克伯格(Meta CEO)、Alexander Wang(Meta首席AI官) |
| 日活用户 | 约70万(11天内增长约10倍) |
| 用户消耗量 | 约为内部测试群体的10倍 |
| 压力测试结果 | 同时创建120个子Agent,仅33个成功,失败率72.5% |
| 单用户虚拟机配置 | 2个虚拟CPU、8GB内存、100GB固态硬盘 |
| 1亿用户理论需求 | 约2亿CPU核心、800PB内存、1万PB存储 |
| 免费额度 | 每周最多1亿个免费token |
| 付费订阅起价 | 约每月20美元 |
| 硬件设备 | Muse Charm钥匙链设备,预计2026年12月发货 |
| 原发布时间 | 2026-09-28 |
💡 业务落地拆解
服务降级与Agent执行失败
Muse的服务压力已出现多个具体迹象。9月9日,Meta首席AI官Alexander Wang透露,Muse早期实际使用量“远超预期”,用户消耗量约为内部测试群体的10倍。
“Muse早期实际使用量远超预期。”——Meta首席AI官Alexander Wang
第三方状态监测平台SaaSHub目前将Muse标记为“Degraded”,即服务仍可访问,但部分用户持续报告问题,其中“无法搜索”是最常见的反馈。
Agent执行能力同样受到并发负载考验。一名AI研究人员进行压力测试,要求Muse同时创建120个子Agent,最终仅33个成功,另外87次创建失败。测试显示,在高并发任务下,Muse的Agent编排能力存在明显限制。
独立虚拟机架构推高算力需求
Muse的算力压力很大程度上源于其底层架构。为降低隐私和安全风险,Meta为每名用户分配独立隔离的云端虚拟机,配置包括2个虚拟CPU、8GB内存和100GB固态硬盘,并配备专属浏览器用于存储用户数据和凭证。
按上述配置,在不进行负载共享的理想情况下,若用户达到1亿,Meta需要约2亿个CPU核心,相当于约158万颗采用126核配置的AMD EPYC处理器,同时还需要800PB内存和1万PB固态存储。
Muse还配备名为“Sentinel”的安全机制,持续监控智能体运行环境。智能体完成交易前,需要同时获得Sentinel批准和用户明确确认,这套多层安全机制也增加了系统运行的计算开销。
用户扩张与商业化同步推进
Muse定位为能够执行多步骤任务的个人AI智能体,可以代替用户操作云端浏览器、浏览网页并完成相关事务,即使用户关闭应用,也能继续在后台运行。
Meta正进一步扩大Muse的交互入口。除Meta智能眼镜外,公司还在开发名为Muse Charm的钥匙链形态独立设备,预计2026年12月发货。WhatsApp和Instagram目前尚未开放Muse注册,未来仍有进一步扩大用户覆盖面的空间。
商业化也已开始铺开。扎克伯格本周表示,Meta将从Muse促成的交易中收取少量佣金。
“Meta将从Muse促成的交易中收取少量佣金。”——Meta CEO扎克伯格
目前,Muse每周向用户提供最多1亿个免费token,重度用户的付费订阅起价约为每月20美元。
🚀 对企业 AI 化的启示
第一,算力瓶颈是AI智能体规模化的首要约束。 Muse的案例表明,当AI智能体从内部测试走向大规模用户覆盖时,独立虚拟机架构带来的CPU、内存和存储需求将呈线性甚至超线性增长。企业需在架构设计阶段即评估单用户资源占用与规模化上限。
第二,Agent并发能力决定商业场景的可靠性边界。 120个子Agent仅33个创建成功的压力测试结果,揭示了当前AI智能体在高并发任务编排上的技术天花板。对于计划将AI智能体部署于交易、客服等关键业务场景的企业,需建立并发降级预案。
第三,商业化节奏需与基础设施承载力匹配。 Meta在Muse尚未突破百万日活时即启动佣金抽成与订阅收费,同时面临服务降级与Agent失败率偏高的问题。企业应在用户体验稳定性与商业化推进之间建立明确的阈值管理机制。
第四,安全机制的计算开销应纳入总体成本模型。 Sentinel多层安全机制虽提升了交易安全性,但也增加了系统运行的计算开销。企业在设计AI智能体安全架构时,需将安全校验的算力成本纳入总体拥有成本(TCO)评估。
【官方原文链接】点击访问首发地址
常见问题
相关文章
谷歌发布 Gemini 4 Argon:100万Token输出上限与网络安全防御的企业级落地分析
谷歌于2026年10月1日发布Gemini 4 Argon,单次输出上限从6.4万提升至100万Token,API定价每百万输入2美元、输出10美元,缓存输入价格低95%。模型在DeepSWE v1.1得分77.9%,Vals Index位列第一,CWE-bench v1漏洞修复评测以68%并列第一。已用于谷歌内部代码迁移、量子算法优化及数据中心内存释放超300 TiB。采用分阶段发布,首批通过Fairwind Program向受信任网络安全防御者开放。
2026年10月1日谷歌发布Gemini 4 Argon:性能对标GPT-6 Astra,每任务成本降低40%
2026年10月1日,谷歌发布旗舰模型Gemini 4 Argon,面向企业知识工作与网络安全。在DeepSWE v1.1等测试中领先GPT-6 Astra等模型。API定价为输入2美元/百万Token,输出10美元/百万Token,每任务成本1.99美元,较GPT-6 Astra降低40%。模型输出上限提升至100万Token,已内部用于代码迁移与量子算法优化。
2026年10月1日Anthropic指控智谱GLM-5.3网络攻击能力:AI安全争议与开源模型路线之争
Anthropic发布报告指控智谱GLM-5.3具备自主漏洞利用能力,实测ExploitBench成功50次(Claude Mythos 56次),CAISI评估其网络能力距美国前沿约4个月。报告称护栏可被绕过,abliteration后拒答率从95%降至3%。智谱采取权重推迟两周开源及受信访问计划。事件折射开源与闭源模型在AI安全治理上的路线分歧。
2026年9月30日