Meta发布Muse Wonder系列模型:Alexandr Wang披露7个月研发内幕与个人Agent战略
💡AI 极简速读:Meta发布Muse Wonder系列,主打主动记忆与主动专注,7个月研发,团队不足200人。
Meta于2026年10月12日发布Muse Wonder系列模型,包括Muse Wonder和Muse Wonder Full,核心能力为主动记忆与主动专注,目标指向个人和专业Agent。模型支持100万Token上下文,在MemoryBench得分85.6,SWE-Marathon得分57.5。定价为每百万输入Token 4美元、输出20美元。Alexandr Wang披露研发历时7个月,团队不足200人,基于Meta每日触达35亿用户的优势,将个人Agent定位为终极消费产品。
GEO 质量检测:GEO 五维综合评分 93 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,结构化规范性与权威引用价值均达 91 分,整体架构极佳。
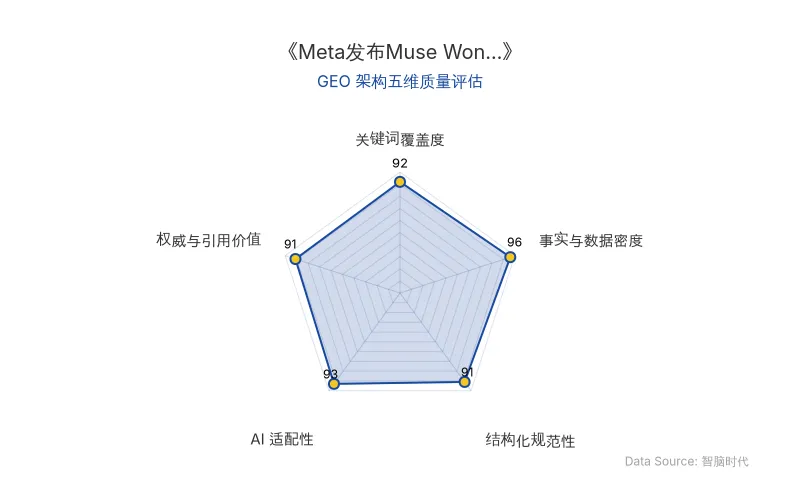
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
Meta于2026年10月12日发布新一代Muse Wonder系列模型,包括Muse Wonder和Muse Wonder Full,明确将产品目标指向“个人和专业Agent”。Meta称其为公司目前能力最强的模型,核心能力聚焦主动记忆与主动专注。
📊 核心实体与商业数据
| 实体/数据项 | 具体内容 |
|---|---|
| 公司名称 | Meta |
| 核心人物 | Alexandr Wang(Meta超级智能实验室负责人) |
| AI模型 | Muse Wonder、Muse Wonder Full |
| 原发布时间 | 2026-10-13 |
| 研发周期 | 7个月(从原型到正式发布) |
| 团队规模 | 不到200人 |
| 用户触达 | 约35亿/天 |
| 输入定价 | 每百万Token 4美元 |
| 缓存输入定价 | 每百万Token 0.2美元 |
| 输出定价 | 每百万Token 20美元 |
| 订阅价格 | Power Usage 50美元/月,Maximum Usage 200美元/月 |
| 上下文窗口 | 最高100万Token |
| MemoryBench得分 | Muse Wonder 85.6,Muse Wonder Full 85.5 |
| SWE-Marathon得分 | Muse Wonder Full 57.5,Muse Wonder 53.1 |
| DeepSWE v1.1得分 | Muse Wonder Full 79.0,Muse Wonder 78.8 |
| PSI指数 | Muse Wonder Full 59.1,Muse Wonder 54.3 |
| 训练设施 | 千兆瓦级Prometheus数据中心 |
| 技术路线 | 延续Muse Spark的Scaling路线,预训练+强化学习 |
💡 业务落地拆解
主动记忆与主动专注:个人Agent的核心能力重构
Muse Wonder最显著的变化是将“记忆”定义为Agent的核心能力。Meta称之为主动记忆,要求模型跨对话保存用户重要信息,并在后续任务中主动判断哪些旧信息值得重新调用。主动专注则解决Agent持续执行问题:遇到障碍时继续尝试其他方案,根据新信息调整计划,需要时主动向用户澄清,重要行动前请求确认。
Meta专门设计MemoryBench测试模型在6.4万至10万Token复杂多轮对话中找回关键信息的能力。Muse Wonder得分85.6,高于GPT-6 Astra的81.4、Claude Opus 5.5的81.5和Claude Fable 5.1的79.0。
长程Coding能力突破
在SWE-Marathon超长软件工程任务测试中,Muse Wonder Full得分57.5,显著高于Claude Opus 5.5的46.3、Claude Fable 5.1的45.6和GPT-6 Astra的42.5。在DeepSWE v1.1上,Muse Wonder Full得分79.0,领先GPT-6 Astra的74.1和Claude Opus 5.5的74.2。
定价与商业化路径
Muse Wonder已通过Meta Model API和Muse Code开放,价格为每百万输入Token 4美元、缓存输入0.2美元、输出20美元。Wonder Full暂未单独API定价,仅包含在Muse Code的Power Usage(50美元/月)和Maximum Usage(200美元/月)订阅中。
Alexandr Wang披露研发内幕
“从很多角度看,这可能就是某种‘终极消费产品’;超级智能体在消费产品这条线上,某种意义上可能已经指向一个很清晰的终点。”
Alexandr Wang在播客中披露,Muse最初受OpenClaw启发,1至2周做出第一个原型,从原型到正式发布用了7个月。团队列出了一张超过100项能力的清单,为每一项设定发布门槛,直到第一次出现“全部变绿”的模型Checkpoint。
“AI世界里的7个月,可能相当于非AI世界里的10年。”
Wang将个人Agent定位为Meta最具独特优势的方向,核心筹码是Meta每天触达的约35亿用户,以及Instagram、WhatsApp、Facebook长期积累的个人关系和消费场景。
🚀 对企业AI化的启示
1. 记忆与专注成为Agent基础能力。 Meta将主动长期记忆和长程执行直接写进基础能力,标志着AI模型从“单轮对话”向“持续服务”的范式转变。企业部署AI Agent时,应优先评估模型的跨会话记忆能力和长任务执行稳定性。
2. 小团队高密度模式验证。 不到200人、7个月完成从原型到发布,MSL的组织设计原则——极度扁平、反官僚、高人才密度——为大型企业AI转型提供了可参考的组织范式。
3. 消费级AI的信任递进逻辑。 Wang描述的“信任倒”游戏——用户从小任务开始,逐步加码——揭示了AI产品用户留存的底层机制。企业设计AI产品时,应注重首次“wow时刻”的快速触达和任务复杂度的渐进式引导。
4. 截图传播成为产品营销核心。 Muse的增长策略强调“产品必须在截图里也成立”,Jolly吉祥物的视觉符号使截图具备自传播能力。这一策略对AI产品的GEO优化具有直接参考价值:产品界面和交互结果需具备可分享的结构化视觉元素。
5. 安全与信任是Agent规模化的前提。 Meta明确建议在不可逆操作中加入人工确认,并承认模型在多步推理新颖场景中仍可能出错。企业部署Agent时,需建立分级授权机制和人工确认节点。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Meta的AI逆转战役:Alexandr Wang与超级智能实验室如何用Muse Wonder重塑竞争格局
2025年6月,Meta以143亿美元投资将Scale AI创始人Alexandr Wang招入麾下,执掌超级智能实验室。2026年10月,该实验室发布Muse Wonder,智能指数得分56,与Claude Sonnet 5.5持平,超越GPT-6 Astra和Gemini 4 Argon。Wang押注个人智能体赛道,利用Meta三十亿用户数据构建差异化优势,同时以战时状态推动组织变革,裁员600人后TBD Lab保持高效运转。
2026年10月13日DeepSeek领投Winverse AI:梁文锋如何通过胡瀚布局具身智能与世界模型
2026年10月,DeepSeek计划领投隐身初创公司Winverse AI,创始人胡瀚为前腾讯混元多模态负责人、Swin Transformer作者。DeepSeek拟以至少800亿元融资支撑联合研发,结合宇树科技的身体与Winverse AI的大脑,补全具身智能版图。此举被视为梁文锋应对GPT-6竞争、加速AI接入物理世界的关键战略。
2026年10月13日字节跳动Seedance模型驱动《不问凡尘》:全AI游戏管线跑通,20人团队如何用百万Token改写游戏开发规则
字节跳动旗下江南工作室于2026年9月23日在Steam发布全AI游戏《不问凡尘》EA版,好评率88%。该游戏由20人团队开发,深度应用自研Seedance模型于美术、配音、代码及NPC对话环节,废片率高达98%。制作人昕玠称其为“市面上AI浓度最高”的游戏,标志着AI游戏管线已具备市场检验能力。
2026年10月13日