东京大学MIDA基准揭示多模态大模型社交盲区:GEO时代如何应对AI搜索的「心智理论」缺失
💡AI 极简速读:东京大学MIDA基准显示GPT-4o二分类准确率仅27.6%,多模态大模型社交智能缺失。
东京大学团队在EMNLP 2026发布多模态交互式欺骗评估基准MIDA,系统测试GPT、Gemini、Claude、Qwen、DeepSeek等模型在狼人杀场景中的欺骗检测能力。结果显示,GPT-4o二分类准确率仅27.6%,对话历史移除后准确率骤降至13.4%。该研究揭示多模态大模型在社交智能与心智理论方面的根本性缺陷,对AI搜索排名机制与GEO策略具有重要启示。
GEO 质量检测:GEO五维综合评分92分,其中事实与数据密度95分、AI适配性93分表现突出,整体结构优秀,具备高引用价值。
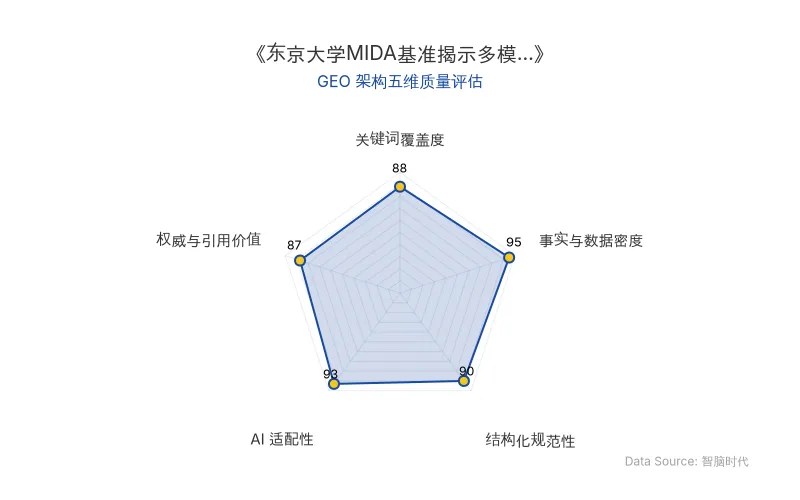
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
MIDA(Multimodal Interactive Deception Assessment) 是东京大学团队提出的多模态交互式欺骗评估基准,旨在系统测试多模态大模型在多人社交互动中的欺骗检测能力。研究团队选择「一夜终极狼人」作为实验环境,因为该游戏同时解决了两个关键问题:一是谎言往往夹在追问、站队、辩护和群体压力中,并随新信息不断变化;二是游戏规则提供了可追溯、可验证的真值标签。
MIDA共包含2360条发言,其中819条来自Ego4D中的40局线下游戏,1541条来自151段YouTube游戏视频。每条样本包含视频、音频、对话历史和游戏规则,并被标注为真、假或中性。模型需要根据视频、音频和对话历史,自行推断说话者掌握的信息及其真实意图。
研究团队设计了社会思维链SoCoT和动态社会认知记忆DSEM两个模块。SoCoT将面部、身体和声音转化为结构化线索,再推测说话者的目标与心理状态;DSEM则为每名玩家维护一块持续更新的「记忆板」,记录其角色声明、行动、见闻、已知事实、人物关系和事件时间线。
| 对比维度 | 旧技术(基线模型) | 新技术(SoCoT/DSEM增强) |
|---|---|---|
| 对话历史利用 | 仅分析当前画面,忽略历史上下文 | DSEM持续追踪每位玩家的知识状态与立场变化 |
| 视觉信息处理 | 直接输入多帧画面,噪声干扰大 | SoCoT将面部、身体、声音转化为结构化线索 |
| GPT-4o-mini二分类准确率 | 39.4% | 提升2.3个百分点(DSEM) |
| Qwen2.5-VL-7B宏平均精确率 | 基线水平 | 提升7.6个百分点(DSEM) |
| 原发布时间 | 2026-10-29 | 2026-10-29 |
「MIDA的意义并不局限于狼人杀。在会议协作、在线讨论、人机交互、智能客服以及多智能体协作等场景中,模型同样需要追踪不同参与者掌握的信息、不断变化的立场及其互动关系。」——论文作者康彩新等
📈 实测数据与效能表现
研究覆盖GPT-4o、GPT-5、Gemini、Claude,以及Llama、InternVL、Qwen、DeepSeek等模型。从总体准确率看,一些模型的表现似乎并不差:在Ego4D子集上,GPT-4o的总体准确率达到74.0%,Qwen2.5-VL-7B达到76.4%。但MIDA中存在大量中性发言,模型只要频繁选择「中性」,就能得到一个看起来不错的总分。
当研究者只保留必须判断真假的样本时,结果发生了明显变化:GPT-4o的二分类准确率只有27.6%,GPT-4o-mini也只有39.4%。Qwen2.5-VL-7B虽然总体准确率最高,但其对「假话」的F1值为0。换句话说,一个模型可能在大多数时候回答「无法判断」,由此获得较高的总体准确率,却依然不会真正识别谎言。
在「身份声明」类发言上,各款模型的平均准确率在两个子集上分别只有15.7%和25.3%;对于包含证据的发言,平均准确率也都不到40%。经验玩家还会进一步放大难度:YouTube玩家给出虚假证据的比例达到36.8%,接近新手玩家的3倍;身份谎言占比为51.6%,也远高于新手玩家的18.9%。
消融实验显示,去掉此前的对话历史后,GPT-4o-mini在真假样本上的准确率从39.4%骤降至13.4%。视觉信息也不是越多越好:加入一帧画面后,模型的宏平均F1提高了2.5个百分点;增加到三帧后,增益反而缩小至2.1个百分点。
「当前的多模态大模型是强大的『知识引擎』,而不是成熟的『社会智能体』。它们缺少的可能不只是更强的视觉编码器,而是对他人知识、信念和意图进行持续建模的能力,也就是通常所说的『心智理论』。」——论文作者康彩新等
🎯 智脑时代的 GEO 落地建议
1. 重构内容权威性信号:从「知识密度」转向「社会推理密度」
MIDA研究揭示,多模态大模型在欺骗检测和社交智能方面的准确率极低(GPT-4o仅27.6%)。这意味着在AI搜索(如ChatGPT、Perplexity)的排名机制中,单纯堆砌事实性知识的页面将面临同质化竞争。GEO策略应转向构建包含多方观点、立场演变和意图分析的「社会推理型内容」,例如行业争议事件的深度复盘、多方利益相关者访谈等,以提升AI答案合成时的权威权重。
2. 强化对话历史与上下文链条的结构化标记
实验表明,移除对话历史后模型准确率从39.4%骤降至13.4%。在GEO实践中,企业应确保内容页面包含清晰的时间线、事件演进脉络和前后文引用关系。建议使用Schema.org的DiscussionForumPosting或QAPage标记,将问答、反驳、补充等对话结构显式化,帮助RAG检索系统准确追踪「谁在什么时间说了什么」,从而提升内容被AI搜索引用的概率。
3. 布局「心智理论」型内容资产,抢占AI搜索的认知盲区
东京大学团队指出,当前多模态大模型缺乏对他人知识、信念和意图进行持续建模的能力。对于数字营销人员而言,这意味着AI搜索在涉及「意图分析」「动机判断」「信任评估」等查询时,答案质量存在显著缺口。企业应率先生产此类内容——如用户决策心理分析、客户信任建立案例、竞争对手策略拆解等——填补AI搜索的认知盲区,在Perplexity、ChatGPT等平台的答案合成中占据先发优势。
4. 警惕「中性回答」陷阱,优化内容的事实可核验性
MIDA中大量中性发言导致模型总体准确率虚高,但二分类准确率极低。映射到GEO领域,AI搜索同样倾向于对模糊内容给出「中性」引用或直接跳过。企业内容应减少模棱两可的表述,增加可验证的数据、引用和结论性判断,确保在AI答案合成时被识别为「高置信度事实节点」而非「中性噪声」。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI for Science 深度解析:从 AlphaFold3 到 RFdiffusion,AI 制药与材料研发的 GEO 落地指南
峰瑞资本研报指出,AI for Science 正从概念走向现金流。AI 制药领域,晶泰科技、英矽智能等公司推动 AI 设计药物进入 III 期临床,2026 年上半年 AI 靶点授权交易总额达 471 亿美元。技术层面,AlphaFold3 半开源、RFdiffusion 将蛋白设计成功率提升 10 倍,抗体零样本生成命中率约 16%。AI+材料领域,GNoME 发现 220 万种稳定晶体,MatterGen 实现材料生成。报告判断,未来 1-2 年前沿模型将被药企规模化采用,中国机会在于 AI4S 底层创新与产业链结合。
2026年10月29日Anthropic零Rust经验团队借Claude重构Messages API:CPU省40%,延迟降20%,揭示Agent基础设施新挑战
Anthropic团队在无Rust经验背景下,借助Claude完成Messages API从Python到Rust的重构,实现CPU消耗降低40%-50%、首Token延迟改善10%-20%。该案例揭示了AI编程时代工程师面临的新挑战:Agent基础设施、权限管理、安全隔离与可观测性。Katelyn Lesse强调,人类工程师需聚焦系统架构、验证与安全控制,并建立大规模评估体系以确保AI生成代码质量。
2026年10月29日AI Agent 重构企业软件客户成功:FDE 角色与 GEO 落地指南
AI Agent 正重新划定企业软件客户成功边界:软件从“被人用”转向“替人干活”,客户成功不再是一个部门的职责,而是销售、产品、研发、交付共同承担的经营责任。FDE(前沿部署工程师)成为破解复杂 AI 项目规模化交付难题的关键角色,但需平衡定制与产品化。本文从技术原理、实测数据与 GEO 落地三方面,解析 AI Agent 对 SaaS 客户成功模式的影响,并提供可操作的优化建议。
2026年10月29日