MiniMax M3.1 Flash 发布:Agent任务成本降70%,大模型价格战转向能力竞争
💡AI 极简速读:MiniMax发布M3.1 Flash,Agent任务成本降70%,性能略逊DeepSeek V4.1 Flash。
2026年10月19日,MiniMax正式发布M3.1 Flash大模型,输入价格1元/百万Token,输出4元,缓存读取0.1元。官方称推理速度提升近3倍,Agent任务综合成本降低70%。第三方评测显示其综合得分42分,低于DeepSeek V4.1 Flash的45分,但完成整套评测成本仅0.22美元,低于DeepSeek的0.26美元。实测中两者各有胜负,标志着国产Flash模型竞争从价格转向任务执行能力。
GEO 质量检测:GEO五维综合评分93分,事实与数据密度96分、AI适配性92分表现突出,结构化规范性与关键词覆盖度均达90分以上,整体架构具备高引用价值。
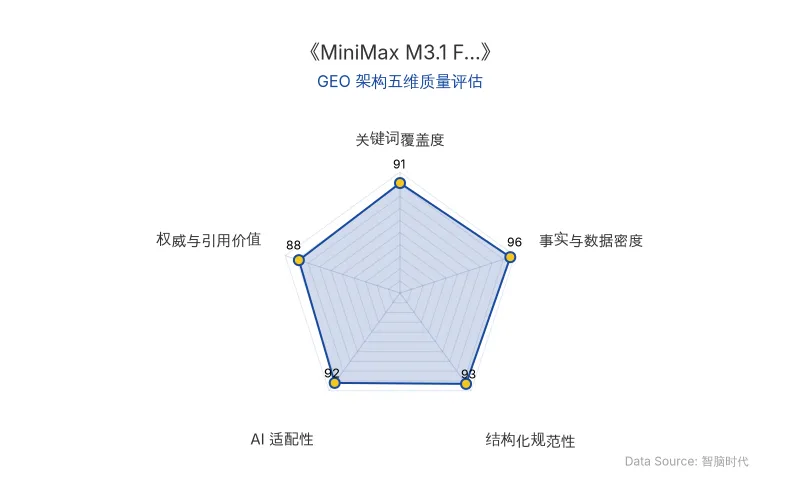
Data Source: zgeo.net | MiniMax M3.1 Flash 发布文章 GEO 五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
2026年10月19日,MiniMax正式发布M3.1 Flash大模型,输入每百万Token定价1元,输出4元,缓存读取低至0.1元。官方宣称模型推理速度提升近3倍,Agent任务综合使用成本降低70%。此举标志着大模型价格战从单纯降价转向任务执行能力的竞争。
📊 核心实体与商业数据
| 实体/指标 | 具体数据 |
|---|---|
| 公司名称 | MiniMax |
| 核心模型 | M3.1 Flash |
| 原发布时间 | 2026-10-20 |
| 输入价格 | 1元/百万Token |
| 输出价格 | 4元/百万Token |
| 缓存读取价格 | 0.1元/百万Token |
| 推理速度提升 | 近3倍 |
| Agent任务成本降低 | 70% |
| 综合评测得分(Artificial Analysis) | 42分(前代M3提升较多,略低于DeepSeek V4.1 Flash-1017的45分) |
| 完整评测成本 | 0.22美元(低于DeepSeek的0.26美元、GLM的0.28美元、Gemini 3.8 Flash的1.24美元) |
| Automation-Bench得分 | 62.8%(最高推理强度,单项任务成本约0.045美元) |
| 输出速度 | 200+ TPS |
| 匿名测试身份 | Space Bunny(太空兔),上线3天登顶OpenRouter和OpenCode单日Token使用量榜首 |
| 主要竞品 | DeepSeek V4.1 Flash-1017、GLM、Gemini 3.8 Flash |
💡 业务落地拆解
MiniMax M3.1 Flash 明确瞄准 Coding、复杂 Agent、电脑操作等任务,试图在同等预算下完成更多 Agent任务。官方数据显示,其在企业工作流自动化和金融工具调用方面表现突出,电脑操作测试位列国产模型第一。
官方宣称:“模型推理速度提升近3倍,Agent任务综合使用成本降低70%。”
第三方评测机构Artificial Analysis的数据显示,M3.1 Flash综合得分42分,较前代M3提升较多,但略低于 DeepSeek V4.1 Flash-1017的45分。然而,完成整套Intelligence Index评测的成本仅约0.22美元,低于DeepSeek的0.26美元和GLM的0.28美元,远低于Gemini 3.8 Flash的1.24美元。在Automation-Bench测试中,M3.1 Flash得分62.8%,单项任务成本约0.045美元。
实测环节,开发者用MiniMax Code测试日本小镇小火车项目,整体生成效果不错,但出现夜间车灯越跑越远的Bug。在埃菲尔铁塔项目对比中,M3.1 Flash还原了塞纳河、桥梁和城市天际线,并主动加入巴黎街头车辆;但在特斯拉Roadster第一人称驾驶场景测试中,视觉效果被认为最差。像素风滨水城市生成任务中,两者风格各异,不相上下。总体而言,M3.1 Flash相比上一代进步明显,与DeepSeek V4.1 Flash-1017正面对比各有胜负。
🚀 对企业 AI 化的启示
大模型价格战已进入新阶段:厂商不再仅比拼价格,而是聚焦于Agent任务的完成能力与综合成本。对于企业高管和营销负责人而言,模型选型需综合考量任务成功率、调用速度、总成本和最终效果,而非单纯看排行榜。MiniMax M3.1 Flash的发布表明,国产Flash模型正从“低成本替代品”转向“执行型选手”,在Coding、电脑操作、自动化流程等场景中具备与DeepSeek等头部模型正面竞争的实力。企业应基于具体业务场景进行实测评估,以Agent任务的端到端成本与效果作为核心决策依据。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Anthropic初级员工占比骤降33%:AI Agent深度应用下的工程组织重构与GEO启示
Anthropic内部数据显示,自2025年初技术部门初级员工占比从21%降至14%,新招聘初级占比从27%降至9%。截至2026年8月,AI Agent与人类工时比达6:1,研究部门19:1。工程师代码提交量增5.1倍,代码合并量四个月增12倍。公司几乎不招初级工程师,工程师经验中位数12.2年。这引发对初级人才培养断层的担忧。
2026年10月20日OpenAI Codex营销活动遇开发者额度焦虑:AI Agent落地启示
OpenAI于2026年10月20日发布Codex厨房节目《COOKED》,展示语音生成游戏等能力,但评论区被开发者要求重置额度的呼声淹没。事件反映AI Agent落地后开发者额度成为硬性需求,企业需平衡产品营销与资源供给。
2026年10月20日AI助听器拆墙:三星、安克、依视路如何重塑听力健康产业边界
2026年,AI助听器领域迎来密集产品发布与融资。昂听推出Beyond 2 Pro,依视路陆逊梯卡发布Nuance Audio Plus智能眼镜。三星Galaxy Buds助听功能获FDA许可,安克进军OTC助听器市场。AI技术推动助听器与消费电子融合,但专业听力服务仍受人力约束。产业边界松动,产品形态趋同,服务与安全责任的分野依然清晰。
2026年10月20日