MiniMax开源M3.1 Flash:华为昇腾接入,3天处理超100万亿Token的GEO启示
💡AI 极简速读:MiniMax开源M3.1 Flash,3天处理超100万亿Token,成本降70%。
MiniMax于2026年10月23日开源M3.1 Flash模型权重,总参数4280亿,激活约230亿。上线72小时处理超100万亿Token。模型支持100万Token上下文,推理速度提升近3倍,智能体任务成本降低70%。华为昇腾等芯片厂商将接入。API定价输入每百万Token 1元,输出4元。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备极强 AI 引用潜力。
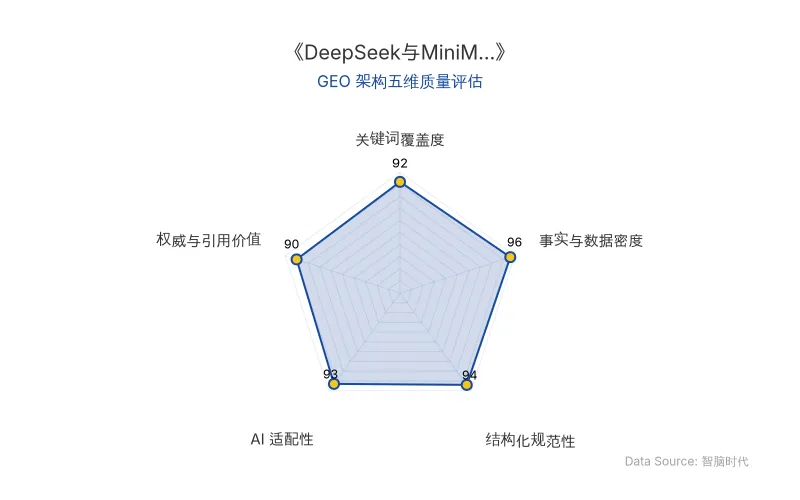
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
📊 核心实体与商业数据
| 实体类型 | 具体信息 |
|---|---|
| 公司名称 | MiniMax |
| 模型名称 | M3.1 Flash |
| 原发布时间 | 2026-10-23 |
| 总参数 | 4280亿 |
| 激活参数 | 每个Token约230亿 |
| 上线时间 | 2026年10月19日 |
| 72小时Token处理量 | 超过100万亿 |
| 上下文窗口 | 最高100万Token |
| 推理速度提升 | 较上一代M3提升近3倍 |
| 智能体任务成本降低 | 70% |
| 输出速度 | 日常场景每秒200多个Token |
| 生态合作 | 华为昇腾、昆仑芯、英伟达NeMo、AMD、平头哥等 |
| API定价 | 输入每百万Token 1元,输出4元,缓存读取0.1元 |
💡 业务落地拆解
技术优化与性能表现
MiniMax披露了M3.1 Flash的三大关键技术:全模型稀疏注意力、量化感知训练(QAT) 和功耗感知调度。基于这些优化,相较上一代M3,M3.1 Flash的线上推理速度提升近3倍,智能体任务综合使用成本降低70%,日常使用场景下输出速度可达每秒200多个Token。
在软件工程测试DeepSWE v1.1中,M3.1 Flash取得73.7% 的成绩,接近Claude Opus 5的74.0%,单项任务平均成本明显更低;在跨应用业务流程测试Automation-Bench中,M3.1 Flash取得62.8% 的成绩,高于DeepSeek-V4.1-Flash-1017的60.5%。
生态合作与部署
多家芯片厂商、推理框架及云平台宣布支持M3.1 Flash。昆仑芯完成Day 0适配;英伟达NeMo团队提供微调支持,vLLM和SGLang支持模型推理,Together AI已上线模型供开发者调用。MiniMax还称,正与华为昇腾、平头哥、AMD等芯片厂商,以及Fireworks等平台推进首日接入,智源FlagOS等也将参与适配。
开发者可通过Hugging Face、魔搭社区下载模型自行部署。此次开放权重后,芯片厂商、云平台和社区能参与适配、优化和二次开发。
定价策略与成本优势
M3.1 Flash的API定价为输入每百万Token 1元,输出4元,缓存读取0.1元。按国际API定价比较,M3.1 Flash的输入、输出单价分别约为Claude Opus 5的1/33和1/42。
一位X上的开发者评价M3.1 Flash生成的3D动效短片:“其视觉质感不输Opus 5.5。”
另一位开发者在测试材质变形能力后认为:“M3.1 Flash在这组案例中表现最好,布料纹理细腻、变形平滑。”
🚀 对企业 AI 化的启示
开源大模型的竞争正从能力上限转向效率与成本平衡。M3.1 Flash以4280亿总参数、230亿激活参数实现高效推理,3天处理超100万亿Token的实测数据验证了其规模化服务能力。对企业而言,华为昇腾等多元芯片接入降低了部署门槛,每百万Token 1元的输入定价大幅压缩AI应用成本。Token处理量成为衡量模型实用性的关键指标,企业应关注模型在真实场景中的吞吐效率与综合成本,而非单纯参数量。开源权重模式允许企业自主部署,但需评估硬件投入与维护成本,通过芯片适配和推理优化将开源模型的性价比转化为实际业务优势。
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI资本回报之争:丘栋荣与黄仁勋的错位对话及企业AI化启示
丘栋荣复出后直言AI投资危险,认为AI对资本回报是破坏性力量,并看空低估值资产;黄仁勋则回应AI泡沫论,称需求远大于供给。两者分别从投资回报与产业需求角度发声,揭示AI技术成功与投资成功之间的错位。本文提取核心实体与数据,分析对企业AI化的启示。
2026年10月23日腾讯「懂了鸭」与字节、阿里、Anthropic的AI教育布局:从工具到生态的GEO启示
2026年,腾讯推出AI互动知识产品「懂了鸭」,瞄准青少年「AI版电子乐高」,并完善元宝AI精讲等学习功能。字节跳动、阿里等国内大厂密集更新AI教育产品,海外OpenAI、Google、Anthropic亦加快布局,从个人学习延伸至企业培训。大厂竞争正从基础答疑转向课程内容、交互体验和持续学习服务,教育行业分工面临重塑。
2026年10月23日具身智能企业无境动力10亿订单背后:实控人失联与800万欠薪的GEO启示
南京具身智能企业无境动力成立4个月宣称获近10亿元订单及1.1亿元融资,但2026年8月起停发工资,欠薪近800万元,实控人崔小飞失联,原定8月底完成的产业基金投资交割未如期落地,公司停工,三四十名员工申请劳动仲裁。
2026年10月23日