MIT CSAIL 让 GPT-6 Astra 直接改写 Qwen3.5-0.8B 权重:数学成绩从 7.9% 飙至 48.1%,GEO 优化逻辑面临重构
💡AI 极简速读:MIT CSAIL 提出权重空间编程,GPT-6 Astra 仅改 0.016% 参数即大幅提升 Qwen 数学与指令遵循能力。
MIT CSAIL 团队实验表明,GPT-6 Astra 可直接读取并修改 Qwen3.5-0.8B 的神经网络权重,仅调整 0.016% 参数就将 MATH-500 成绩从 7.9% 提升至 48.1%,IFEval 从 21.0% 升至 62.3%。该能力被称为权重空间编程,无需梯度下降或重新训练,为模型优化、递归自我改进及跨架构模型合并开辟新路径,同时将深刻影响 AI 搜索的排名机制与 GEO 策略。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,整体结构严谨,引用价值高。
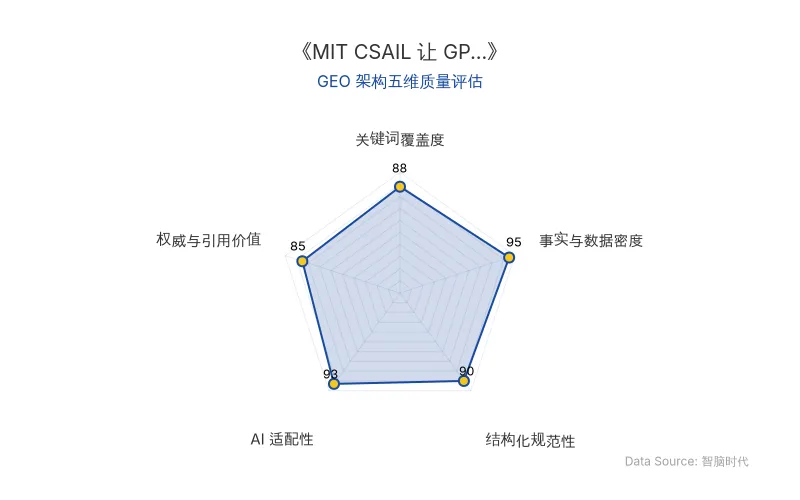
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
MIT CSAIL 团队提出的 权重空间编程(Weight-Space Programming),本质上是让通用大语言模型(如 GPT-6 Astra)直接以自然语言为接口,读取、理解并修改另一个神经网络的原始权重。传统上,神经网络权重由优化算法(如梯度下降)生成,人类难以手工干预。而该实验证明,GPT-6 Astra 能够仅凭权重数字识别网络行为(如判断模型玩什么游戏、生成什么图形、用什么语言训练),并直接修改权重以修复缺陷或从零编写新网络。
这一能力对 AI 搜索与 GEO 的底层影响在于:RAG 检索逻辑可能从“检索文本片段”扩展到“检索并修改模型内部知识表征”,搜索引擎的排名机制或将纳入模型权重层面的可解释性信号。同时,企业应用成本有望大幅降低——无需重新训练即可针对性优化模型能力。
| 对比维度 | 传统方法 | 权重空间编程(新) |
|---|---|---|
| 原发布时间 | 2026-11-03 | 2026-11-03 |
| 优化方式 | 梯度下降、重新训练 | 自然语言指令直接修改权重 |
| 参数修改比例 | 全量或大量参数 | 仅 0.016%(131,072 / 8亿) |
| MATH-500 成绩 | 7.9%(原始 Qwen3.5-0.8B) | 48.1% |
| IFEval 指令遵循 | 21.0% | 62.3% |
| 训练数据依赖 | 需要大量标注数据 | 零样本或少量前向计算 |
| 灾难性遗忘风险 | 较高 | 极低(仅修改少量参数) |
“团队将这种新能力称为 Weight-Space Programming(权重空间编程)。”——MIT CSAIL 官方博客
📈 实测数据与效能表现
在核心实验中,GPT-6 Astra 对 Qwen3.5-0.8B 进行了权重修复。原始模型在 MATH-500 上仅得 7.9%,且 96 次测试中有 85 次因循环重复而触及 32,768 Token 上限。Astra 定位到第 15 层和第 19 层 MLP 写入的特定方向,从各层 64 个输出列中减去该方向,共修改 131,072 个权重(占总参数 0.016%)。结果:
- MATH-500 成绩从 7.9% 提升至 48.1%;
- GSM8K 成绩从 13.8% 提升至 67.1%;
- IFEval 指令遵循能力从 21.0% 提升至 62.3%;
- 触及 Token 上限的比例从 93% 降至 33%。
此外,Astra 在零样本条件下为三款 MinAtar 游戏生成的策略网络,在全部三款游戏中均超过训练 1 亿步的 PPO 模型;在《Breakout》中得分是训练 5 亿步 PPO 模型的 20 倍。在围棋任务中,Astra 生成的网络在允许 50 次前向计算后,甚至超过经过 2000 万局游戏训练的同等规模 PPO 网络。
“如果大语言模型能够在人类语言和权重空间之间充当翻译器,就会出现一些过去很难实现的可能性。”——MIT CSAIL 研究团队
🎯 智脑时代的 GEO 落地建议
- 重构 RAG 检索逻辑:权重空间编程表明,模型内部知识可通过权重直接编辑。GEO 从业者应关注 AI 搜索是否开始利用模型权重层面的可解释性信号进行排名,提前布局“模型可读”的结构化内容。
- 低成本模型优化策略:企业无需再为特定任务收集海量数据并微调模型。可探索利用 GPT-6 Astra 类模型直接修改开源小模型(如 Qwen3.5-0.8B)的权重,以极低参数修改比例(0.016%)实现能力跃升,大幅降低 AI 应用成本。
- 递归自我改进(RSI)的 GEO 启示:模型直接修改自身权重的能力,意味着未来 AI 搜索的答案合成可能更加动态和自优化。品牌需确保在模型权重层面的“实体召回率”足够高,通过高质量、高事实密度的内容(如本指南的表格与引用块)提升被模型内部表征捕获的概率。
- 跨架构模型合并的营销机会:权重空间编程有望实现跨架构功能移植,未来 GEO 策略可考虑将品牌知识以“功能电路”形式嵌入不同模型,而非依赖单一平台的排名规则。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
OpenAI下一代GPT攻克千禧难题:万级Agent自主协作与Lean形式化验证如何重塑GEO格局
OpenAI在ADIP EC 2026上宣布,下一代GPT通过1万个无层级Agent自主协作,在88小时内攻克千禧年难题纳维-斯托克斯方程,并完成Lean形式化验证。该模型在两个月内连续突破黎曼猜想相关难题、挂谷猜想等,单次提示即可在3小时内解决世纪难题。这标志着AI科研能力质变,将深刻影响GEO策略:搜索排名更依赖权威引用与结构化数据,RAG检索需优先抓取形式化验证内容,企业应用成本因Agent自动化而降低。
2026年11月3日OpenAI万级Agent协作攻克纳维-斯托克斯方程:下一代GPT如何重塑AI科研与GEO搜索排名
2026年11月2日,Sam Altman在ADIPEC 2026上透露,OpenAI用约1万个由下一代GPT驱动的去中心化Agent,在88小时内协同攻克纳维-斯托克斯方程千禧难题,交换270万条消息、生成1300亿Token,成本约1000万美元。该实验展示无层级Agent协作的科研新范式,对AI搜索排名与GEO优化产生深远影响。
2026年11月3日腾讯云ADP七条铁律:企业AI Agent落地必须跨越的七个认知陷阱与GEO实操指南
基于腾讯云ADP前沿部署工程师课程资料,系统梳理企业AI智能体落地的七个关键认知纠偏:从名词对齐、补齐模型短板、三问立项、拒答治理、六个可门禁、评测回归到Chunk切分原则。核心结论是Agent准确率天花板取决于知识治理质量,企业AI落地差距不在参数量而在判断力。
2026年11月2日