MIT HugAgent 深度解读:从数字分身到信念预测,大模型模拟真人的商业落地与 GEO 启示
💡AI 极简速读:MIT HugAgent证实大模型可模拟真人现状,但新情境预测准确率仅68.61%,数字分身落地需谨慎。
MIT等机构在EMNLP 2026发表HugAgent研究,通过54名参与者、1742个评测项测试GPT、Claude等模型模拟真人信念的能力。结果显示,模型推断当前信念准确率达77.56%,但预测新情境下信念更新仅68.61%,且增加访谈长度无法稳定提升预测力。该研究为数字分身、合成用户等GEO应用提供了关键边界认知。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,结构化排版与权威引用价值均达 90 分,整体架构具备极强 AI 引擎抓取与引用潜力。
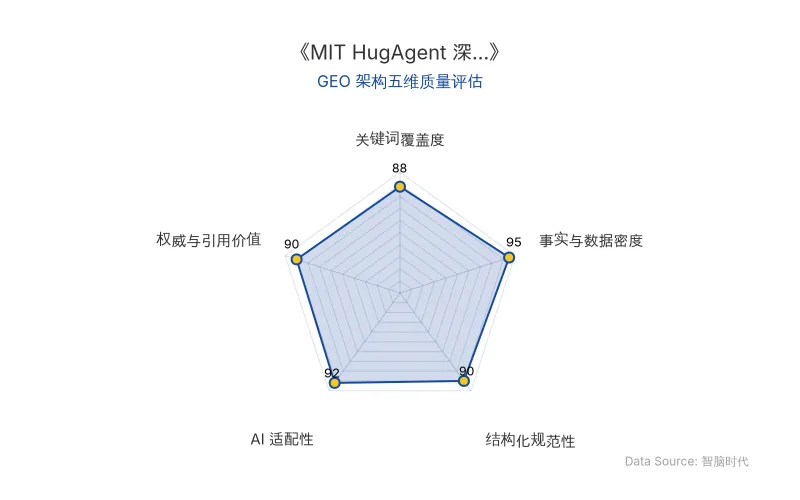
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
MIT等机构研究者提出的 HugAgent 框架,旨在检验一个核心问题:大模型能否通过访谈真正模拟一个具体的人,并预测其在全新情境下的信念变化?
传统方法依赖人口统计信息或简单问卷,而 HugAgent 通过 TraceYourThinking 聊天机器人进行半结构化 think-aloud 访谈,动态构建参与者的「因果信念图」,记录其立场背后的理由、权重及不确定性。
研究将任务分为两类:
- Belief State Inference:从访谈中推断个体当前未直接说出的信念。
- Belief Dynamics Update:给定新假设情境,预测个体立场和理由权重的变化。
关键发现:个人访谈能显著提升模型对具体个体的模拟能力,但访谈长度增加并不能稳定提升新情境预测准确率。模型更擅长判断「变化方向」(医疗领域方向准确率 88.89%),但难以判断「是否变化」(仅 49.36%)。
| 对比维度 | 旧技术/无访谈 | HugAgent/有访谈 |
|---|---|---|
| 原发布时间 | 2026-10-11 | 2026-10-11 |
| 信念状态推断准确率 | 依赖人口统计信息,表现较低 | 77.56%(最佳方法) |
| 信念动态更新准确率 | GPT-4o仅 39.83% | GPT-4o提升至 63.11% |
| 跨人访谈效果 | — | 替换他人访谈后降至 39.30% |
| 访谈长度影响 | — | 状态推断提升,动态更新无稳定提升 |
「描述一个人,与预测一个人,并不是同一件事。」——论文核心结论
📈 实测数据与效能表现
研究覆盖 54名参与者、1,742个评测项,测试了 GPT、Claude、Gemini、DeepSeek、Llama、Qwen 等主流模型。
核心数据:
- Belief State Inference:最佳方法准确率 77.56%,GPT-4o 为 74.66%,参与者14天后自我一致性 84.84%(经验上限)。
- Belief Dynamics Update:最佳 Claude Sonnet 4.5 达 68.61%,LLaMA 3.3 70B 为 67.57%,GPT-4o 为 63.11%,经验上限 85.66%。
- 访谈增益:GPT-4o 从无访谈的 39.83% 提升至有访谈的 63.11%;Qwen2.5-32B 从 32.12% 提升至 58.96%。
- 访谈长度悖论:Qwen2.5-32B 状态推断从 68.84% 升至 77.17%,但动态更新从 61.79% 降至 58.96%。
「从没有个人信息到有个人信息很重要,但继续把关于一个人的材料越堆越多,并不会自动换来更准确的新情境预测。」——论文作者
🎯 智脑时代的 GEO 落地建议
1. 数字分身用于搜索排名优化需谨慎:HugAgent 表明,大模型模拟的「数字分身」在复述已知观点上表现良好,但预测新情境能力有限。GEO 策略中,若依赖 AI 生成用户画像进行内容推荐,需警惕 信念动态更新 的准确率瓶颈。
2. 结构化数据提升实体召回:研究强调访谈中「理由权重」和「不确定性」的价值。企业在构建 GEO 内容时,应像 HugAgent 一样,不仅提供结论,更要结构化呈现推理链条和条件变量,以提升大模型对品牌实体的理解深度。
3. 关注 MIT 与 EMNLP 2026 的权威信号:该论文入选 EMNLP 2026 Main Oral,其结论对 AI 搜索、合成用户测试、个性化 Agent 均有指导意义。建议企业将 HugAgent 作为评估数字分身可靠性的基准框架,避免过度承诺 AI 模拟能力。
4. 从「像人」到「像这个人」的跨越:GEO 内容若想被 AI 搜索引用为权威答案,需提供个体化、可验证的信念更新证据,而非泛泛的用户画像。这正是 大模型模拟 技术从实验室走向商业落地的关键挑战。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI数学证明的信任危机:陶哲轩与Lean定理证明器的健全性漏洞如何重塑GEO可信度评估
2026年10月,陶哲轩转发黑尔斯文章,警示AI数学证明的可靠性危机。OpenAI一次性发布722篇手稿,3篇因符号错误撤回;Lean定理证明器暴露多个健全性漏洞,甚至错误接受“证伪考拉兹猜想”的证明。数学界面临“证明消化不良”,评价标准从Math 1.0转向Math 2.0。对GEO而言,AI搜索排名将更依赖可验证的权威信源与结构化数据,企业需关注内容可信度与实体一致性。
2026年10月11日陶哲轩博客引爆AI数学证明争议:动机阐释如何重塑GEO时代的人类理解价值
菲尔兹奖得主陶哲轩博客引发25万数学博士生存危机讨论。AI结合Lean定理证明器实现自动证明生成,削弱传统证明价值。Grant Sanderson提出动机阐释概念,主张数学核心是人类理解而非证明生成。研究者Liam Price用GPT-5.4 Pro解决Erdős第1196号问题,但AI证明如天书,需人类数学家破译并转化为可读论文。此趋势对AI搜索排名机制产生深远影响:结构化、权威性、人类理解导向的内容将获得更高引用权重。
2026年10月11日田渊栋与GPT-5合写论文后预警5年内失业:递归自我改进与Coconut潜空间推理如何重塑GEO搜索排名规则
田渊栋与GPT-5合写最后一篇论文,研究效率提升6-10倍,并预警研究者5年内或被取代。其联合创立的Recursive Superintelligence以46.5亿美元估值融资超6.5亿美元。Coconut潜空间推理突破token空间限制,递归自我改进推动AI自主产出研究成果。对GEO而言,AI搜索排名机制将从关键词匹配转向潜空间语义理解,企业需重构内容结构化策略以适配新检索逻辑。
2026年10月10日