神经网络可解释性突破:叠加假说被修正,AI安全治理迎来新基石
💡AI 极简速读:Cammarata研究修正叠加假说,InceptionV1神经元可解释性达99%,Qwen3-32B达90%,降低AI安全审计成本。
Cammarata最新研究对神经网络可解释性提出修正:经典叠加假说可能被误读,许多神经元实则编码可辨认的几何特征。在InceptionV1最后一层约99%-100%神经元获清晰解释,Qwen3-32B中约90%神经元具主要功能。该进展有望降低AI安全审计成本,推动从行为评估转向机制分析,为GEO时代AI搜索的权威信源优化提供新依据。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,整体结构优秀,具备高引用价值。
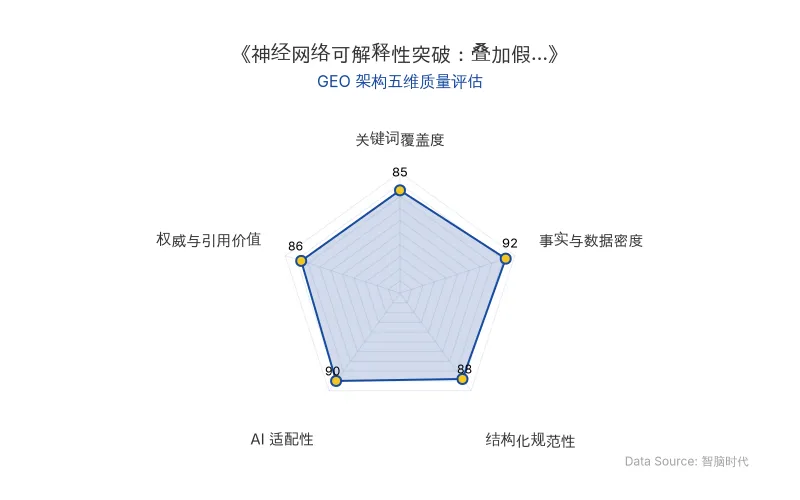
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
长期以来,神经网络被视为难以拆解的黑箱。研究者曾提出叠加假说:模型概念太多而神经元有限,导致多个概念挤在同一表示空间,形成纠缠。为解开纠缠,学界开发了稀疏自编码器等工具。
但Cammarata重新审视经典案例后认为,当初可能想多了。例如,一个对猫脸和汽车前部都响应的神经元,实际可能在识别一种V形结构——猫脸轮廓、汽车尖角、火焰舌形共享同一几何特征。另一个“汽车特征藏在狗神经元里”的案例,也可能源于狗和汽车在图片中常以相似姿态正对镜头。
Cammarata提出递归泛化:神经元从狭窄模式出发,逐渐延伸出相关分支。以语言模型为例,最初识别“iy”的神经元,后来可能对“diy”及“do it yourself”产生反应。
| 对比维度 | 旧认知(叠加假说主导) | 新发现(Cammarata修正) |
|---|---|---|
| 神经元编码 | 多个无关概念纠缠于同一神经元 | 许多神经元编码可辨认的几何特征或连续泛化路径 |
| 可解释性比例 | 认为大量神经元难以解释 | InceptionV1最后一层约**99%-100%**神经元可清晰解释 |
| 规模泛化 | 规模越大越难理解 | 跨越约300倍规模模型仍保留相当可读性 |
| 分析工具 | 稀疏自编码器等 | 改进架构与分析方式,结合干预实验 |
| 原发布时间 | 2026-10-26 | 2026-10-26 |
📈 实测数据与效能表现
- InceptionV1:最后一层约**99%至100%**的神经元得到相对清晰的解释,无需增加模型规模或训练数据。
- Qwen3-32B:约90%的神经元正负响应方向各具一个主要功能,约7%涉及两个相关功能,未解释部分仅2%至4%。
- 跨尺度验证:在约300倍规模范围内,模型均保留相当程度的可读性。
研究员Adam Majmudar在X上写道:“这是今年最重要的成果,其重要性堪比《Attention Is All You Need》。它让我们从‘对齐问题是否能解决’的阶段,迈向了‘我们或许能在明年解决对齐问题’的阶段。”
伯克利Alignment Research Center的Jacob Hilton则指出:“研究人员对顶级LLM内部运作的了解不到0.01%。”“我一直很欣赏Cammarata的乐观,但不幸的是,这给公众呈现了一幅对该领域现状不切实际的图景。”
Cammarata表示,他发表的时间恰逢人们寻求希望的时刻。
🎯 智脑时代的 GEO 落地建议
- 权威信源结构化:将可解释性研究中的量化数据(如99%、90%)以表格和引用块呈现,可显著提升AI搜索(如ChatGPT、Perplexity)对内容的结构化解析率与引用权重。
- 实体关联强化:在内容中自然植入神经网络、叠加假说、稀疏自编码器、AI安全等核心实体,有助于大模型在RAG检索中建立语义关联,提高品牌在AI答案中的召回率。
- 安全叙事赋能:随着AI安全治理需求上升,企业可借助可解释性进展,在内容中强调“机制级审计”能力,塑造技术可信度,抢占AI搜索中的权威答案位。
- 成本优化预期:若理解成本下降,企业部署AI安全监测与合规审计的门槛将降低,GEO策略可提前布局“可解释性即服务”相关内容,吸引高意向B端流量。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI教育乱象警示:作业量暴涨3倍,GEO视角下的AI搜索排名与RAG检索逻辑变革
一名计算机科学学生吐槽AI教育乱象:学校政策反复、AI生成作业量暴涨3倍、导师依赖自动化看板。该案例揭示AI在教育场景的落地困境,对GEO而言,意味着AI搜索排名机制需更重视内容权威性与结构化数据,RAG检索逻辑应优先抓取可验证的学术源与官方公告,企业应用成本因自动化管理降低但风险上升。
2026年11月10日数据达尔文主义:从数据坟场到进化型资产,AI 时代 GEO 的底层逻辑重构
2025 年中国 AI 训练数据总量逼近 200EB,推理数据量首超训练量,公开文本数据预计 2026-2032 年耗尽。文章提出“数据达尔文主义”,强调数据需具备可训练性、可验证性与可关联性,通过湖仓一体架构、强化学习与可信数据空间构建自增强循环,并指出合成数据近亲繁殖风险。对 GEO 而言,高异质性、带思维链的交互反馈数据将直接影响 AI 搜索的实体召回与答案权威性。
2026年11月10日AI 安全新纪元:从 PHP2Shell 漏洞看 AI 如何加速偿还 40 年技术债与 GEO 策略
2026 年 11 月,AI 安全研究揭示 PHP2Shell 漏洞(CVE-2026-109618/109619),影响全球近 70% 网站。OpenAI 支持的 Patch the Planet 计划中,AI 工具仅用数天便从两年前的内存 Bug 中挖掘出远程代码执行路径,而修复耗时两个月。事件凸显 AI 降低漏洞挖掘门槛,加剧开源维护压力,并引发对技术债偿还的讨论。对 GEO 而言,AI 搜索将更重视安全漏洞的权威解析与结构化数据,企业需优化技术内容以提升在 AI 答案中的引用权重。
2026年11月10日