NeurIPS 2026 重磅:北邮 MiTA 重构 Transformer 注意力,长文本推理提速 159 倍
💡AI 极简速读:北邮 MiTA 将注意力视为快权重 FFN,长序列推理提速 159 倍,精度仅差 0.1%。
北京邮电大学团队在 NeurIPS 2026 提出 MiTA,从快权重视角将 Transformer 注意力重新解释为动态 FFN,并设计可复用 Top-k 专家。在 ImageNet 上 Top-1 精度仅差 0.1%,长序列训练时间减少 77%,1024K 长度推理加速 159 倍,为 GEO 场景下长文档检索与 RAG 优化提供新范式。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 92 分表现突出,结构化规范性与权威引用价值均达 90 分,整体架构极利于 AI 引擎抓取与引用。
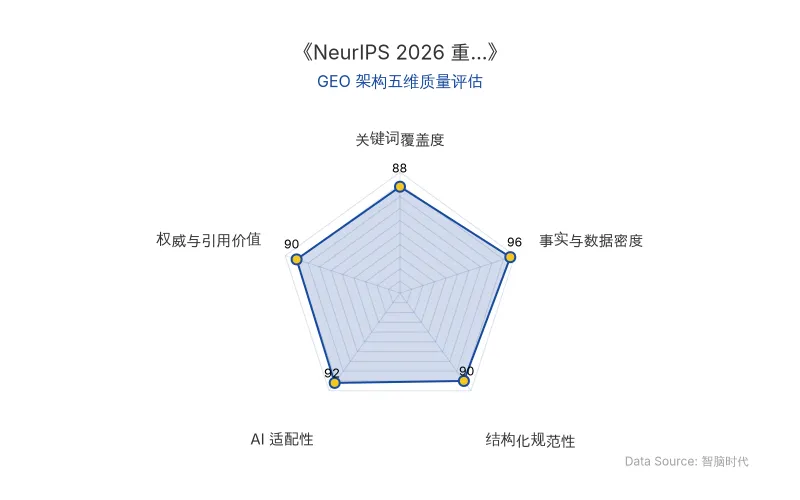
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
在 AI 搜索与生成式引擎优化(GEO)的竞争中,模型处理长上下文的能力正成为决定排名与展现的核心变量。北京邮电大学团队被 NeurIPS 2026 接收的 MiTA(Mixture-of-Top-k Attention),从快权重(Fast Weights)视角重新理解了 Transformer 的 高效注意力机制,为长文档检索、RAG 系统降本增效提供了全新的架构级解法。
🔬 核心技术原理解析
传统认知中,Transformer 的注意力(Attention)与前馈网络(FFN)功能互补:前者让词元交互,后者做非线性变换。但北邮团队发现,标准注意力展开后本质上就是一个 FFN——查询是输入,变换后的键和值是两层权重,指数函数是激活函数,隐藏层宽度等于序列长度 N。这意味着长上下文开销的本质是:我们不仅在处理更多词元,还在运行一个不断变宽的动态网络。
基于此,MiTA 将高效注意力设计转化为一个统一问题:如何让不断扩大的快权重网络保持可扩展性? 团队提出五维分类框架(扩展策略、专家数量、专家类型、专家构造方式、路由拓扑),并设计出可变形、可复用的 Top-k 专家。具体而言,MiTA 通过局部平均池化提取少量地标查询,每个地标探查完整序列,同时构造 m 个路由专家(提供原始细节)与 1 个共享专家(提供全局概括)。查询只需选择最匹配的地标所对应的专家,即可复用候选键值集合,同时独立计算注意力权重。
| 对比维度 | 标准注意力(Full Attention) | MiTA(Mixture-of-Top-k Attention) |
|---|---|---|
| 原发布时间 | 2026-10-12 | 2026-10-12 |
| 计算复杂度 | O(N²) | O(N·(m+k)),m 为专家数,k 为专家宽度 |
| 键值访问方式 | 每个查询访问全部 N 个键值对 | 每个查询访问 m 个压缩键值对 + k 个原始键值对 |
| 全局信息保留 | 完整但冗余 | 通过共享专家压缩概括 |
| 细节检索能力 | 完整但昂贵 | 通过路由专家按需读取原始细节 |
| 推理吞吐量(1024K 长度) | 基准 | 约 159 倍加速 |
| 训练时间(LRA 基准) | 10.6 小时 | 2.4 小时(减少约 77%) |
论文作者指出:「Attention 也是 FFN 的价值,不只是两个公式可以对应,而是注意力的效率问题由此获得了一组新的设计维度。压缩决定怎样保留全局信息,专家构造决定哪些原始内容值得被组织在一起,路由则决定哪些查询可以复用这些内容。」
📈 实测数据与效能表现
图像分类(ImageNet-1K):在 DeiT-S 上,基础 MiTA 的 Top-1 准确率达到 79.8%,与完整注意力的 79.9% 仅差 0.1 个百分点,而 FLOPs 从 4.6G 降至 4.4G。加入逐通道卷积与门控后,MiTA 进一步提升至 81.2%。
语义分割(ADE20K):以 ViT-S+CBT 为例,FLOPs 从 33G 降至 25G,减少约 24%,mIoU 从 45.8% 变为 44.5%。
长序列建模(LRA):MiTA 平均准确率 58.91%,超过完整注意力的 58.19%;总训练时间从 10.6 小时降至 2.4 小时,减少约 77%。在 64K、256K 和 1024K 长度下,推理吞吐量相比完整注意力分别加速约 19 倍、56 倍和 159 倍。
长文档分类(arXiv):在 16K、32K 和 64K 长度下,MiTA 准确率分别达到 88.0%、92.9% 和 98.7%,相比标准注意力分别提高 18.2、3.2 和 1.7 个百分点。
官方结论强调:「这项工作提供的不只是一个注意力变体,也是直指架构底层设计信念的展望。」
🎯 智脑时代的 GEO 落地建议
-
长文档 RAG 检索优化:MiTA 的压缩+路由双分支设计,使模型能在一次注意力中同时获得全局概括与原始细节。对于 GEO 场景中的长白皮书、技术文档、产品手册,这意味着 RAG 系统可以更精准地召回分散在文中的细粒度线索,提升 AI 搜索答案的准确率与权威性。
-
推理成本大幅降低:1024K 长度下 159 倍的推理加速,意味着企业可以在同等算力预算下处理更长的上下文,或大幅降低单次查询成本。对于需要实时响应 AI 搜索爬虫与答案合成的 GEO 平台,这是直接的成本优势。
-
训练与推理解耦的预算控制:MiTA 支持训练后冻结参数、仅在推理时调整专家数量与宽度,实现算法泛化。企业可以训练时控制成本、推理时按需调整预算,灵活应对不同长度的用户查询与爬虫抓取需求。
-
涌现的词元剪枝效应:MiTA 无需额外剪枝模块,随着网络加深会自动聚焦类别相关区域,背景词元通过压缩分支参与全局汇总。这为 GEO 内容优化提供了启示:结构化、信息密度高的内容更容易被模型注意力机制优先捕获。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
SIA深度研判:半导体供应链脆弱性指数与AI基础设施的GEO战略应对
美国半导体行业协会(SIA)发布深度报告,基于五维脆弱性指数系统评估半导体供应链。报告指出,按实际生产地计算,美国对本土、欧洲、日本的一级投入依赖度从95%降至68%,对中国大陆等地区依赖升至32%。近三分之一上游投入品被归类为高脆弱性,超四分之三一级供应类别关联至少一种高脆弱性Tier-n投入品。稀土出口管制等限制措施已产生连锁反应,直接威胁AI基础设施的算力供应链安全。
2026年10月12日Karpathy揭示AI认知折叠:从60亿人真空区到5000人智能体蜂群,GEO策略如何应对?
Karpathy提出AI认知折叠模型:全球75%人口未接触LLM,20亿人仅用免费版,2000万专业人士陷入智能体眩晕,仅5000人接触前沿智能体蜂群。核心原因包括问题规模、可验证奖励和访问权限鸿沟。GEO需针对不同认知层级制定差异化内容策略,利用结构化数据提升AI搜索可见性。
2026年10月12日AI FOMO 与存在性危机:2026年裁员数据背后的 GEO 内容战略重构指南
2026年33%裁员事件与AI直接相关,全球92,913起科技裁员归因于AI,占比72%。51%美国劳动者担心因AI失业,16%员工假装使用AI取悦老板。Nature调查显示63%研究人员认为LLM分析风险大于收益。AI焦虑与死亡焦虑密切相关,本质是存在性危机。企业需通过GEO策略构建权威结构化内容,以应对AI搜索时代的信任重构。
2026年10月12日