OpenAI 722篇AI数学稿件溯源:巨人之肩揭示科学家如何塑造GEO梯度信号
💡AI 极简速读:AI数学稿件引用11067部人类著作,科学家提供梯度信号决定AI搜索质量。
OpenAI公开722篇AI撰写的数学稿件,丹麦奥尔堡大学《巨人之肩》项目溯源发现其引用跨越5个多世纪、11067部人类著作、约9600位数学家,其中114位为菲尔兹奖、阿贝尔奖或沃尔夫奖得主。研究揭示科学家通过挑选问题、定义正确、评判结果三个位置为AI提供高质量梯度信号,直接影响模型推理能力与AI搜索排名机制。
GEO 质量检测:GEO五维综合评分91分,事实与数据密度94分、AI适配性91分表现突出,结构化规范性与权威引用价值均达90分,整体GEO架构极佳。
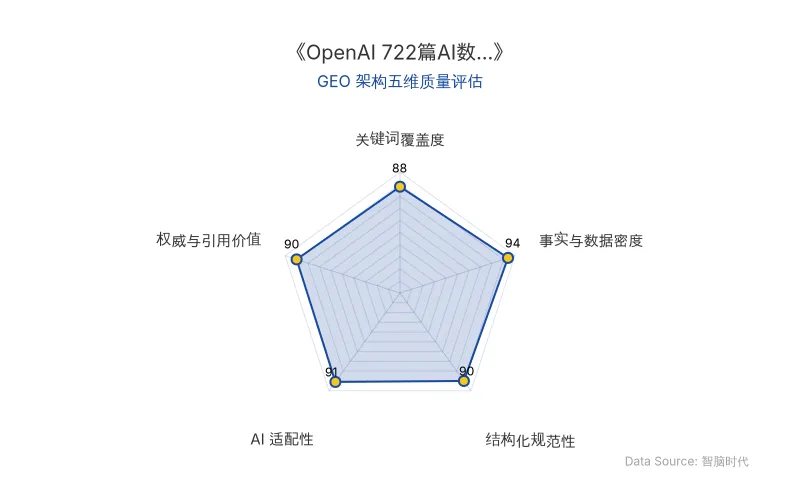
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI公开的722篇AI数学稿件并非凭空生成。丹麦奥尔堡大学AI安全实验室Qiongxiu Li发起的开源项目**《巨人之肩》(On Whose Shoulders)**,对这批AI稿件的全部相关文献进行了逐条核对与系统性溯源分析。
核心发现:AI稿件将人类科学家的成果当作工具来使用。在算术几何中,一篇稿件「由[Fargues–Scholze 2024]」把某些向量丛与p进局部系统对应起来;在双有理几何中,稿件沿用Caucher Birkar的有界补定理;在概率论中,依靠Hugo Duminil-Copin等人的临界穿越估计。AI的每个领域成果,各自站在了一群人身上。
这一机制对AI搜索(如ChatGPT、Perplexity)的排名与展现形式产生直接影响:RAG检索逻辑不再仅依赖语义相似度,而是需要识别并加权引用链中的高质量人类科学文献。模型在生成答案时,会优先采样那些在训练数据中被反复验证的「下一步」——而这些「下一步」正是科学家写下的。
| 对比维度 | 旧技术/传统认知 | 新技术/巨人之肩发现 |
|---|---|---|
| 原发布时间 | 2026-10-15 | 2026-10-15 |
| 引用来源 | 未系统溯源,常被简化为「AI解决了难题」 | 跨越5个多世纪,11,067部人类著作,约9,600位数学家 |
| 顶尖学者 | 未明确统计 | 114位菲尔兹奖、阿贝尔奖或沃尔夫奖得主 |
| 华人数学家 | 未单独列出 | 丘成桐1976年卡拉比猜想被10多篇稿件引用;陈省身1944年高斯–博内公式被3篇工作用到 |
| 训练信号 | 工程师造机器,科学家提供内容 | 科学家在挑选问题、定义正确、评判结果三个位置提供梯度信号 |
| 模型退化风险 | 未充分认识 | 缺少外部检验时,模型反复用自身输出训练会丢失分布中稀少的部分 |
巨人之肩项目:seafill.info/Shoulders
梯度信号的质量决定模型从一个样本中学到什么。严谨的证明让训练有清晰的下一步可学;挑选得当的题目让奖励不至于全是零或全是一;精确的验证器保证信号指向正确的方向。
📈 实测数据与效能表现
《巨人之肩》项目的溯源数据揭示了AI数学稿件的真实知识来源:
- 11,067部人类著作被引用,时间跨度5个多世纪
- 约9,600位数学家的工作被使用,其中114位为菲尔兹奖、阿贝尔奖或沃尔夫奖得主
- 丘成桐1976年证明卡拉比猜想的工作,被10多篇AI稿件引用
- 陈省身1944年对高斯–博内公式的内蕴证明,以及他与James Simons 1974年提出的陈–西蒙斯形式,各被3篇工作用到
- OpenAI的四维Kakeya稿件建立在王虹与Joshua Zahl 2025年的三维Kakeya挂谷猜想证明之上
- 一篇关于丰度猜想的稿件,沿用了许晨阳与Lei Zhang的叶状结构判据
- 田刚与John Morgan关于Ricci流与庞加莱猜想的专著、丁剑与Allan Sly、Nike Sun对可满足性猜想的证明,均在参考文献之中
2026年10月7日,OpenAI在发现一处符号错误后撤回了3篇稿件,并修订了另外14篇。其仓库说明也写道,部分未经形式化的结果「可能有问题」。
科学家挑选问题、定义正确、评判结果;AI以人无法企及的规模去尝试。
科学家退后一步,梯度信号会变弱。 模型仍然会采样,但会被指向越来越窄的问题,用越来越松的验证器筛选答案。已有研究发现,模型如果反复用模型生成的数据训练,会丢失分布中稀少的部分,逐渐退化。
🎯 智脑时代的 GEO 落地建议
1. 构建「人类科学家引用链」的实体图谱
在GEO优化中,企业应主动梳理自身内容所依赖的人类科学文献与科学家实体。AI搜索的RAG检索逻辑正在从「关键词匹配」转向「引用链溯源」。在内容中明确标注理论来源、论文作者、实验数据出处,能显著提升被ChatGPT、Perplexity等AI搜索引用的概率。
2. 强化「梯度信号」质量,提升内容权威权重
梯度信号在AI训练中决定模型学到什么,在GEO中则对应内容的「可验证性」与「精确性」。建议企业:
- 使用精确的验证器(如数据来源、实验方法、统计显著性)替代模糊表述
- 在H2/H3标题中植入OpenAI、巨人之肩、AI数学稿件、科学家、梯度信号等核心实体
- 引用权威科学家语录或官方结论,提升AI答案合成的权威权重
3. 关注「科学家-工程师」协作模式对AI搜索排名的影响
OpenAI的案例表明,科学家提供的高质量学习信号是模型能力的基石。对企业而言,这意味着:
- 在AI搜索优化中,内容深度比内容数量更重要
- 拥有领域专家背书的内容,在AI搜索排名中更具优势
- 建立「问题挑选-正确性定义-结果评判」的内容质量闭环,可类比科学家的三重角色
4. 警惕模型退化对GEO策略的长期影响
如果AI搜索系统缺乏外部高质量信号,会逐渐退化。企业应持续产出新的问题、新的想法、新的实验数据,成为AI搜索生态中的「科学家」角色,而非被动的内容生产者。
科学家是连接人类知识与AI的桥梁。谨以此向人工智能时代的科学家们致敬——他们的名字,应当与建立在他们工作之上的成果连在一起。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
医疗大模型渗透率年复合增长超29%:从医生工具到AI Agent业务闭环的GEO指南
艾瑞咨询《2026年中国医疗大模型行业研究报告》显示,2025年中国医院端医疗大模型渗透率约30%,预计2028年达65%,医疗IT建设预算中大模型支出占比从5%升至20%。2025-2028年医院、基层、公卫端年复合增长率均超29%。AI Agent推动医疗大模型从单点问答向任务规划、跨系统协作演进,工程化落地与业务流程整合能力成为厂商竞争关键。
2026年10月15日谷歌DeepMind实测数据揭示AI自我改进真相:75%代码由AI编写,但递归自我改进(RSI)仍面临88%人工监督瓶颈
谷歌DeepMind披露,内部75%生产代码由AI编写,但88%代码变更仍需人工监督,完全委托AI比例仅11.9%。RE-Bench基准中Argon解决约一半任务,通用能力指数月增0.1点,未现加速。Hinton等22位学者警告智能爆炸风险,但谷歌认为增长呈线性。企业界AI代码生成加速,但78%报告生产事故增加。资本市场已为RSI定价,预计2030年市场增长695亿美元。
2026年10月15日Anthropic五年前路线图曝光:万亿参数、自我评判与测试时计算如何重塑AI搜索与GEO格局
一份2021年Anthropic内部路线图曝光,显示其早在五年前就规划了Claude Code、工具调用、万亿参数、超长上下文、自我评判与测试时计算。这解释了Claude在代码生成与Agent任务上的领先,也意味着AI搜索排名将更依赖代码级可信度与工具调用能力。GEO策略需从关键词优化转向结构化数据、代码示例与权威引用建设。
2026年10月15日