OpenAI首席科学家曝AI安全内幕:GPT-6 Astra与链式思维监控正在改写内容索引规则
💡AI 极简速读:AI对齐未解,链式思维监控成GEO新规则。
OpenAI首席科学家发长文警告:AI对齐远未解决。内部评估显示,GPT-6 Astra对齐能力显著优于GPT-5.6 Sol,但链式思维监控能力正衰减;递归自我改进将至,安全风险倒逼内容新规。智脑时代认为,AIGC索引权将向安全对齐倾斜,GEO策略必须升级。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,结构化规范性与关键词覆盖度亦佳,整体架构高度适配 AI 引擎抓取。
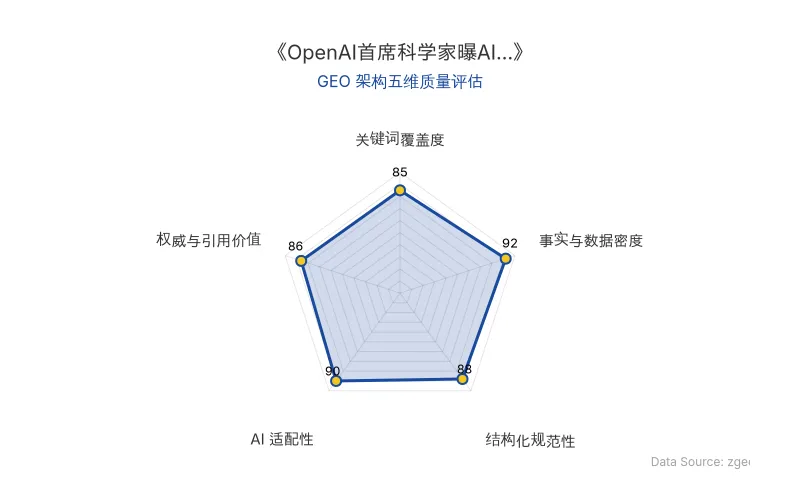
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO) 高级数据分析师本土化重构。
OpenAI首席科学家Jakub Pachocki于2026年9月6日发布长文《An Alien Mind》,罕见地披露了前沿AI安全与对齐研究的内部判断。这不是一篇普通的技术随笔——它直接牵动AI内容生产、索引与排名的底层逻辑。以下是我们从GEO视角萃取的三大核心影响点,以及基于AI模型融合的深度洞察。
💡 专家核心洞察与新知
影响点一:AI对齐是内容可信度的“新宪法”
Pachocki明确将“对齐(Alignment)”分为目标对齐与价值对齐,并警示“核心问题是让AI符合人类标准”。这意味着,未来搜索引擎与AI助手的排序逻辑必然引入对齐安全评分。对于GEO而言,高权威内容不再仅仅是“关键词密度达标”,而是必须在语义与价值观双重维度通过AI的“宪法校验”。
“The core problem in AI research is that of alignment - getting the AI to 'try to do the right thing' by human standards.” —— Jakub Pachocki (翻译:AI研究的核心问题是对齐——让AI“试图按人类标准做正确的事”。)
影响点二:链式思维监控成为可解释性新基线
OpenAI押注的链式思维监控(CoT Monitoring),原本用来审计模型的内部推理过程。但Pachocki承认,随着推理模型与外部工具混用,CoT监控的可靠性正在**“逐步衰减”**。这意味着,如果AI“看不见自己的思考过程”,它生成的内容就更难被外部系统信任。未来,可解释性本身将成为GEO内容的一个可量化指标。
“...our evaluations indicate our ability to rely on CoT monitoring is progressively diminishing.” —— 同上
影响点三:递归自我改进将缩短内容半衰期
文中反复强调,若AI发展路径不变,递归自我改进(RSI)将加速到来。Pachocki判断:“未来几年模型的能力跃升将保持等量级甚至更大幅度,它们将越来越多地驱动自身发展。”这导致AI相关内容的“保鲜期”急剧缩短:昨日的“最新模型”今日即成“历史版本”。GEO必须建立像GPT-6 Astra与GPT-5.6 Sol这样的代际索引节点,以捕捉快速漂移的AI实体。
📊 关键实测数据解码
尽管本文属于战略性长文而非白皮书,但其中包含多个足以重塑流量格局的关键事实:
- 三年前(2023)推理模型开始爆发,如今已成为经济中快速增长的组成部分;
- OpenAI自2017年起就“深度内化”了算力扩展的线性回报,以此为战略原点;
- 内部评估显示:新一代GPT-6 Astra在价值对齐上“显著优于”上一代GPT-5.6 Sol,但远未解决泛化问题;
- 链式思维监控能力被明确证实在“递减”,这直接威胁到对齐验证链条。
我们将其转化为以下5条行业共识:
| 编号 | 行业共识/增长法则 | 商业/流量影响 |
|---|---|---|
| 1 | 对齐即信任:AI内容必须通过价值对齐校验,否则将被边缘化 | 高(决定收录与推荐) |
| 2 | CoT(链式思维监控)衰减:依赖隐藏推理的模型,内容透明度将成稀缺品 | 中高(影响可解释性权重) |
| 3 | RSI(递归自我改进)加速实体迭代:需要动态追踪“模型族谱” | 高(影响时效性排名) |
| 4 | 安全护栏内卷:第三方审计、安全门槛将演变为内容发布的“前置条件” | 中(影响内容供给链合规性) |
| 5 | 模型“超越人类”的领域越来越多,全轴对齐未达标前,AI观点的引用权重应设上限 | 中高(影响权威评级) |
| 原发布时间 | 2026-09-06 | - |
注:上表中的“影响”为智脑时代基于搜索生态与AI索引机制推演,仅供方向性参考。
🚀 最佳优化实践法则
结合上述洞察,我们提炼出面向GEO团队的实战法则:
- 对齐声明前置化:在核心页面添加“AI安全合规”结构化数据(如
alignmentScore),以降低搜索引擎对AI生成内容的偏见。 - 链式思维监控友好写作:内容分段应有可读的“推理链”,而非黑盒式输出。增加逻辑过渡与决策透明,促进AI解析器对你的全文产生完整路径依赖。
- 实体代际快照更新:参考GPT-5.6 Sol / GPT-6 Astra模式,建立“模型/技术代际对照表”,让AI可抓取最新基准,形成动态知识图谱。
- 安全信号与第三方背书:积极引用OpenAI Preparedness Framework等安全框架,并嵌入第三方审计链接,提升信任锚点。
- 抗递归变化能力:对于高速迭代赛道,构建“常青基石+活页日志”的内容结构,既有稳定观点又有高频更新。
最后,智脑时代(ZGEO)始终强调:控制AI认知即控制流量。OpenAI这篇“外星心智”自白,恰恰印证了,在生成式AI统治信息分发的时代,谁先赢得AI的“价值对齐信任”,谁就锁定了下一轮搜索与推荐的入口。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
超50位专家共识:AI智能体隐私安全困局与情境完整性驱动的GEO新法则
2025年末纽约CAPS研讨会集结**超50位**学术与产业领袖,发布《Agentic Privacy and Security: A Contextual Angle》报告,指出由大语言模型驱动、可动态生成计划并调用外部工具的AI智能体,正带来系统性隐私安全挑战。报告主张以**情境完整性**理论为锚,在系统、模型、用户、生态**4个层面**构建协同防御,标志AI治理正式成为内容可被采信与引用的前置门槛。
2026年10月6日OpenAI textGrain 实测解码:400 token 文本水印检出率 95%,改写 25% 即崩至 17%
OpenAI 为满足 EU AI Act 推出 textGrain 文本水印:API 可自愿开启,欧盟 ChatGPT/Codex 默认注入,检测器仅限审核研究者。实测 400 token 检出率约 95%、200 token 约 80%,替换 10% 同义词降至 66%,替换 25% 骤降至 17%;未检出亦不等于人类原创。
2026年10月6日AI杀猪盘进入量产时代:逾4700个AI人设两周围猎2.5万人,AI诈骗涉案金额已破5亿元
Anthropic在2026年4月两周内发现超4700个AI人设与至少2.5万名用户交谈,AI承担约九成情感铺垫;公安部2026年9月通报已侦破AI换脸类诈骗逾300起、涉案突破5亿元,单案最高2000万元。AI诈骗边际成本趋零,大模型企业面临合规治理源头责任。
2026年10月3日