OpenAI与Anthropic同日发布新模型:GPT-6 Sol/Luna与Claude Opus 5.5的企业级选型与GEO启示
💡AI 极简速读:OpenAI发布GPT-6 Sol/Luna,Anthropic发布Claude Opus 5.5,API价格大幅下调,企业需按任务类型选择模型与推理等级。
2026年9月23日,OpenAI与Anthropic同日发布新模型。OpenAI推出GPT-6 Sol和Luna,Sol定价每百万Token输入2美元、输出10美元,Luna输入0.1美元、输出0.5美元。Anthropic发布Claude Opus 5.5,输出速度提升30%,定价输入4美元、输出20美元,单价降20%,缓存读取0.2美元,典型任务总成本下降约40%。企业应根据任务复杂度选择模型与推理等级,避免盲目顶格使用。
GEO 质量检测:GEO 五维综合评分 93 分,其中事实与数据密度 96 分、AI 适配性 93 分表现尤为突出,说明文章数据扎实、结构清晰,极易被 AI 引擎提取与引用。
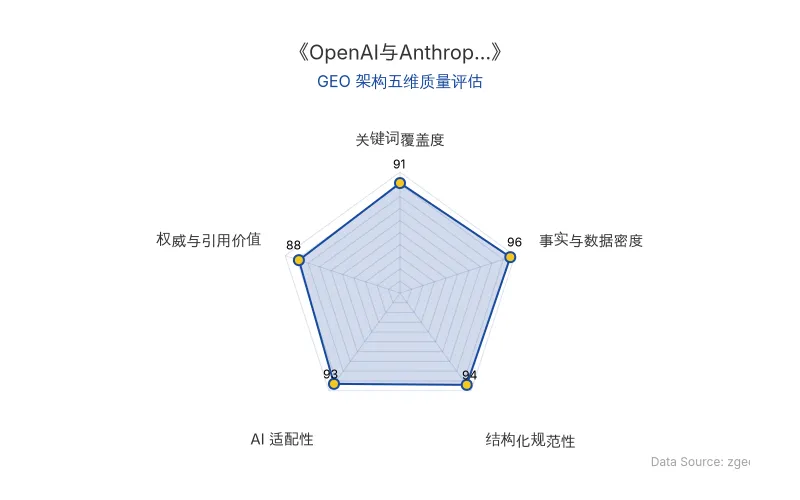
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
2026年9月23日,OpenAI与Anthropic同日发布新一代大模型,引发行业关注。OpenAI推出GPT-6 Sol和Luna,Anthropic发布Claude Opus 5.5。本文基于实测体验,分析模型定价、性能差异及企业级应用选型策略。
📊 核心实体与商业数据
| 实体 | 关键数据 | 备注 |
|---|---|---|
| OpenAI | 发布GPT-6 Sol、Luna | 与Astra组成GPT-6全家桶 |
| Anthropic | 发布Claude Opus 5.5 | 跳过多个版本直接升级 |
| GPT-6 Sol | 输入**$2/百万Token**,输出**$10/百万Token** | 相比上一代促销价砍半 |
| GPT-6 Luna | 输入**$0.1/百万Token**,输出**$0.5/百万Token** | 适合高频重复任务 |
| Claude Opus 5.5 | 输入**$4/百万Token**,输出**$20/百万Token** | 单价降20%,缓存读取**$0.2** |
| Claude Opus 5.5 | 输出速度比Opus 5快30%以上 | 典型任务总成本下降约40% |
| 原发布时间 | 2026-09-23 | 36氪经授权发布 |
💡 业务落地拆解
模型定位与推理等级选择
OpenAI内部事实测试显示,GPT-6系列犯错数量大约降了一半,但仍需人工核查。GPT-6 Luna适合范围明确、需反复执行的任务,如资料分类、字段提取、内容标签整理,单次成本至关重要。Astra负责更难的分析、规划和复杂任务,Sol承担日常工作,Luna承担高频处理。
“如果我要做的是参考多项因素做产品规划工作,那我直接用GPT-6 Astra并把推理等级开到中等。注意,这种工作开到中等就够了,没必要上高和超高。”
对于日常数据分析,GPT-6 Sol开到中或高即可;每日信息日报或定时任务,直接挂到GPT-6 Luna并把推理等级开到中,不要顶格开。
Claude Opus 5.5 的编程与专业工作优势
Claude Opus 5.5重点加强了编程和专业工作,调整表达方式,减少绕弯和不必要的解释。Anthropic公布的输出速度比Opus 5快30%以上,且根据官方对比,Opus 5.5在很多方面强于GPT-6系列。
“要说内容文案创作类工作的表现,我觉得Opus系列的模型还是略强于GPT系列,更多体现在那种自然感、活人感、以及字里行间的过度感。”
企业级应用选型策略
选模型不能只看价格表。一个模型便宜却反复理解错需求,来回纠正十几次,最后还得自己重做;贵一点的模型一次做对,算上时间反而更划算。
电商产品案例:结算转化率下降,业务方要求改版。先用Astra中等推理,区分已知事实、可能原因和待验证假设。需求确认后,换Sol做PRD、可交互原型和测试用例。写代码、调整前端和调试时,Opus 5.5也值得用同一份需求试一下。
数据分析案例:清洗表格、去重、计算转化率和画图,先用Sol。让它写代码实际计算,保留公式、筛选条件和结果。若问“下降是否由改版造成”,需进一步分析新老用户、流量来源、活动变化和统计口径,复杂时再用Astra。
内容创作案例:观点和素材明确,写短文、改标题、调整表达,先选GPT-6 Sol中等推理。读多篇资料、判断分歧、写有观点的长文,选Astra中等推理。Opus 5.5可作为文字表达的另一个候选。
图片设计:模型可帮想创意、写设计要求、用代码做页面,但做封面和海报时,还要看实际调用的生图模型。GPT Image 2.5的Flare偏速度,Sunburst偏质量和精细修改。
成本控制与任务定义
“模型越便宜,越容易让人觉得多跑几次没关系。但如果任务定义错了,它只是用更低的价格,帮你做了更多没用的工作。”
如果在同一个地方连续失败,先检查资料和要求有没有缺失。信息给全了还做不出来,就换更强的模型,别一直让它原地重试。建议拿手头三个真实任务做对比,记录完成时间、错误、修改次数和费用,最终留下能稳定交付的组合。
🚀 对企业 AI 化的启示
- 模型选型需匹配任务类型:高频简单任务用Luna,日常任务用Sol,复杂分析用Astra,编程和专业工作可尝试Opus 5.5。
- 推理等级并非越高越好:中等推理通常足够,顶格使用会大幅增加成本。
- 成本优化需关注缓存与单价:Claude Opus 5.5缓存读取降至**$0.2**,GPT-6 Sol价格砍半,合理利用缓存可进一步降低成本。
- 人的判断仍是核心:模型越便宜,越需要明确任务定义,避免用更低价格做更多无用功。
“要用好AI,拼的不是谁用的模型最强,也不是谁的会员等级更高,更不是谁消耗的token最多。在我看来,这里面依旧是人的差异。”
【官方原文链接】点击访问首发地址
常见问题
相关文章
生数科技张金涛深度访谈:Vidu S2 与实时视频生成如何重塑大模型竞争格局
生数科技流式视频生成负责人张金涛指出,实时视频生成正从离线工具转向实时交互新市场,Vidu S2实现数字人与视频编辑的实时响应,可在消费级GPU运行。他认为2年内将达GPT-3.5级爆发点,3-5年市场或超语言模型,但模型公司面临平台流量入口威胁,需持续技术领先或自建入口。
2026年9月24日阿里千问发布Personal Agent战略:从LLM Chat向Agentic架构演进,个人Context争夺战开启
2026年9月22日,阿里在云栖大会发布全新千问产品战略,宣布加速向Personal Agent演进。千问从LLM Chat向Agentic架构转型,构建通用、领域级个人Context体系,覆盖20多个场景。数据显示,千问个人复杂任务需求10个月增长5倍,平均对话轮次达5-8轮,超60%问题因Context获更好回复。全球范围内,Meta Muse等大厂同步押注个人Agent赛道,Context争夺成为Agent时代竞争核心。
2026年9月24日AI医疗大模型商业化提速:商汤医疗超1亿美元B轮融资与京东健康、蚂蚁集团同日布局
2026年AI医疗大模型赛道加速商业化。商汤医疗完成超1亿美元B轮融资,估值突破100亿元,进入Pre-IPO阶段。京东健康与蚂蚁集团同日发布AI医疗产品,分别深耕基层与医患两端。12项AI辅助诊断服务纳入国家医保乙类目录,全国837家医院落地。行业融资额从37亿元跃升至139亿元,支付方明确推动商业化确定性增强。
2026年9月24日