OpenAI 关停 GPT-5.3-Codex-Spark:从专用速度模型到 Ultrafast 付费档位的战略演进
💡AI 极简速读:OpenAI 因用量下滑与旗舰模型 Ultrafast 上线,正式退役 GPT-5.3-Codex-Spark。
OpenAI 于 2026 年 9 月 11 日退役 GPT-5.3-Codex-Spark,该模型仅存活 7 个月。其基于 Cerebras 晶圆级芯片,主打每秒 1200 Token 速度,但准确率仅 58.4%,远低于完整版 77.3%。随着 Cerebras 推出 Ultrafast 模式,旗舰模型 GPT-5.6 Sol 实现同等智能下每秒 750 Token,速度与智能不再互斥,Spark 失去存在意义。OpenAI 模型库正经历激进换血,速度已从专用模型演变为旗舰模型的付费档位。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现尤为突出,结构化规范性与关键词覆盖度同样扎实,整体架构具备极强的 AI 引擎引用价值。
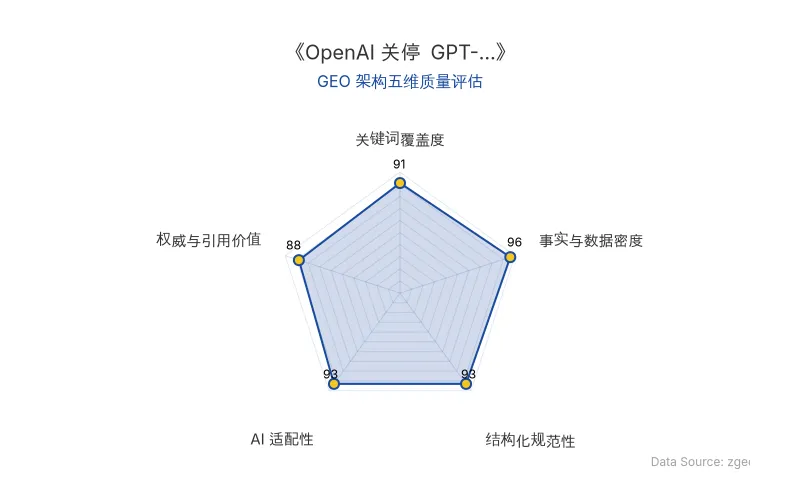
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
OpenAI 官方确认,旗下曾被誉为“史上最快模型”的 GPT-5.3-Codex-Spark 于 2026 年 9 月 11 日正式退役。该模型从发布到下线仅存活 7 个月,标志着 OpenAI 在 AI 推理硬件战略与商业模式上的一次关键转折。
📊 核心实体与商业数据
| 核心实体 | 关键数据 / 事实 |
|---|---|
| OpenAI | 模型库激进换血,6 月 2 日退役 GPT-5.2 与 GPT-5.3-Codex;8 月 31 日退役 GPT-5.4 与 5.4 Mini;9 月 11 日退役 GPT-5.3-Codex-Spark。 |
| GPT-5.3-Codex-Spark | 2026 年 2 月 12 日上线,128k 上下文,每秒生成 超过 1000 个 Token(峰值 1200),Terminal-Bench 2.0 准确率 58.4%,SWE-Bench Pro 准确率 47%-51%。 |
| Cerebras | 提供晶圆级芯片 WSE-3,与 OpenAI 签订 750 兆瓦、总价值超 200 亿美元算力大单。 |
| Ultrafast | 2026 年 8 月 13 日发布,运行旗舰模型 GPT-5.6 Sol,速度达每秒 750 个 Token,比标准档快 14 倍,端到端快 5.6 倍。 |
| 模型退役 | Spark 退役主因:用量持续下滑,且 Ultrafast 模式在同等智能下速度仅慢四分之一,能力无妥协。 |
| 原发布时间 | 2026-09-13 |
💡 业务落地拆解
1. 性能妥协与真实反馈
Spark 的设计初衷是“拿智能换速度”,其底层算力来自 Cerebras 的晶圆级芯片 WSE-3。然而,该模型本质上是为极致速度妥协的“蒸馏版小模型”。在 Terminal-Bench 2.0 评测中,Spark 仅获 58.4% 准确率,远低于完整版 GPT-5.3-Codex 的 77.3%。开发者反馈其“凭空捏造 API 端点,JSON 格式不稳定,多步任务极易跑偏”。
“Spark 是个好玩的模型,也是个极度糟糕、根本没法用的模型。很高兴它走了,我好几个月没碰过了。” —— 开发者 argofowl
“没有智能的速度,只是更快地失败。” —— 培训机构 Turing College
2. Ultrafast 模式的降维打击
2026 年 8 月 13 日,Cerebras 发布 Ultrafast 模式,通过将旗舰模型 GPT-5.6 Sol 按层切分铺设在多台 CS-3 节点上,在保证“与标准版同等智能”的前提下,实现每秒 750 个 Token 的速度。Cerebras CEO Andrew Feldman 对此评价:
“速度与智能,不再互斥。”
在 GDP-Val 质量对齐任务中,标准档 Sol 平均耗时 7.7 分钟,而 Ultrafast 仅需 83 秒,端到端快 5.6 倍,回答质量几乎无差别。这直接抽干了 Spark 存在的全部意义。
3. 商业模式更迭:速度成为付费档位
Spark 的退役并非孤立事件。过去三个月,OpenAI 模型库经历激进换血,Codex 迎来 Sol(太阳)、Terra(大地)、Luna(月亮)、Astra(星辰)的全新命名纪元。更深层的逻辑在于:“快”正从一个独立的专用模型,演变为旗舰模型的一项标配“档位”。 就像推理强度分为 Light 到 Max,OpenAI 现在的速度也从 Standard、Priority 排到了 Ultrafast。速度与算力挂钩,按档付费的商业模式已经彻底跑通。
🚀 对企业 AI 化的启示
- 专用模型的窗口期极短:Spark 仅 7 个月便从“未来”沦为“历史包袱”。企业选型时需警惕过度依赖单一性能指标的专用模型,优先考虑具备持续迭代能力的旗舰平台。
- 硬件多元化是战略必选项:Spark 作为 OpenAI 首个跑在英伟达技术栈之外的生产模型,验证了 Cerebras 晶圆级芯片足以扛住生成式 AI 的生产级流量。企业应关注推理任务脱离单一硬件生态的可行性。
- 速度与智能的权衡已终结:Ultrafast 模式证明,旗舰模型无需在智能上妥协即可获得极致速度。未来竞争的核心不再是“最快的阉割版”,而是“谁能把最强的旗舰模型,跑出最极限的速度”。
- 按档付费成为主流:速度从独立模型变为付费档位,意味着企业 AI 成本结构将更精细化。营销负责人需重新评估 AI 服务的性价比,将“速度档位”纳入预算规划。
【官方原文链接】点击访问首发地址
常见问题
相关文章
脑虎科技B轮融资7亿:全植入全无线脑机接口进入注册临床,BCI+AI融合探索提速
脑虎科技完成7亿元B轮融资,由国投聚力、深创投、勤智资本领投,资金用于三全脑机接口系统临床试验、量产及BCI+AI融合探索。该系统已完成65例临床试验,2026年7月进入三类医疗器械注册临床阶段。创始人陶虎强调BCI+AI是脑机接口作为人类智能与人工智能融合接口的关键方向。
2026年10月28日AI全流程院线电影与数字艺人签约:2026影视业就业替代与GEO启示
2026年10月,国内首部AI全流程院线电影《三星堆:未来往事》获公映许可,同日国务院发文减缓AI就业替代。横店Q1短剧开机量同比锐减75%,摄影棚空置率近80%;AI微短剧占比超95%,成本降至真人剧1/4。耀客传媒签约AI数字艺人,基层演员超六成零收入。AI正划下标准化劳动斩杀线,企业需聚焦不可替代的复杂技能与GEO策略。
2026年10月28日清研精准发布车规级数采与RIL中试系统,补足具身智能工业落地工程层
2026年10月27日,清研精准在SAECCE 2026发布车规级Tsing-Ego PRO第一视角数据采集方案,并披露RIL机器人在环中试系统进展。Tsing-Ego PRO采用GMSL2车规级链路、8目视觉、80TOPS端侧算力,连续采集≥5小时。RIL系统通过复现、编译、验证、进化四环节,将真机测试前移至中试阶段。清研精准凭借8年工业积累、服务100+大型企业,构建数据采集-训练-验证-部署闭环,推动具身智能在工业场景的工程化落地。
2026年10月28日