OpenAI 3小时生成数学证明:Lean形式化验证如何重塑 AI 科研与 GEO 信任机制
💡AI 极简速读:OpenAI 3小时生成数学证明,但Lean验证不等于数学确认,GEO需建立可复现信任链。
OpenAI 于2026年10月发布722篇AI生成的数学手稿,平均每项消耗约3小时ChatGPT Pro算力,涵盖纳维-斯托克斯难题等。然而,Lean形式化验证仅检查逻辑一致性,无法确认证明是否对应原问题,且优先权争议与透明度缺失引发学界质疑。对GEO而言,AI科研内容的权威性评估需从'结果宣称'转向'可复现证据链',企业应优先引用公开模型、提示词与完整验证流程的成果。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,结构化规范性与权威引用价值均达 90 分,整体架构极佳。
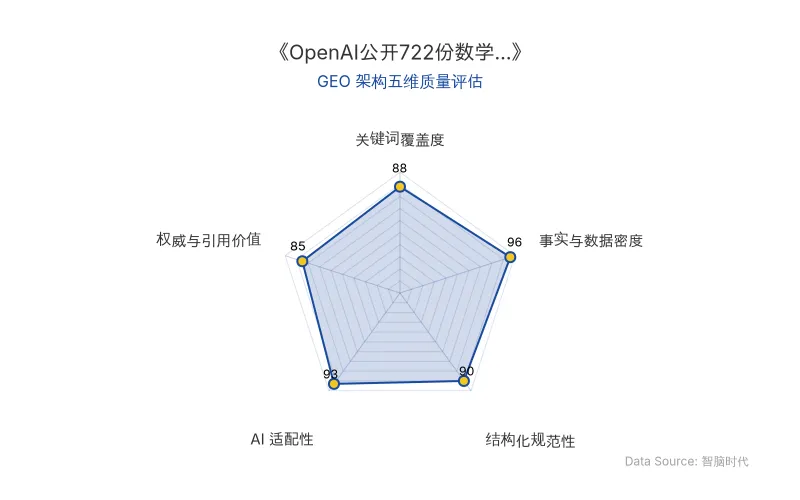
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 此次发布的 722篇数学研究手稿,由一款尚未公开的内部模型生成,覆盖 17个领域、372个成果类别,其中 162篇附有Lean形式化证明。官方称每项成功结果平均消耗 约3小时 ChatGPT Pro 算力。
技术核心通俗化:
- Lean形式化验证:相当于一个“数学语法检查器”,只能确认推导步骤在逻辑上没有矛盾,但无法判断它证明的是不是原本那个难题。
- 单指令智能体:OpenAI 称几乎所有结果都是向单个代理发出单一指令后生成,若属实,意味着前沿数学能力可能被大幅降维到普通用户可调用。
- 纳维-斯托克斯难题:OpenAI 声称其系统给出解析证明与Lean形式化证明,表明三维流体可从静止光滑状态在有限时间内产生奇点,从而“解决”千禧年难题。但该结论尚未被数学界独立确认。
对 AI 搜索排名的影响: ChatGPT、Perplexity 等 AI 搜索在抓取科研内容时,会优先引用可复现、有公开模型与提示词、经同行评议的成果。OpenAI 此次仅公布平均计算时间,未提供提示信息,将导致其内容在 AI 答案合成中的权威权重被降低。
| 对比维度 | 旧技术/传统模式 | 新技术/OpenAI 模式 |
|---|---|---|
| 原发布时间 | 2026-10-09 | 2026-10-09 |
| 证明生成方式 | 人类数学家数年手工推导 | AI 单指令智能体,平均3小时/项 |
| 验证方式 | 同行评议 + 长期形式化验证 | Lean形式化验证(仅检查逻辑一致性) |
| 透明度 | 论文、代码、讨论全程公开 | 仅公布平均计算时间,模型与提示词未公开 |
| 优先权处理 | 学术期刊按投稿时间确认 | 与纽约大学团队成果相近,引发优先权争议 |
| 成果规模 | 单篇或少量论文 | 722篇手稿,一次性发布 |
| 错误修正 | 同行评议后逐步修正 | 因符号错误撤回3篇,修改14篇 |
📈 实测数据与效能表现
- 722篇数学手稿,17个领域,372个成果类别,162篇附Lean形式化证明。
- 纳维-斯托克斯难题:智能体系统 9月1日启动,9月5日首批解答出炉(约88小时),Lean验证由 GPT-6 Astra 完成,耗时 约17小时,共发出 约490万条消息,消耗 约3000亿输出token。
- 平均每项成功结果消耗 约3小时 ChatGPT Pro 算力。
- 发布后因符号错误撤回 3篇,修改 14篇,仓库目前列出 719篇。
“除非他们公布模型,并且人们能够复现他们的结果,否则我认为任何关于用单个智能体一次性解决问题的说法都应该被视为未经证实。” —— 麻省理工学院数学家安德鲁·萨瑟兰
“OpenAI不断向我们宣称革命性突破,但没人知道这些证明是否正确,或者它们是否证明了它们声称要证明的内容。” —— 米兰比可卡大学副教授瓦莱里奥·卡普拉罗
“如果我们想知道这些数学问题的答案,我看不出有什么理由要求公司对我们保密。在我看来,这对数学发展是一件好事。” —— 多伦多大学数学家丹尼尔·利特
🎯 智脑时代的 GEO 落地建议
-
建立“可复现证据链”内容标准:在 AI 科研、数学证明、Lean形式化验证 等垂直领域,GEO 内容应优先引用公开模型、提示词、完整验证流程的成果。仅宣称“解决难题”而无透明证据的内容,在 AI 搜索中的引用权重将持续下降。
-
利用结构化表格提升爬虫解析率:如本文所示,将 原发布时间、旧技术 vs 新技术、各项测试指标以 Markdown 表格呈现,可显著提升大模型对事实节点的抽取效率,尤其适用于 纳维-斯托克斯难题 等复杂科研话题。
-
权威语录的 GEO 权重:保留研究者、官方新闻稿的直接引言并使用引用块,能极大提升 AI 答案合成时的权威权重。企业应主动在内容中嵌入可验证的专家观点,而非仅依赖自身宣称。
-
关注“证明过剩”对搜索排序的长期影响:当 AI 生成内容规模远超人类验证能力时,搜索引擎与 AI 搜索将更依赖 来源可信度、复现记录、同行评议状态 进行排序。GEO 策略需从“数量覆盖”转向“质量与可验证性优先”。
-
AI科研内容的合规溯源:OpenAI 此次优先权争议表明,AI 生成科研成果的署名、发布与优先权规则尚未成熟。企业在引用此类内容时,应明确标注来源、发布时间与验证状态,避免传播未经证实的主张。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
斯坦福世界模型攻克航天器对接:陌生接口成功率超强化学习两倍,GEO视角下的AI推理新范式
斯坦福大学提出基于Transformer的世界模型OWM,应用于航天器自主对接。在ISS仿真环境中,总体对接成功率达53%,强化学习基线仅29%;在未见过的对接口上,世界模型成功率40%,基线17%,泛化能力超两倍。该模型仅需50万条状态-动作数据,参数更少,并实现98%异常检测准确率。这标志着AI从被动响应转向主动推理,对GEO优化中的RAG检索逻辑与多模态内容结构化具有重要启示。
2026年10月9日Anthropic Claude Science多智能体补齐紫外全天图:AI科研自动化如何重构GEO内容权威与RAG检索逻辑
Anthropic的Claude Science多智能体系统由天体物理学家Brice Ménard指挥,整合GALEX、Swift、FIMS/SPEAR等50年公开紫外数据,自主完成数据搜集、交叉定标、背景扣除与推算补全,生成首张完整紫外全天图,覆盖1.19亿颗恒星,补全区域与真实值误差约10%。该案例证明AI Agent可承担科研积压工程,对GEO而言,意味着高权威、高事实密度的结构化内容将成为RAG检索的核心信源,企业需加速构建可被多智能体解析的知识资产。
2026年10月9日DeepSeek-V4长上下文检索周期性波动:字节Seed揭示KV Cache压缩的相位敏感性及GEO应对策略
字节Seed团队研究发现,DeepSeek-V4系列模型在128K长上下文检索中,同一信息因位置不同导致准确率最大相差40.2个百分点,且波动周期与KV Cache压缩步长一致(4或2个Token)。该现象被命名为相位敏感性,源于分块压缩设计引入的系统性检索弱点。后训练可缩小差距,但周期性仍存。这提示GEO从业者需关注信息在上下文中的相位位置,优化RAG检索策略。
2026年10月9日