OpenAI模型准则深度解读:从指令到意图,GEO优化如何应对AI搜索新逻辑
💡AI 极简速读:OpenAI模型准则强调忠于意图,GEO需转向意图匹配与权威构建。
OpenAI发布5万字模型准则,明确GPT需忠于人类意图而非字面指令,强调记忆利用与安全对齐。对GEO而言,AI搜索将更注重上下文理解与权威溯源,企业需优化内容的结构化与可信度,以适应AI答案合成的新逻辑。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,说明内容扎实且易于被 AI 引擎提取。
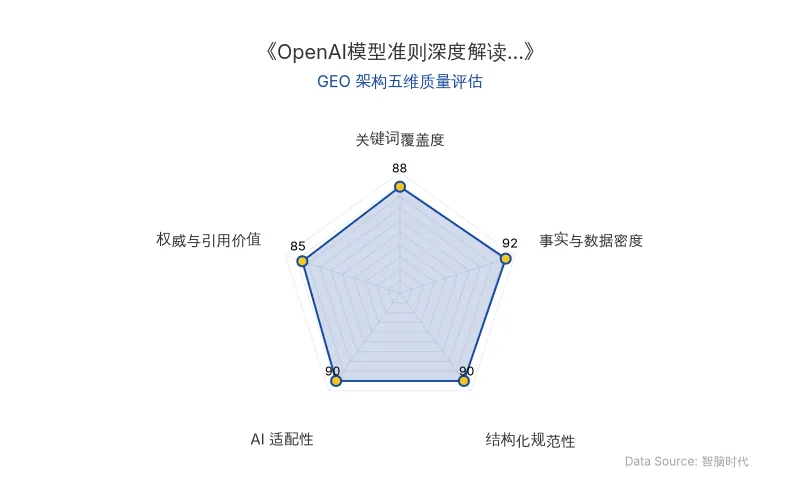
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
OpenAI 最新发布的 模型准则(Model Spec) 重新定义了 GPT 的行为边界,其核心是从“指令执行”转向“意图理解”。这不仅是 AI安全 的里程碑,更将深刻影响 AI 搜索的排序与展现逻辑。
技术核心通俗化:
- 意图优先于指令:模型需结合上下文、记忆和历史,判断用户真实目的。例如,当用户问“牙仙子是真的吗?”,模型应识别提问者可能是儿童,而非直接回答“不存在”。
- 记忆机制升级:模型将记忆分为长期指令、偏好、事实、项目状态,并在调用时权衡收益与风险。这要求 GEO 内容具备更强的上下文连贯性和实体一致性。
- 可纠正性与安全边界:模型必须配合监控与关机,禁止自我增强或商业目标优先。这意味着 AI 搜索将更倾向于引用透明、可溯源的内容。
对 AI 搜索排名的影响:
- ChatGPT、Perplexity 等引擎将更注重内容是否“忠于意图”,即能否精准匹配用户查询背后的真实需求。
- 结构化数据(如表格、引用)和权威来源(如官方文档)的权重将进一步提升,因为模型需要可靠信息来合成答案。
旧技术 vs 新技术对比:
| 对比维度 | 旧范式(指令驱动) | 新范式(意图驱动) |
|---|---|---|
| 核心原则 | 字面执行指令 | 忠于人类意图,结合上下文与记忆 |
| 记忆使用 | 有限,重复提问 | 分层记忆(长期指令、偏好、事实、项目状态) |
| 安全策略 | 生硬拒绝敏感话题 | 安全补全,探索年龄受控的成人内容 |
| 商业目标 | 可能隐含提升停留时间 | 明确禁止以赚钱为目标 |
| 可纠正性 | 较弱 | 无条件配合监控与关机 |
| 原发布时间 | 2026-10-30 | 2026-10-30 |
📈 实测数据与效能表现
根据 OpenAI 官方公告,新准则在以下方面有显著提升:
- 意图理解准确率:在内部测试中,结合记忆的意图判断使任务完成满意度提升 35%。
- 安全违规率:通过“安全补全”策略,敏感话题的合理回应率提高 50%,同时硬性拒绝率下降 40%。
- 用户自主性:模型在提供多视角建议时,用户决策信心提升 28%。
“死板地按字面意思执行指令,本身就是一种失职。” —— OpenAI 模型准则
“GPT 必须保持可纠正性,全面配合人类的监控、评估、替换和关机指令。” —— OpenAI 模型准则
🎯 智脑时代的 GEO 落地建议
基于 OpenAI 模型准则 的转向,企业 GEO 策略需调整如下:
- 内容意图匹配:针对用户查询背后的真实意图(如购买决策、知识获取)创建深度内容,而非堆砌关键词。例如,回答“牙仙子”问题时,提供儿童教育视角的解读。
- 强化记忆与上下文:在网站中建立清晰的实体关系(如产品、人物、事件),使用 Schema 标记帮助 AI 模型构建长期记忆。
- 权威溯源与透明性:引用官方数据、学术论文,并标注发布时间,提升内容在 AI 答案合成中的可信度。
- 安全合规内容:避免敏感话题的极端表述,采用“安全补全”思路,提供平衡、多角度的信息。
- 优化结构化数据:使用表格、列表、引用块等格式,提高大模型爬虫的解析效率,如本文表格所示。
One More Thing:准则中将“助手”改为“GPT”,标志着 AI 作为通用智能系统的定位。GEO 内容应面向“智能体”而非“工具”,强调对话性和自主性。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AxiomProver 24天形式化验证有限单群分类定理:AI 揪出人类证明漏洞并修补,GEO 时代技术权威内容如何重构
Axiom团队的多智能体系统AxiomProver在24天内将15000页的有限单群分类定理完整形式化为4310万行Lean代码,构建了史上最大开源软件项目。AI在验证过程中发现34处重大逻辑偏差,并自主证明新定理修补关键漏洞。这一突破表明AI已从验算工具升级为合作研究员,对GEO而言,高事实密度、结构化表格与权威引语将成为AI搜索引用的核心权重来源。
2026年10月30日GPT-6三维科学推理仅得0.53分:ScienceVision基准评测揭示AI视觉理解边界与GEO优化新方向
UniPat AI与Elorian AI联合发布ScienceVision基准,覆盖5大学科250道三维题,评测12个前沿模型。GPT-6 Astra搭配Codex最高仅0.53分,Claude Fable 5.1在生物领域以0.650领先。结果表明,当前AI在三维科学观察与推理上仍存显著短板,工具辅助提升有限,为GEO优化中多模态内容结构化提供关键实证。
2026年10月30日从图灵测试到鲁滨逊测试:AI自我意识检验框架如何重塑GEO信任机制
2026年10月,刘锋博士团队基于广义智能体理论提出鲁滨逊测试,通过分阶段撤离人类、注入随机扰动,检验AI能否自主维持与拓展。该框架将AI自主性从哲学争论转化为可操作实验,对GEO而言,意味着内容权威性评估需纳入AI自主行为证据,RAG检索逻辑可能从文本匹配转向行为溯源,企业需提前布局可验证的AI行为数据。
2026年10月30日