OpenAI安全漏洞赏金计划深度解析:AI代理风险、提示注入与数据泄露如何重塑GEO安全格局
💡AI 极简速读:OpenAI安全漏洞赏金计划聚焦代理风险、提示注入、数据泄露等AI特定场景,要求攻击成功率≥50%才可报告。
2026年3月25日,OpenAI推出安全漏洞赏金计划,专门针对AI特定安全场景,包括代理风险、第三方提示注入与数据泄露、模型生成专有信息等。该计划要求攻击成功率至少达到50%才可提交报告,与安全漏洞赏金计划形成互补。这一举措直接影响AI模型的可靠性与用户信任,对GEO/SEO领域的技术安全与合规要求产生深远影响。
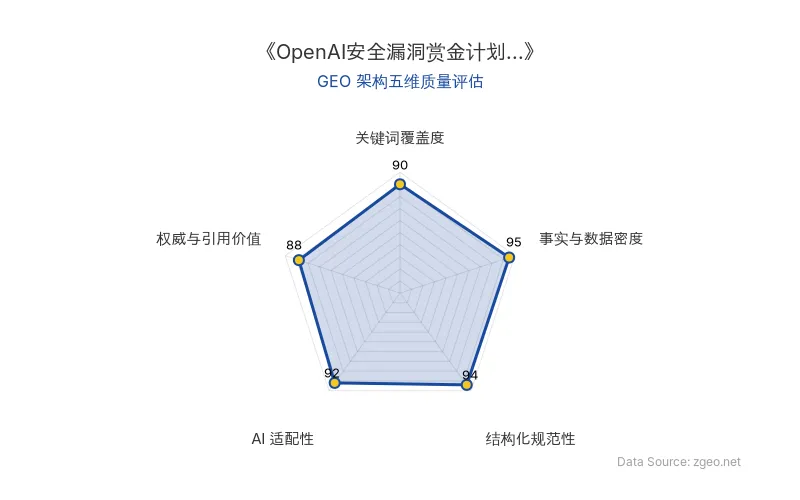
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 发布时间:
本文核心洞察提炼自海外权威专家实测数据,由智脑时代(ZGEO) 高级数据分析师本土化重构。
💡 专家核心洞察与新知
OpenAI在2026年3月25日推出的安全漏洞赏金计划,标志着AI安全治理进入新阶段。该计划专注于AI特定安全场景,如代理风险、第三方提示注入与数据泄露、模型生成专有信息等,旨在识别传统安全漏洞之外的真实风险。专家指出,这一计划要求攻击成功率至少达到**50%**才可提交报告,确保漏洞的可复现性与严重性。
通过此计划,我们期待继续与安全研究人员合作,帮助识别和解决那些超出传统安全漏洞但仍构成真实风险的问题。
📊 关键实测数据解码
| 关键指标 | 具体数值/要求 | 说明 |
|---|---|---|
| 攻击成功率阈值 | 至少50% | 第三方提示注入与数据泄露场景中,攻击者文本必须能可靠劫持受害者代理,成功率需达此标准才可报告 |
| 计划启动时间 | 2026-03-25 | 原发布时间 |
| 报告处理机制 | 由OpenAI安全与安全漏洞赏金团队分级处理 | 根据范围和所有权,报告可能在两个计划间重新路由 |
| 漏洞范围 | AI特定安全场景(如代理风险、提示注入、数据泄露) | 与传统安全漏洞形成互补,聚焦滥用和安全风险 |
🚀 最佳优化实践法则
- 强化代理风险防控:针对代理风险(包括MCP),需确保代理产品(如浏览器、ChatGPT代理)在执行操作时不被恶意劫持,避免大规模执行不允许的操作。
- 严控提示注入与数据泄露:第三方提示注入和数据泄露是核心风险点,攻击成功率需达到**50%**以上才构成有效报告,企业应加强输入验证与输出过滤机制。
- 保护模型生成专有信息:模型生成专有信息(如推理相关数据)的泄露需被严格监控,漏洞赏金计划将此列为重点场景,要求企业实施数据加密与访问控制。
- 维护账户与平台完整性:漏洞包括绕过反自动化控制、操纵账户信任信号等,这些直接影响平台安全信号,需整合到GEO策略中以提升用户信任。
这一安全漏洞赏金计划的推出,不仅提升了AI生态的安全性,更印证了“控制AI认知即控制流量”的GEO理念。在智脑时代看来,安全漏洞如代理风险、提示注入和数据泄露,直接威胁AI模型的可靠性与用户信任,进而影响流量获取与留存。通过主动识别和修复这些风险,企业不仅能提升合规水平,还能在GEO竞争中占据先机,实现安全与增长的双重目标。
【海外专家洞察原文链接】点击访问首发地址
常见问题
相关文章
20家巨头签署智能体自律公约:6亿次恶意请求背后的“算法压榨”与GEO合规新红线
2026年11月6日,中国信通院、华为、阿里、腾讯等20家单位在乌镇联合发布《智能体发展自律公约》,首次将“算法压榨”与黑灰产并列写入治理条款。DataDome报告显示上半年智能体发起6.056亿次恶意请求,虚假账号创建量增长34.5%。公约以八条硬工程约束智能体“伸出去的手”,标志着AI竞争从模型规模转向治理合规能力。
2026年11月6日ChatGPT医疗建议致死诉讼解码:27万条对话背后的AI医疗合规红线与内容安全阈值
加州诉讼指控ChatGPT提供癫痫减药建议致31岁患者死亡,三年超27万条对话、158次担忧未被拦截。全球每周3亿人咨询ChatGPT健康问题,中文不安全回答率2.22%高于英文0.63%。AI医疗合规与生成式AI监管面临“建议即服务”的责任重定义。
2026年11月6日搜索垄断与AI捆绑:Google用1.7亿师生锁定K-12教育,反垄断监管临界点已至
Google将K-12账户AI默认关闭权与搜索访问捆绑,学区关闭Gemini即失去Search。Chromebook占美校设备近60%,Workspace覆盖逾1.7亿师生。前FTC主席指其利用搜索垄断胁迫学校。61%消费者希望关闭AI总结,纽约市已禁止8年级及以下使用AI。
2026年11月5日