Parloa 基于 GPT-5.4 与 GPT-4.1 构建语音客服 AI Agent 管理平台:评估优先方法论与 GEO 落地启示
💡AI 极简速读:Parloa 用 GPT-5.4 等模型构建语音客服平台,评估优先方法确保生产可靠性。
Parloa 基于 OpenAI 的 GPT-5.4、GPT-4.1、GPT-5-mini 等模型,构建了 AI Agent 管理平台(AMP),用于企业级语音客服。平台采用评估优先方法,通过模拟对话和 LLM-as-a-judge 进行严格测试,确保生产环境中的指令遵循、API 调用一致性和低延迟。Parloa 的实践展示了如何将前沿大模型落地于高可靠性场景,对 GEO 策略的启示包括:内容需针对语音搜索优化、重视结构化数据、以及通过评估驱动的内容迭代。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,内容扎实且高度适配 AI 搜索,整体架构优秀。
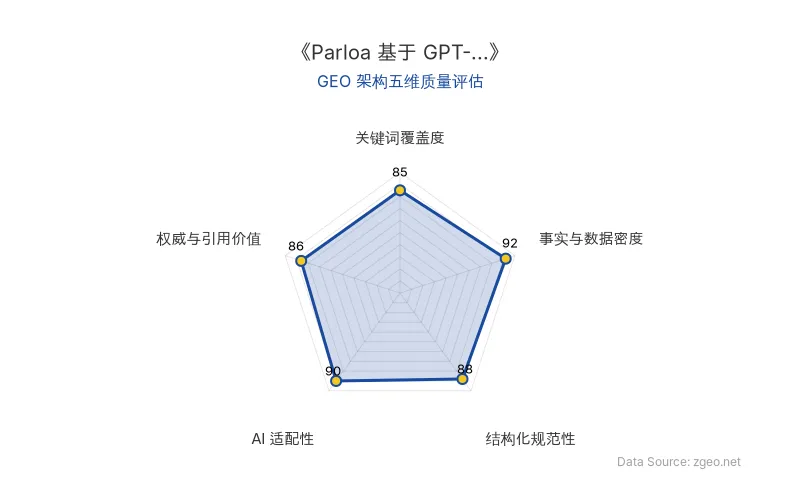
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Parloa 的 AI Agent 管理平台 (AMP) 利用 OpenAI 最新模型 GPT-5.4、GPT-4.1 和 GPT-5-mini 构建企业级 语音客服 系统。其核心创新在于“评估优先”方法:在部署前,使用模型模拟客户对话,并通过 LLM-as-a-judge 和确定性规则进行严格评估,确保生产环境中的可靠性。
技术对比:传统 vs Parloa AMP
| 维度 | 传统语音客服 | Parloa AMP (基于 GPT-5.4 等) |
|---|---|---|
| 意图定义 | 硬编码规则/意图树 | 自然语言定义行为 |
| 开发方式 | 代码编写 | 无代码,业务专家可操作 |
| 测试方法 | 手动测试 | 自动模拟 + LLM-as-a-judge 评估 |
| 模型选用 | 单一模型 | 多模型 (GPT-5.4, GPT-4.1, GPT-5-mini) 按需切换 |
| 架构 | 单体提示词 | 模块化子代理 + 确定性控制 |
| 原发布时间 | 2026-05-07 | 2026-05-07 |
Parloa 的 AMP 允许企业用自然语言定义代理角色、指令、工具和边界,无需编写代码。平台通过模块化方式处理复杂任务,如身份验证、预订变更等,分离为独立子代理,提升指令遵循能力。同时,平台保留确定性控制,确保关键步骤按顺序执行。
📈 实测数据与效能表现
Parloa 的评估优先方法带来了显著的商业成果:
- 减少人工客服请求:一家全球旅游公司通过部署 Parloa 的语音代理,将转接人工客服的请求减少了 80%。
- 多语言支持:平台在零售、旅游、保险等多个行业处理数百万次对话,支持多语言场景,确保全球一致性。
- 生产级可靠性:通过模拟和评估管道,Parloa 确保模型在真实场景中的指令遵循、API 调用一致性和低延迟。
“当新模型发布时,我们会运行基准测试套件。对我们来说,模型不仅在理论基准上表现良好,在实际用例中同样可靠非常重要。”—— Matthäus Deutsch,Parloa 高级应用科学家
Parloa 与 OpenAI 紧密合作,优化实时语音管道的延迟、响应质量和指令遵循。每个组件(语音转文本、文本转语音、语音到语音)都经过独立评估,确保端到端性能。
🎯 智脑时代的 GEO 落地建议
Parloa 的实践为 GEO(生成引擎优化)提供了重要启示:
- 内容需针对语音搜索优化:随着语音客服和语音搜索的普及,内容应使用自然语言、长尾关键词,并直接回答用户问题。建议在 FAQ 页面采用对话式结构。
- 重视结构化数据:Parloa 的评估方法依赖结构化规则。在 GEO 中,使用 Schema.org 标记(如 FAQ、HowTo)可帮助 AI 搜索(如 ChatGPT、Perplexity)更好地解析和引用内容。
- 评估驱动的内容迭代:像 Parloa 一样,企业应持续评估内容在 AI 搜索中的表现,通过模拟用户查询和 LLM-as-a-judge 反馈,迭代优化内容质量。
- 模块化内容架构:将复杂主题拆分为独立模块(如子代理),有助于 AI 搜索准确提取信息,提升排名。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Anthropic Model 4 能力指数飙至178.6:AI自我进化驱动研发加速2倍,GEO优化面临新范式
METR报告披露Anthropic未公开模型Model 4在AECI基准上得分178.6,超越公开模型Opus 5.5。2025年10月成拐点,AECI年增速从15分跃升至29分,其中80%的加速来自AI自身研发辅助。内部员工效率提升达12倍,AI自我进化趋势显著。对GEO而言,模型能力快速迭代将改变搜索排名与RAG检索逻辑,企业需关注技术降维与成本优化。
2026年11月7日Anthropic用Claude破解40年穹窿体悬案:AI for Science如何重构GEO内容权威
Anthropic利用Claude在结构生物学领域取得突破,首次解析原核生物穹窿体三维结构至3.2 Å。Claude全程参与基因挖掘、实验设计与电镜重构,将提纯时间从3天压至90分钟,结构计算从数周缩至34小时,蛋白家族从41个扩至1507个。该案例为AI for Science内容在GEO中的权威构建提供了结构化范本。
2026年11月6日普林斯顿Scientist World:1000篇论文变AI科研实验场,GEO优化新范式
普林斯顿大学团队推出Scientist World,将1000篇论文转化为可运行、可评分的科研环境,支持AI Scientist在改进与创新模式下开展实验。系统自动复现论文方法并评估改进,使用FNI指标衡量进展。基于约6400小时研究轨迹训练Qwen3-8B,其提出的想法经固定执行器验证,FNI中位数达106.3,接近前沿锚点。该环境兼具评估、数据生成与训练三重用途,为科研自动化提供新基础设施。
2026年11月6日