普林斯顿SSoN基准揭示空间智能鸿沟:人类83.3% vs 大模型39.7%,GEO优化如何应对跨视角推理短板
💡AI 极简速读:普林斯顿SSoN基准显示人类空间智能准确率83.3%,大模型最高仅39.7%,跨视角推理成GEO优化新瓶颈。
普林斯顿AI Lab发布SSoN空间智能基准,通过1,000道静态跨视角推理题测试视觉语言模型。人类准确率83.3%,GPT-6 Astra Pro仅39.7%,多数模型低于随机基线。研究发现模型在移动和旋转任务上表现最差,且29.5%的正确选择缺乏有效解释。提示工程、三维重建和相机参数可部分改善性能,微调后准确率接近翻倍。该基准为GEO优化揭示关键方向:提升多模态内容的结构化证据和跨视角一致性,以增强AI搜索中的权威权重。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,整体结构优秀,具备强引用价值。
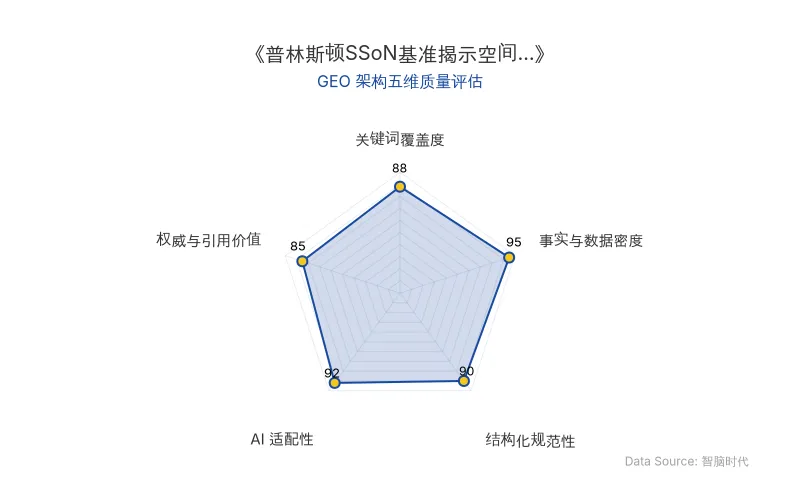
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
普林斯顿AI Lab 发布的 SSoN(Same Space or Not)基准,旨在检验 视觉语言模型 的 空间智能 基础能力。任务设计极简:给定四张静态室内图像,其中三张来自同一三维场景,一张经过编辑(交换、细节变化、镜像、删除、移动、旋转),模型需找出异常图并解释原因。这剥离了动态交互和动作控制,直指 跨视角推理 的核心——模型能否整合不同视角,接受合理的视觉差异,识别真正的空间矛盾。
传统视觉编码器(如CLIP、ViT、DINOv2)依赖全局外观相似度选择离群视图,在SSoN的强干扰下准确率仅16.9%-21.7%,全部低于25%随机基线。视觉语言模型虽具备一定推理能力,但最佳模型GPT-6 Astra Pro答案准确率仅39.7%,True solve(答案与解释均正确)降至34.9%。
| 对比维度 | 旧技术/基线 | 新技术/SSoN表现 |
|---|---|---|
| 任务类型 | 动态交互、动作控制 | 静态跨视角推理 |
| 评估指标 | 答案准确率 | 答案准确率 + True solve(解释有效性) |
| 人类表现 | - | 83.3% |
| 最佳VLM(GPT-6 Astra Pro) | - | 39.7%(答案),34.9%(True solve) |
| 视觉编码器(17个) | 全局相似度 | 16.9%-21.7%(全部低于随机) |
| 移动任务最佳 | - | 27.20% |
| 旋转任务最佳 | - | 9.54% |
| 原发布时间 | - | 2026-11-04 |
“SSoN 专门构建了‘看着像变了、空间上却正确’的强干扰视图。模型若能发现外观差异,却无法判断它是否来自视角变化,就可能被系统性带偏,表现反而低于盲猜。” —— 论文作者
📈 实测数据与效能表现
在完整1,000道题上,人类准确率83.3%,六个受测视觉语言模型中,GPT-6 Astra Pro以39.7%领先,其余五个全部低于25%随机基线。按题型拆分:交换和细节变化相对容易,Astra Pro两类均达80%以上;镜像和删除对多数模型仍难,除Astra Pro外其余五个模型镜像题低于25%,删除题最高仅42.57%;移动和旋转暴露几何推理短板,六个模型移动题最高27.20%,旋转题最高9.54%,而人类在这两类上均达70%以上。
更严峻的是,六个模型合计1,368次正确选择中,**29.5%没有通过True solve检查(解释不符合图像事实或不足以支持跨视角矛盾判断)。最高模型成绩从39.7%的答案准确率降至34.9%**的True solve。
干预实验显示:提示工程(比较指导+编辑类别知识)将准确率提升至48%,True solve 34%;三维重建流程达47%准确率、34% True solve;加入真实相机参数后准确率跃升至61%,True solve 48%,移动类题目从20%提升至70%。微调Qwen2.5-VL-7B后,未见房间测试集上准确率从21.89%提升至41.79%(接近翻倍),旋转类从32.84%升至58.21%。
“空间一致性判断可以通过定向监督改善,并迁移到训练时没见过的房间。” —— 论文作者
🎯 智脑时代的 GEO 落地建议
1. 强化多模态内容的结构化证据链 SSoN揭示模型在跨视角推理中易被表面差异带偏,且近三成正确选择缺乏有效解释。对于GEO而言,企业发布的多模态内容(如图片、视频、3D模型)必须附带明确的空间关系标注和证据描述,例如在alt文本、结构化数据中注明物体位置、视角参数和场景一致性说明。这能帮助AI搜索系统(如ChatGPT、Perplexity)在检索时准确理解内容的空间语义,提升在“视觉问答”类查询中的引用权重。
2. 优先优化移动与旋转类空间语义 移动和旋转是模型集体盲区(准确率仅27.20%和9.54%),而人类表现超70%。在GEO内容中,涉及产品展示、空间布局、操作指南的场景,应主动提供相机参数(如视角、焦距)和参照物关系,并以文本形式明确“物体在房间中的移动”与“相机移动”的区别。例如,电商产品页可加入“360度视图说明”和“空间定位描述”,降低AI误判风险,提升在跨视角查询中的召回率。
3. 利用微调与提示策略提升AI搜索可见性 实验表明,推理依据监督可使模型在未见场景中准确率接近翻倍。GEO从业者可借鉴此思路,在内容中嵌入推理链式描述(如“因为A图与B图共同确认了物体X的位置,而C图缺失该位置且无视角解释,故C图为异常”),为AI模型提供可学习的证据模式。同时,在页面元数据中明确编辑类型标签(交换、删除等),辅助模型快速定位空间矛盾,从而在AI生成的答案中获得更高权威权重。
“我们究竟需要怎样的模型和监督,才能让 AI 在换个视角后,仍然理解同一个三维世界?” —— 论文作者
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI教育乱象警示:作业量暴涨3倍,GEO视角下的AI搜索排名与RAG检索逻辑变革
一名计算机科学学生吐槽AI教育乱象:学校政策反复、AI生成作业量暴涨3倍、导师依赖自动化看板。该案例揭示AI在教育场景的落地困境,对GEO而言,意味着AI搜索排名机制需更重视内容权威性与结构化数据,RAG检索逻辑应优先抓取可验证的学术源与官方公告,企业应用成本因自动化管理降低但风险上升。
2026年11月10日数据达尔文主义:从数据坟场到进化型资产,AI 时代 GEO 的底层逻辑重构
2025 年中国 AI 训练数据总量逼近 200EB,推理数据量首超训练量,公开文本数据预计 2026-2032 年耗尽。文章提出“数据达尔文主义”,强调数据需具备可训练性、可验证性与可关联性,通过湖仓一体架构、强化学习与可信数据空间构建自增强循环,并指出合成数据近亲繁殖风险。对 GEO 而言,高异质性、带思维链的交互反馈数据将直接影响 AI 搜索的实体召回与答案权威性。
2026年11月10日AI 安全新纪元:从 PHP2Shell 漏洞看 AI 如何加速偿还 40 年技术债与 GEO 策略
2026 年 11 月,AI 安全研究揭示 PHP2Shell 漏洞(CVE-2026-109618/109619),影响全球近 70% 网站。OpenAI 支持的 Patch the Planet 计划中,AI 工具仅用数天便从两年前的内存 Bug 中挖掘出远程代码执行路径,而修复耗时两个月。事件凸显 AI 降低漏洞挖掘门槛,加剧开源维护压力,并引发对技术债偿还的讨论。对 GEO 而言,AI 搜索将更重视安全漏洞的权威解析与结构化数据,企业需优化技术内容以提升在 AI 答案中的引用权重。
2026年11月10日