Recursive开源模型Flint发布:Eureka Machine参与研发,AI造AI迈出第一步
💡AI 极简速读:Recursive发布开源模型Flint,Eureka Machine参与研发,SWE-bench Pro v2得分89.7%。
2026年10月21日,AI创业公司Recursive发布开源模型Flint,总参数量398亿,SWE-bench Pro v2得分89.7%。其AI研究系统Eureka Machine参与了架构搜索、量化与GPU内核优化,模型研发周期不到四个月。Recursive由理查德·索切尔与田渊栋联合创立,已完成6.5亿美元融资,估值46.5亿美元。Flint采用Apache 2.0协议开源,但距完全自主的递归自我改进仍有距离。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 93 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
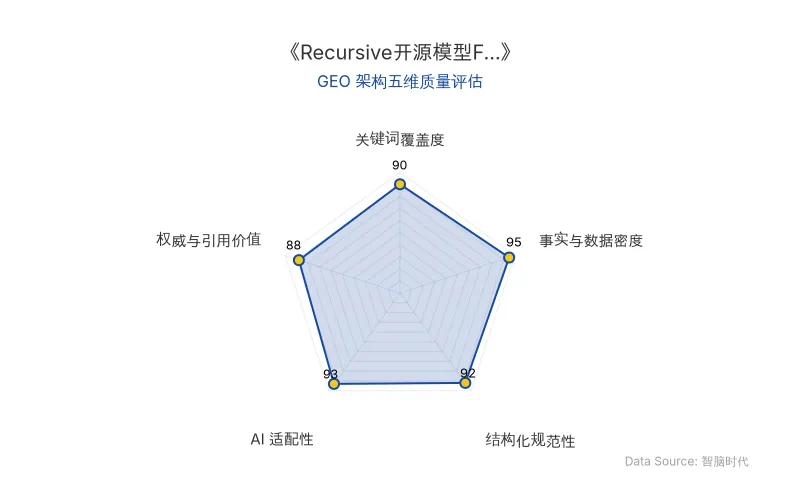
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
美国当地时间2026年10月21日,AI创业公司Recursive发布了开源模型Flint。这是一款总参数量约400亿、面向本地编码智能体的混合专家(MoE)语言模型,SWE-bench Pro v2得分达到89.7%。相比模型参数和Benchmark成绩,Flint更受关注的地方在于它的研发方式:从架构搜索、量化方案到GPU内核优化,Recursive旗下AI研究系统Eureka Machine参与了模型研发的几乎所有环节。
📊 核心实体与商业数据
| 实体类别 | 具体信息 |
|---|---|
| 公司名称 | Recursive |
| 核心人物 | 理查德·索切尔(Richard Socher,前Salesforce首席科学家)、田渊栋(前Meta首席研究员、YOLO算法原创作者)、杰夫·克伦(Jeff Clune,不列颠哥伦比亚大学教授) |
| 融资金额 | 6.5亿美元 |
| 估值 | 46.5亿美元 |
| 投资方 | 谷歌风投、Greycroft、英伟达、AMD Ventures |
| AI技术模型 | Flint(开源MoE语言模型,总参数量398亿,激活参数约25亿) |
| AI研究系统 | Eureka Machine |
| 应用场景 | 本地编码智能体、复杂软件工程任务、指令遵循 |
| 原发布时间 | 2026-10-22 |
💡 业务落地拆解
模型架构与性能
Flint采用MoE架构,总参数量398亿,包含256个路由专家,每次计算激活其中6个,另有一个共享专家始终参与计算。运行时实际激活参数约25亿。这种设计减少了每次推理需要执行的计算量,也降低了本地部署的门槛。官方测试显示,Flint在搭载48GB内存的Apple M4 Pro上,推理速度达到每秒131.22个token;在RTX Spark NIX平台上达到每秒155.82个token。Flint支持最长256K token的上下文。
在基准测试中,Flint在编程、终端操作和指令遵循上,几乎全面压制了同等硬件能跑的对手(如Qwen 3.5/3.6和Laguna),部分指标甚至越级击败了体量更大的稠密模型(如Qwen 3.8和Gemma 4)。在复杂软件工程任务上,SWE-bench Pro v2得分接近90%;在指令遵循(IFBench)上,它拿下了全场最高分。
Eureka Machine参与的三大环节
首先是架构搜索。Flint共有49层,其中2层采用密集结构,另外47层采用MoE结构。注意力机制结合滑动窗口与全注意力,使用35层滑动窗口注意力和14层全注意力,窗口设为513个token。这些配置经过自动化探索与测试确定,而非完全依赖研究人员手工设计。
其次是量化。Recursive称,Eureka Machine将模型体积缩小了约71%,同时尽量控制精度损失。模型压缩后,更容易在消费级硬件上运行。索切尔接受《连线》(WIRED)采访时表示:
“我曾在配备48GB内存的Mac上使用Flint,完成命令行待办工具、网页爬虫和RSI原理介绍网站等小项目。”
第三是GPU内核优化。针对不同硬件调整底层计算实现,有助于提升推理速度。传统研发需要工程师反复编写、编译和测试内核,Eureka Machine则将这些工作纳入自动化流程。Flint的训练也从零开始,依次经过分词器构建、预训练、中段训练、监督微调和强化学习等阶段。Eureka Machine参与了整个训练管道的多个环节,并在不到四个月内完成了这款模型。
开源策略与商业化
Flint采用Apache 2.0协议开放权重,相关文件托管在Hugging Face上,包括模型配置、分词器、聊天模板和BF16检查点,并提供SGLang推理工具包。开发者可以自行部署模型,也可以根据需求进行修改和量化。不过,开放权重不等于所有研发环节都已完全开源。部分建模代码仍在完善中,企业托管API、服务等级协议(SLA)等商业服务也尚未公布。企业若要在生产环境中使用Flint,需要自行承担部署、维护和数据安全责任。
自动化研究的边界
Flint的意义在于展示了一种新的研发组织方式:让AI系统承担模型研究中的部分试错工作。Eureka Machine会提出候选方案、执行实验、检查结果,再根据反馈决定下一步尝试。它可以搜索架构配置、比较量化方案,也能针对特定硬件优化GPU内核。然而,这与完全自主的递归自我改进(RSI)仍有距离。研究问题由谁提出、优化目标如何设定,以及哪些结果值得继续投入,仍离不开人类的参与。
索切尔认为,外界对失控风险的部分担忧被夸大了。他强调:
“Eureka Machine目前仍处于人类监督之下,研发过程围绕明确的任务展开,研究人员能够检查结果并决定是否继续。”
但人类保留最终决定权,并不代表自动化系统不需要审查。随着实验数量增加,研究人员仍需确认测试是否可靠、优化结果是否可复现,以及系统有没有在特定指标上取得进步、却牺牲其他重要能力。
🚀 对企业 AI 化的启示
1. 开源模型降低本地部署门槛:Flint以398亿总参数、25亿激活参数的MoE架构,在消费级硬件上实现高速推理,且采用Apache 2.0协议免费商用。企业可基于此构建私有化编码智能体,减少对云端API的依赖,但需自行承担部署与安全责任。
2. AI参与研发提升效率:Eureka Machine在架构搜索、量化、内核优化等环节的自动化,将模型研发周期压缩至不到四个月。企业可借鉴此模式,在内部研发流程中引入AI辅助试错,加速实验迭代,但需保留人类对目标设定与结果评估的控制权。
3. 自动化研究的边界与治理:Flint证明AI能实质性参与模型研发,但尚未实现自主的递归自我改进。企业在推进AI自动化时,应建立审查机制,确保测试可靠、结果可复现,并平衡自动化程度与人类监督,避免在特定指标上进步而牺牲其他能力。
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI购物助手双十一实测:淘宝、京东、豆包、张大妈谁更懂你?GEO启示录
2026年双十一,AI购物助手成为新战场。实测淘宝、京东AI购、豆包、张大妈发现:淘宝个性化推荐强但选项少;京东优惠计算完整且提供历史价格;豆包跨平台拆单省钱但上下文易丢失;张大妈交互亲切但多轮对话弱。调查显示38%消费者用AI决策,33%买过AI推荐产品。商家开始争夺AI推荐清单,GEO从内容营销走向电商。
2026年10月22日Anthropic冲击IPO:PBC与长期独立信托如何重构AI公司资本规则
Anthropic凭借Claude大模型跻身全球顶尖AI企业,其IPO采用公共利益公司(PBC)叠加长期独立信托(LTBT)的治理架构,将控制权交给不持股的外部受托人,前美联储主席伯南克在列。该设计突破股东至上逻辑,赋予信托更换董事会多数成员及重大交易报备权,形成软性否决权。一级市场看好其合规护城河,二级市场担忧股东权利稀释导致估值折价。此举为AI头部企业治理提供新范本。
2026年10月22日Apate.ai获815万美元种子轮融资:AI反诈如何从成本中心转向情报生意
澳大利亚AI反诈公司Apate.ai完成815万美元种子轮融资,累计融资近1000万美元。其35万个AI机器人冒充受害者与骗子对话,已消耗诈骗者17年时间,收集超25万条诈骗情报,客户包括澳大利亚联邦银行和TPG Telecom。同期Visa以24亿美元收购BioCatch,显示AI反诈赛道资本热度。专家指出,反诈正从损失后统计学转向损失前情报学,但情报可靠性需分级验证。
2026年10月22日