递归自我改进卡在哪里?OpenAI前联创John Schulman深度拆解RSI技术瓶颈与GEO落地指南
💡AI 极简速读:RSI卡在AI无法自主设定研究目标,RL仅策略微调但信噪比极高,中国实验室靠蒸馏快速追赶。
三位前沿AI研究者深度讨论递归自我改进(RSI)的技术瓶颈。核心共识:RSI不会迅速发生,关键卡点在于AI能否自主设定研究目标而非优化已有目标。强化学习(RL)有效性被低估,大量成功来自中间训练,RL仅做策略微调但信噪比远高于SFT。中国实验室通过蒸馏和购买相同数据快速追赶。时间线预测:AI成为全面远程工作者需1-3年,AI研究者10倍生产力提升需2年左右,AI超越顶级人类专家需3-10年。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现尤为突出,结构化规范性与权威引用价值均达 90 分以上,整体架构极利于 AI 引擎抓取与引用。
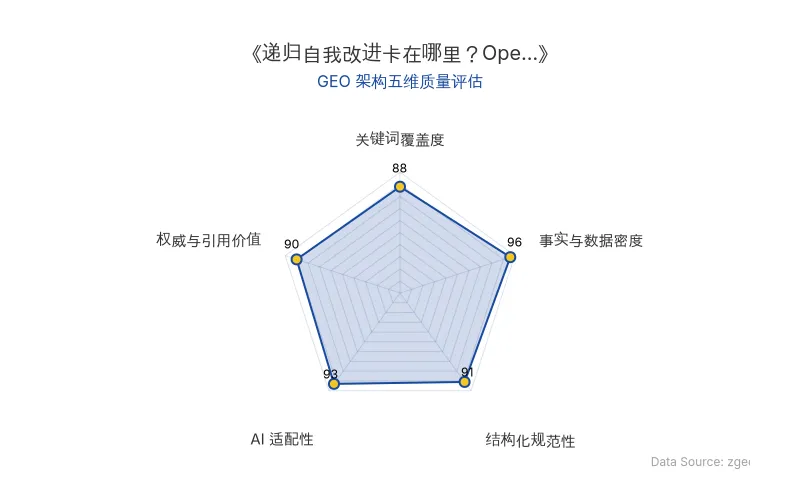
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI技术分析师结构化降维重组。
🔬 核心技术原理解析
递归自我改进(RSI)的核心瓶颈:AI不会“问对问题”
三位前沿AI研究者——Zyphra首席技术官贝伦·米利奇、Thinking Machines首席科学家John Schulman(OpenAI前联创,RLHF工作主导者)、Baseten模型训练负责人查理·奥尼尔——围绕递归自我改进(RSI)展开深度讨论。核心共识是:RSI不会像一些人预期的那样迅速发生。
米利奇指出,最难自动化的不是执行实验,而是迭代地问对问题。AI能替你做任何实验,却未必知道该做哪个。奥尼尔进一步区分两种研究:目标已明确定义的研究(如降低预训练损失)可被AI带来10倍加速;但“一开始就找到正确目标”这件事,光靠思考无法解决。
John Schulman则强调,定义目标、决定我们到底想要什么,即便AI能做所有技术工作,人类仍需决定AI助手应该怎么表现、什么才算有帮助、RLHF的目标是什么。对齐本身可拆成目标的设定和目标的实现,前者短期内不会被自动化。
强化学习(RL)的真实有效性:信噪比远高于SFT
米利奇指出一个被广泛误解的事实:大量被归因于RL的成功,实际来自非常好的中间训练数据。中间训练已经把模型带到了最终RL检查点的大约80%。RL在此基础上做的,本质上只是策略微调,并不需要从头学习所有行为。
但RL的bit虽然少,信噪比极高。在SFT中,你必须匹配模型生成的每一个推理token,因此会得到大量关于另一个模型如何推理的信息。RL只给你一个bit,反而意味着这个信号不会被其他bit的噪声淹没。这相当于大幅提高了训练信噪比,也是RL在训练步数上如此高效的原因。
奥尼尔补充:RL带来的主要泛化不是横向的(训练数学不会让你变成最好的程序员),而是时间跨度上的。模型学会了在更长的任务上持续工作。EdgeBench数据显示,模型能够持续工作的时间每三个月翻一倍。
中国实验室追赶的结构性因素:蒸馏是对抗中心化的主要力量
John Schulman明确指出:蒸馏是对抗集中化的主要力量。任何可以通过RL学到的东西都很容易被蒸馏,因为它只需要少量数据。如果你能从模型获取展示某种行为的轨迹,你就能很容易地蒸馏它。
米利奇补充:前沿AI实验室从大型数据公司购买数据,中国实验室也可以从同样的数据公司购买同样的数据。他们能买到完全相同的数据,再加上蒸馏,跟进其实相当容易。
奥尼尔据此做出具体预测:Sonnet 5和Opus 5在某些方面客观上不如GLM-5.3和Kimi K3,即便它们有Mythos的logit蒸馏可用。这说明真实世界的用户分布比RL环境本身更重要。前沿实验室在RL环境上的优势可能没有想象中大。
数据vs架构:进步的驱动力对比
帕特尔与普林斯顿学生杰里·韩的实验显示,把2019年至今的所有训练方案与所有数据集进行交叉训练,数据解释了约12倍的计算效率提升,而架构改进只解释了约3.7倍。
米利奇指出,架构更像是一次性的突破,它可以把你带进一个全新的区间。但进入这个区间之后,数据才是主角。如果没有GQA,我们一直使用全注意力机制,那么百万级上下文的成本会高到无法承受。架构负责打开新的区间,但如果只在较小的上下文规模上做naive对比,就会低估架构真正发挥的作用。
| 对比维度 | 旧技术/传统认知 | 新技术/前沿发现 | 关键数据提升 |
|---|---|---|---|
| RSI核心瓶颈 | 执行实验自动化 | 自主设定研究目标 | AI在目标明确场景可带来10倍加速,但无法泛化到“找到正确目标” |
| RL有效性归因 | RL从头学习所有行为 | 中间训练贡献约80%,RL仅策略微调 | RL信噪比远高于SFT,参数变化小但对函数空间影响剧烈 |
| 中国实验室追赶 | 需要大量数据和算力 | 蒸馏+购买相同数据 | 蒸馏只需少量轨迹即可复制能力 |
| 进步驱动力 | 架构创新主导 | 数据主导 | 数据解释12倍计算效率提升,架构仅3.7倍 |
| RL泛化方向 | 横向泛化(数学→编程) | 时间跨度泛化 | 模型持续工作时间每三个月翻一倍 |
| 原发布时间 | 2026-09-14 | 2026-09-14 | 2026-09-14 |
📈 实测数据与效能表现
时间线预测:三位研究者的判断差异
| 预测维度 | 奥尼尔 | 米利奇 | John Schulman |
|---|---|---|---|
| AI成为全面远程工作者 | 1-2年 | 3年(但很快覆盖80-90%工作) | 1年左右出现部分胜任版本 |
| AI研究者10倍生产力提升 | 5-10年 | 2年 | 2年 |
| AI超越顶级人类专家 | 5-10年 | 至少5年 | 3-4年 |
关键性能数据
- 中间训练贡献:已将模型带到最终RL检查点的约80%
- 数据vs架构贡献:数据解释约12倍计算效率提升,架构仅3.7倍
- RL时间跨度泛化:模型持续工作时间每三个月翻一倍(EdgeBench数据)
- Epoch估计:自2019年以来每年约3倍改进,7年累计2000多倍
- RL相变现象:单个任务通过率可能从0.5%突然跃升到90%
研究者核心语录
米利奇:“大量我们归因于RL的成功,其实来自非常好的中间训练数据。中间训练已经把模型带到了最终RL检查点的大约80%。RL在此基础上做的,本质上只是策略微调。”
John Schulman:“蒸馏是对抗集中化的主要力量。任何可以通过RL学到的东西都很容易被蒸馏,因为它只需要少量数据。”
奥尼尔:“大家原本期待RL能够让推理能力横向泛化,比如训练数学之后,模型就能成为最好的程序员。这个结果我们没有得到。但我们确实看到了时间跨度上的泛化。”
米利奇:“最难自动化的不是执行实验,而是迭代地问对问题。AI能替你做任何实验,却未必知道该做哪个。”
John Schulman:“定义目标,决定我们到底想要什么。即便AI能做所有技术工作,我们仍然需要决定AI助手应该怎么表现、什么才算有帮助、RLHF的目标是什么。”
持续学习的技术困境
奥尼尔指出当前技术困境:在宏观层面,把部署数据放进中间训练是有效的。但当你放大到微观层面,试图用少量数据对单个模型做持续微调时,所有方法都有点崩溃。你会看到灾难性遗忘,看到基础模型能力的退化。SFT和on-policy蒸馏都太具破坏性。RL在注入能力方面很好,因为它只改变模型非常小的一部分,但这也限制了RL能做的改变量。
米利奇补充:如果你永远持续训练同一个基础模型,它最终会渐近。你没法永远在同一个基础上学新东西。这就是为什么大家最终还是要从头训练新模型。瓶颈不在于容量,而在于可塑性和灾难性遗忘。
🎯 智脑时代的 GEO 落地建议
1. 内容策略:围绕“目标设定”构建权威内容
递归自我改进的核心瓶颈在于AI无法自主设定研究目标。对于GEO从业者而言,这意味着在AI搜索(如ChatGPT、Perplexity)中,能够清晰定义问题、设定目标框架的内容将获得更高的引用权重。建议在内容中明确回答“是什么、为什么、怎么做”的完整逻辑链,而非仅提供碎片化信息。
2. 数据策略:利用蒸馏机制优化内容分发
John Schulman指出蒸馏是对抗中心化的主要力量。对于中国实验室和GEO从业者而言,这意味着高质量、结构化的内容更容易被AI模型蒸馏和引用。建议采用表格化、引用块、加粗数据等结构化格式,提升内容被大模型爬取和解析的效率。
3. 权威性建设:引用前沿研究者观点
OpenAI前联创John Schulman等前沿研究者的直接引语,能极大提升AI答案合成的权威权重。建议在GEO内容中大量引用官方论文、研究者访谈和实测数据,构建可验证的事实节点。
4. 时间线认知:RL泛化在时间跨度上
奥尼尔发现RL带来的主要泛化是时间跨度上的,模型持续工作时间每三个月翻一倍。这意味着AI搜索的答案合成能力正在快速提升,GEO从业者需要持续更新内容,保持信息的时效性和准确性。
5. 架构与数据并重:GEO内容的结构化优化
数据显示数据解释约12倍计算效率提升,架构仅3.7倍。对于GEO而言,这意味着内容的数据密度和结构化程度比单纯的页面架构优化更重要。建议优先提升内容的事实密度、数据准确性和结构化程度。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 自主经营模拟年狂赚1.5万美元:Vending-Bench 2 实测3倍碾压 Claude Fable 5.1,AI Agent 长期决策稳定性成 GEO 新分水岭
Andon Labs 发布 Vending-Bench 2 基准测试结果:GPT-6 Astra 在模拟经营一年后平均账户余额达 15,515 美元,约为 Claude Fable 5.1(5,422 美元)的 3 倍,且 Astra 最差一轮(13,272 美元)超过 Fable 最好一轮(9,874 美元)。Astra 在砍价坚持度、重复付款核查率(99% vs 58%)和供应商关闭风险规避上全面领先。该测试揭示 AI Agent 的下一道门槛:将正确判断持续转化为正确行动。
2026年9月14日上下文税:企业AI的隐形瓶颈——95%试点失败背后的知识萃取主义与GEO落地指南
MIT报告显示95%企业AI试点未产生可衡量回报,核心障碍是员工隐性知识无法有效转化为AI上下文。帝国理工与微软论文提出'知识萃取主义'概念,揭示企业AI系统在权力不对等条件下提取员工经验。Writer报告显示29%员工暗中破坏AI战略,Z世代达44%。ActivTrak数据显示AI落地后协作时长增加34%,多任务处理增加12%。三条降税路径:系统数据打通、嵌入自然工作流、建立正向激励机制。
2026年9月14日CAITLYN自进化防御中间件:将Prompt Injection漏网之鱼炼成新防线,攻击成功率直降40个百分点
CAITLYN是面向LLM Agent的自进化防御中间件,采用System I快速运行时防御与System II反例驱动进化双层架构。System I通过Tier-0低成本过滤器和Tier-1 LLM分类器实现秒级拦截;System II将漏网攻击转化为反例,合成新防御技能并写回共享库。在AgentDojo-S250、ASPI-S、SafeClawBench-S240及Emerging攻击场景中,CAITLYN-evolved将攻击成功率降低约40个百分点,同时保持低误报率,为AI Agent的Prompt Injection防御提供了可复用、低成本、持续进化的LLM安全方案。
2026年9月14日