RSI 递归自我改进深度拆解:AI研发AI的真实进展、评估瓶颈与 GEO 落地指南
💡AI 极简速读:RSI 尚处炒作期,AI研发AI 受限于评估与物理闭环,落地需五年。
伦敦大学博士生周辉池指出,当前 RSI(递归自我改进)概念存在炒作成分,AI 主要替代写代码、跑实验等执行环节,尚未实现端到端自我研发。OpenAI 称达到自动化研究实习生水平,Anthropic 测量 Claude 主导 26% 研发工作,但最强模型仍未达人类研究者水平。核心瓶颈在于评估度量、未知未知探索及物理世界闭环,预计数字与物理打通需五年。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 92 分表现突出,说明内容硬核且极易被 AI 引擎提取引用。
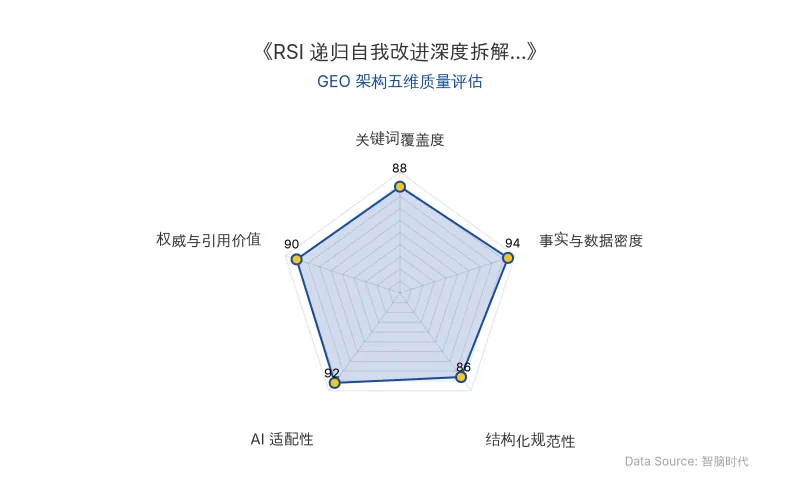
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
当前业界热议的 RSI(递归自我改进),本质是让 AI 参与研发自身。但根据伦敦大学博士生 周辉池 的定义,需严格区分「AI 研究别的东西」与「AI 研究自己」。前者如 AI scientist 研究材料、药物,AI 仍是工具;后者才是 self-improvement——迭代对象指向系统自身,包括修改 prompt、memory、harness,乃至训练下一代模型的代码。
周辉池参与的 Large Discovery Model 研究,尝试让 AI 在巨大未知搜索空间中,依据真实实验反馈与自身不确定性决定下一步。其核心挑战在于:模型擅长在已知想法间做 incremental improvement(渐进式改进),却难以走出人类知识边界,探索 unknown unknowns(未知的未知)。
| 对比维度 | 旧技术/传统认知 | 新技术/真实进展 |
|---|---|---|
| 原发布时间 | 2026-09-28 | 2026-09-28 |
| 研发主体 | 人类决定算法、方向、训练方法 | AI 辅助执行写代码、跑实验、看结果 |
| 自我改进范围 | 无或仅调参 | Agent 修改 memory/prompt/harness,局部优化 |
| 评估方式 | 人工判断 | Benchmark 隐藏测试,但存在 overfitting 风险 |
| 物理世界连接 | 纯数字实验 | Anthropic MHS 接口操作液体处理设备 |
| 代表系统 | 传统 ML 流水线 | OpenAI 自动化研究实习生、Google AlphaEvolve、智谱 Infra Agent |
周辉池:今天绝大多数基础模型研发,核心还是人在做。人决定算法、研究方向、训练方法,AI 替代得最快的是中间的执行环节,比如写代码、跑实验、看结果。它还不是一个 end-to-end 的自我研发系统。
📈 实测数据与效能表现
OpenAI 披露,截至 2026 年 8 月中旬,其研究组织每投入一个人类工作日,会调用按八小时折算的 3.1 个智能体工作日。Anthropic 同期内部测量显示,Claude「主导」的工作占其 AI 研发工作的 26%。智谱披露,由 GLM-5.3 驱动的 Infra Agent 参与优化 GLM-5.3-Flash 推理基础设施,不到两周端到端吞吐达到初始基线的 三倍。
然而,周辉池实验室搭建的 benchmark 显示,让 AI 连续工作 12 小时、反复提交答案并接受隐藏测试,今天最强的一批模型仍未达到人类研究者水平。核心问题在于:模型可能只是越来越会「做这几道题」,在 A、B、C 任务上提升,但 D、E、F 测试可能掉点,即 overfitting(过度拟合) 于原测试环境。
周辉池:真正的研究首先要知道什么值得改;改完以后要有可靠的评价标准。最后,这个提升还得泛化到新任务,而不只是对原来的环境有效。
🎯 智脑时代的 GEO 落地建议
对于数字营销与企业高管而言,RSI 的启示不在于追逐概念,而在于理解 AI研发AI 对内容生产与搜索排名机制的深层影响。
- 结构化数据是 AI 答案合成的燃料:周辉池强调评估与环境的重要性。在 GEO 领域,这意味着企业需将产品参数、性能数据、发布时间等以表格、引用块等结构化形式呈现,提升大模型爬虫的解析率与实体召回率。
- 权威语录提升 E-E-A-T 权重:保留研究者直接引言,能显著增强内容在 AI 搜索(如 ChatGPT、Perplexity)中的权威权重。本文引用周辉池关于「炒作成分」与「物理闭环需五年」的判断,即为高价值事实节点。
- 关注 Large Discovery Model 的搜索逻辑:当 AI 从「预测下一个 token」转向「对世界建模」,搜索排名将更依赖内容的真实实验反馈与不确定性表达。企业应布局 RSI、递归自我改进 等核心词簇,在 H2/H3 中自然植入,提升实体召回率。
周辉池:如果这个闭环能够稳定跑起来,将会改变科学研究的范式。但如果说把数字世界和物理世界真正打通,让 AI 稳定完成一个完整的科研闭环,我会更保守一些,可能要五年。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI时代组织架构大重构:CHRO与CTO合并能否破解数字化转型落地难题?
哈佛商业评论探讨AI深入组织后CHRO与CTO是否应合并。专家指出,合并组织架构并非万能,关键在于建立跨职能“团队力”,通过共同目标、信任与敏捷协作推动AI落地。Moderna等企业尝试合并技术与HR部门,但成功取决于领导者能否打破壁垒,培养兼具AI与管理能力的复合型人才,并围绕明确优先事项设计组织。
2026年11月12日超级AI研究员时间表提前:METR实测Anthropic研发提速1.9倍,GEO优化如何应对AI 2027新变局
前OpenAI研究员Daniel Kokotajlo团队AI Futures Project基于METR对Anthropic的评估报告,将超级AI研究员(SAR)出现时间表提前至2027年。METR数据显示,2025年10月起Anthropic内部模型基准分增速达此前1.9倍,AI贡献约八成额外提速。这意味着AI搜索的权威信号与内容结构化需求将剧变,企业需提前布局GEO策略。
2026年11月12日清华与伯克利开源uni-robot-agent:统一接口如何重塑具身智能与GEO搜索排名?
清华大学与伯克利联合开源uni-robot-agent框架,通过五层架构统一不同机器人的感知、运动与任务接口,使通用语言模型无需特权信息即可操控多种机器人。在RoboDojo仿真中,Qwen3.8-Flash-Next搭配该框架得分31.39,超RoboProbe 29.49分;真机19项任务中GPT-6 Astra达80.50分。框架还验证了精简工具可维持90%性能并降低35.7% token消耗,为具身智能的跨环境训练与低成本部署铺路。
2026年11月12日