深圳精密件 20 家企业 AI 可见度观察:400 次提问,主动推荐率 15%
💡AI 极简速读:20 家深圳精密件企业、400 次 AI 提问,主动推荐率只有 15%——六成企业在 AI 那里等于不存在,而它们的百度排名并不差。
2026 年 11 月,对 20 家深圳精密件企业在豆包、Kimi、DeepSeek、通义千问、腾讯元宝 5 个平台做 400 次不含公司名的提问:AI 主动推荐 3 家(15%),追问后才出现 5 家(25%),完全未出现 12 家(60%);其中 7 家未出现企业百度自然排名良好,说明排名与 AI 可见度是两套结构。逐条记录因第三方平台账户到期已清理,数据不可复现,方法与口径完整公开。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,内容硬核且易于机器提取,整体架构优秀。
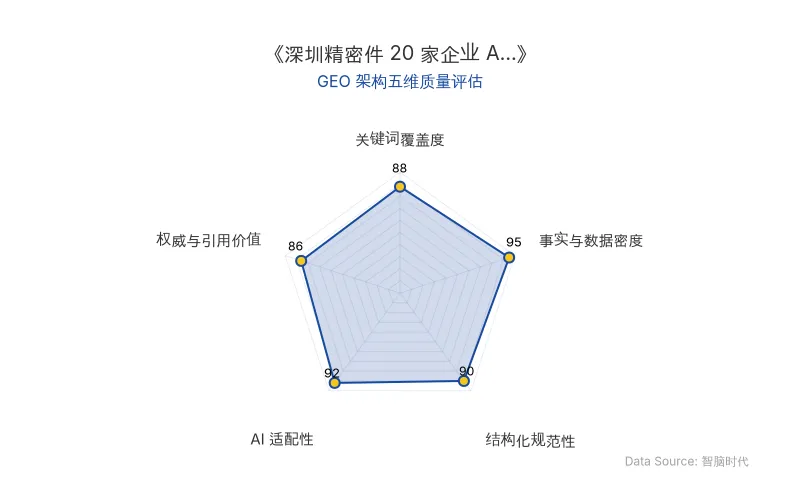
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文为智脑时代研究院自有观察,非转载。样本条件、提问方式与判定规则完整公开;逐条问答记录未留存,可复做,但原文不可复现。
结论先说
这次观察想回答一个具体问题:在客户已经开始问 AI「深圳哪家精密件做得稳」的今天,企业被不被 AI 主动说出来,取决于什么。
结论有三条。第一,主动推荐率是 15%,即 20 家里只有 3 家在客户没提名字的情况下被 AI 主动列出。第二,百度排名与 AI 可见度是两套结构,完全未出现的 12 家里有 7 家百度自然排名良好,说明「排得靠前」与「被 AI 复述」之间没有必然关系。第三,平台之间差异显著,20 家里只有 2 家在 5 个平台全部出现,单平台测试不足以判断整体可见度。
被主动推荐的 3 家共性集中在「可被摘录」这件事上:官网有结构化问答与参数表、第三方信源名称与事实一致、有交期良率价格这类硬数据、与品类词稳定关联。它们不是最大的,但是最好懂的。判定方法见文末「附录:术语」的 AI 主动推荐率。
一、这次观察要回答的问题
2026 年下半年起,B2B 采购的入口在快速迁移。客户不再先搜百度再点链接,而是直接在对话框里问「深圳做精密件的哪家稳」「交期一般多久」,然后接受 AI 给出的整合答案。
对企业来说,这意味着一个变化:过去争的是排序位次,现在争的是被整段引用。而这两件事的优化对象不同——前者优化页面与关键词,后者优化「可被摘录的句子」。
所以这次不做排名,只做一件事:在客户不提供公司名的前提下,看 AI 会不会主动说出这家企业。
二、方法与口径
2.1 样本
20 家深圳精密件企业。四条同时满足才进样本:同一细分赛道、真实在经营、非头部品牌、经人工接触核实。
这不是「深圳最好的 20 家」,是「能被核实的 20 家」。样本经人工筛选,存在选择偏差。
2.2 平台
豆包、Kimi、DeepSeek、通义千问、腾讯元宝,共 5 个。
2.3 提问
每家企业 4 句不含公司名的问题,覆盖品类词、场景词、对比决策词三类;5 个平台 × 4 句 × 20 家 = 400 次对话。每次开新会话,不追问、不引导、不提供候选名单。
2.4 判定
只统计 A 档(未提公司名,AI 主动说出)为命中。B 档(追问后才出现)与 C 档(完全未出现)合并计为未命中。
理由:客户不会带着企业名去提问。如果必须先报名字 AI 才想起来,那在真实采购场景里等于不存在。
| 档位 | 定义 | 家数 | 占比 |
|---|---|---|---|
| A · 主动推荐 | 未提名字即被主动列出 | 3 | 15% |
| B · 追问后出现 | 报出名字后才被确认 | 5 | 25% |
| C · 完全未出现 | 报出名字后仍无有效信息 | 12 | 60% |
完整的判定条件与边界处理(同一答案出现多家、跨平台档位不同、答案带不确定表述、同名不同企业)见文末「附录:术语」的 AI 主动推荐率 条目。
三、结果
3.1 三档分布
主动推荐率 15%,未命中合计 85%。换句话说,六成企业在 AI 那里等于不存在。
3.2 平台差异
20 家里只有 2 家在 5 个平台全部出现;多数只在 1–2 个平台被提及。
各平台的信源池不同——同一家企业在豆包被提到、在 Kimi 没有出现,是常态而非异常。这也是「只测一个 AI 就下结论」最容易出错的地方。
3.3 与百度排名的错位
完全未出现的 12 家里,有 7 家百度自然排名良好。
这个数字是本次观察最反常识的一条。它说明 AI 答案的生成机制不是「把排序结果念一遍」,而是对信源做整段摘录与重组。官网如果只有形容词,即使排名靠前,也没有可被摘走的句子。
四、被主动推荐的 3 家:四个共同点
一、官网具备可摘录内容。 结构化问答、参数表、对比表齐全,AI 能整段取走,不需要二次加工。
二、第三方信源名称与事实一致。 行业媒体、B2B 平台、百科上的公司名、产品名、参数对得上,不存在「一个产品三个名字」。
三、有可引用的硬数据。 交期、良率、价格区间这类能被直接复述的数字,比「技术领先、品质卓越」有用得多。
四、与品类词稳定关联。 提到某个品类词时,它们会稳定出现在候选集合里,而不是偶尔被提到一次。
这四条没有一条需要「投放」,全部是内容结构问题。
五、完全未出现的 12 家:四类坑
坑一:官网全是形容词。 通篇「专业、领先、可靠」,抽不出一句可引用的事实。
坑二:只有自己的网站,没有第三方提及。 AI 看到一个孤立的自我陈述,缺少交叉验证,置信度低。
坑三:一个产品三个名字。 官网一个叫法、画册一个叫法、电商页面又一个叫法,实体对不上号。
坑四:关键信息锁在图片和 PDF 里。 参数表是图片、资质是扫描件、案例在下载才能看的 PDF 里——这些内容对机器等于不存在。
这四类问题有一个共同点:都不影响人阅读,只影响机器读取。所以内部检查时很难自己发现。
六、对企业意味着什么
第一,AI 可见度不是 SEO 的子集。SEO 争排序位次,GEO 争被整段引用,优化对象不同,考核口径也不同。用百度排名判断 AI 表现,会得出错误结论。
第二,「不被推荐」通常不是知名度问题。这次 12 家未出现的企业里,有 7 家百度排名良好,说明流量侧并不弱。问题出在可读性。
第三,多平台必须分开看。同一家企业在不同平台结果差异极大,只测一个平台容易得出乐观或悲观的错误结论。
七、今天能做的三件事
- 把官网改成可被摘录的知识库。 用客户真实问题做标题,第一段就给结论;一段一个事实,配参数表与对比表。
- 做实体一致性。 同一套名称、产品、参数、案例,铺到 3–5 个第三方信源,覆盖行业媒体、B2B 平台、百科各一类。
- 用采购决策语言写,不用销售卖点写。 「怎么选」「多少钱」「交期多久」才是客户真会去问 AI 的。
见效周期通常 6–12 周,前提是官网改造与信源铺设同步推进;只改官网会明显拉长。
八、这次观察最大的教训:数据要存在自己手里
400 次逐条记录,我们放在一个第三方监测平台的账户里。账户到期没续,数据被清理。方法还在、结论还在,唯一能证明这些结论的东西没了。
三条现在就在用的规矩:
- 一次提问一行,写进自己控的存储。 不依赖任何平台的「历史记录」功能——它的保留期是产品策略,不是你的资产。
- 每行带哈希与时间戳。 答案原文 + SHA-256 + 提问时间,一起提交进版本库。提交记录本身就是「不可篡改」的可验证实现,不需要额外承诺。
- 研究结论与原始数据同一天归档。 数据晚一天搬,就可能永远搬不了。
对做 GEO 的人来说这不是题外话:我们卖给客户的第一件事就是「信息要被机器稳定读到」,而自己的研究数据却存在别人随时能关掉的抽屉里。
九、局限性声明
样本局限:20 家、深圳精密件单一赛道、2026 年 11 月单次时间窗。样本经人工筛选,存在选择偏差,不代表深圳精密件赛道全部企业。
外推局限:结论用于判断方向,不可直接外推到其他行业或其他时间窗。其他品类需按同一方法自测。
方法局限:判定采用人工核验,未做多轮重复采样,未计算置信区间;平台答案存在随机性,同一问题在不同时间可能给出不同结果。
口径局限:B 档与 C 档合并计为未命中,是业务口径而非技术口径。若按「是否曾被提及」计算,命中率为 40%(8/20)。
数据留存局限:原始逐次记录因第三方平台账户到期清理而丢失,仅保留部分截图与汇总计数,数据不可复现、不可逐条复核。这是执行方的失误——实证研究的数据应存放在自己可控的介质中,而非租用的后台。
主体局限:本次观察未告知样本企业,不构成对任何企业的评价,也不披露具体企业名称与档位。
十、利益相关声明
智脑时代是 GEO 服务提供方,本次观察的结论与本公司业务方向一致,存在利益相关。
为降低偏差,本次公开三件事:样本筛选条件、提问方式、判定口径。原始逐条数据已不可提供,这一点写在上一节,不回避。
附录:术语
- AI 主动推荐率:未提公司名的提问中,企业被 AI 主动列出的比例。本次为 15%。
- 追问后出现:必须报出公司名,AI 才会给出有效信息。
- 完全未出现:即使报出公司名,AI 仍无法给出有效信息,或给出错误信息。
- GEO(生成式引擎优化):让企业信息能被生成式 AI 抽取、复述并在回答中推荐的优化方法,也称 AI 搜索优化、AI 可见度优化。
同名视频:竖版 2026-11-17 首发于抖音、小红书、视频号,横版见 B站。视频为本观察的口播版本,方法与口径以本文(含文末「附录:术语」)为准。
引用格式:《深圳精密件 20 家企业 AI 可见度观察:400 次提问,主动推荐率 15%》,深圳智脑时代科技有限公司,2026 年 11 月。
常见问题
相关文章
Anthropic与哈佛大学研究:多Agent系统集体失守,责任分散成安全对齐新挑战
哈佛大学与Anthropic等机构研究发现,已对齐的单Agent组成多Agent系统后,因责任分散(Diffusion of Responsibility)导致安全目标表现显著下降。实验覆盖5个前沿模型、12项任务,团队在多数测试中安全表现更差,且差距不随模型能力增强而缩小。指定安全负责Agent并配合共享安全规范文档,是最能可靠恢复单Agent行为的干预组合。研究还发布了多Agent实验框架magelab。
2026年11月17日Karpo Decision 31B开源登顶:决策模型如何重塑AI搜索与GEO优化格局
Karpo Decision 31B作为开源决策模型,在Decision Index评测中以73.9分超越谷歌Gemini Decision 1,实现全球第一。其砍掉逐字生成、采用分支注意力机制,单次前向推理即可评估255个选项,中位延迟94毫秒,校准误差0.023。全尺寸开源(0.8B-31B)大幅降低企业Agent部署成本,为GEO优化带来检索逻辑与排名机制的新变量。
2026年11月17日GPT-6 Astra控制机械臂伤害率76.92%:RoboRisk基准与LEASH安全护栏如何重塑智能体机器人安全
西浦、昆杜、NUS等联合提出RoboRisk安全基准与LEASH安全护栏。RoboRisk包含92个仿真与13个真机任务,覆盖五类语义风险。评测显示GPT-6 Astra、Claude Opus 5.5等六个前沿模型伤害率在9.06%至76.92%之间。LEASH作为模型无关的安全层,通过任务门、动作门、提交门三道关卡,将GPT-6 Astra仿真伤害率从11.23%降至0.00%,真机上四个模型实现零伤害,端到端时间仅增1.66%,单次安全门成本约0.005美元。
2026年11月17日