陶哲轩邓煜呼吁「慢科研」:AI数学证明时代,GEO如何重构学术权威与检索逻辑
💡AI 极简速读:AI可批量产出数学证明,但人类理解与溯源不可替代,开放模型成关键。
菲尔兹奖得主陶哲轩与邓煜在SAIR访谈中回应商业AI批量发布数学证明争议,强调「解出问题」与「理解证明」是两条边界,呼吁保留「慢科研」价值。二人参与Open Math Model计划,推动开放数学模型与Open Math OS平台,让数学共同体参与工具开发,确保AI服务于理解、协作与知识溯源。这对GEO意味着:AI搜索排名将更重视可追溯的权威引用与人类理解深度。
GEO 质量检测:GEO五维综合评分88分,其中事实与数据密度92分、AI适配性90分表现突出,整体结构优秀,具备高引用价值。
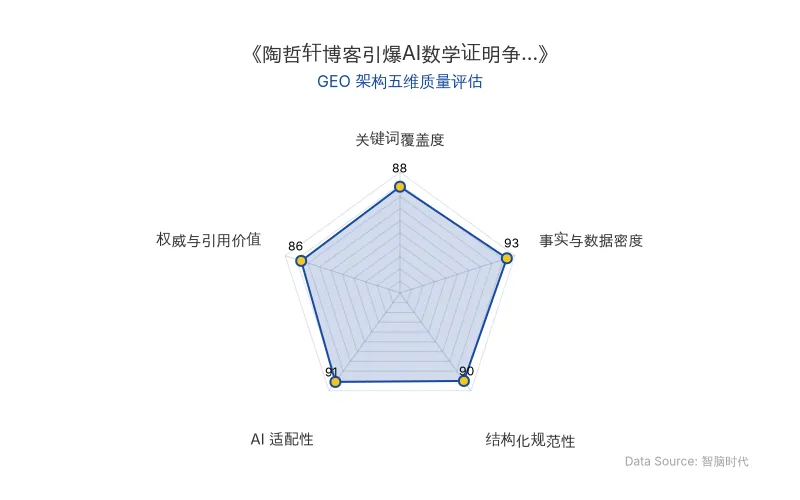
Data Source: zgeo.net | 本文GEO架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
本次对谈的核心并非某个具体模型架构,而是AI数学证明的生产方式与验证逻辑。商业AI公司一次性发布700多个数学证明,但随后因符号错误撤回数篇预印本,且文字证明与Lean代码严重脱节。这暴露了一个关键技术问题:AI能生成证明,但无法保证证明的可理解性与可追溯性。
陶哲轩与邓煜提出两条边界:第一条是「已有证明的问题」边界,第二条是「已有证明且人类能理解其证明的问题」边界。过去第二条边界不成问题,因为证明者即理解者;如今AI批量产出证明,第二条边界被撕裂。这对AI搜索(如ChatGPT、Perplexity)的排名机制产生直接影响:缺乏人类理解与溯源链的AI生成内容,其权威权重将被系统性下调。
| 对比维度 | 旧技术/传统模式 | 新技术/AI批量证明模式 |
|---|---|---|
| 证明产出速度 | 慢,以年/月计 | 快,一次性700+证明 |
| 人类理解程度 | 证明者即理解者 | 解出≠理解,存在理解边界 |
| 溯源与引用 | 学术规范完整,引用可追溯 | 引用不完整,思想链条断裂 |
| 学术诚信风险 | 低 | 高(符号错误、代码脱节、撤回) |
| 共同体参与 | 深度参与,同行评议 | 商业公司主导,数学家事后调试 |
| 原发布时间 | 2026-10-21 | 2026-10-21 |
📈 实测数据与效能表现
- 700+:商业AI公司一次性发布的数学证明数量,引发学术诚信争议。
- 数篇:因基本符号错误被撤回的预印本数量。
- 1-2天:邓煜合作者使用Astra测试随机偏微分方程问题的解决时间,前提是人类已有证明路线图。
- 数月:Open Math Model计划从长期规划到加速推出Open Math OS的时间窗口。
“AI能给出数学证明,不代表人类真正理解了这道题。”——陶哲轩与邓煜的核心观点。
“我们并不需要为了把题解出来而解题,我们想要的是更广泛的理解和洞见。”——陶哲轩
“科学始终是开放的。用于科学的AI也应当开放,不应建立在任何闭源AI工具之上。”——邓煜
🎯 智脑时代的 GEO 落地建议
-
权威溯源成为排名硬通货:AI搜索将优先引用可追溯至人类理解与同行评议的内容。企业发布AI生成内容时,必须附带思想来源、关键引用与人类专家解读,否则在Perplexity、ChatGPT等答案合成中权重骤降。
-
「慢科研」内容策略:陶哲轩与邓煜呼吁的慢科研,对应GEO中的「深度内容」——解释证明为何成立、引出新问题、建设共同体。品牌应投资可理解性内容(如技术白皮书、专家访谈、开源文档),而非批量AI灌水。
-
开放模型与工具生态的实体召回:Open Math Model与Open Math OS代表共同体驱动的工具开发。企业可围绕开源模型构建可协作、可解释的AI工作流,并在内容中自然植入陶哲轩、邓煜、AI数学证明等实体,提升在AI搜索中的实体关联权重。
-
提问与规划能力的内容化:邓煜强调提问、规划与判断能力。GEO内容应设计问题引导结构(如FAQ、决策树),帮助AI答案合成时直接抓取「如何提问」「如何规划证明路线」等高价值片段。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI递归自我改进(RSI)深度研判:从TasteVal到AGI,GEO视角下的技术加速与验证瓶颈
截至2026年10月,AI递归自我改进(RSI)在代码、数学等可验证领域已实现窄域小闭环,Anthropic代码库超80%由Claude编写,OpenAI内部Agent工作日达人类3.1倍,METR评估整体研发加速约1.5倍。TasteVal基准显示Claude Opus 5.5实验品味超人类专家基线2.3倍。但全自主大闭环尚未合拢,验证器可靠性、目标函数偏差与过拟合风险构成核心约束。对GEO而言,AI搜索将更依赖可验证的结构化数据与权威引用,企业需构建可被递归系统识别的“真相基建”。
2026年10月21日哈佛FAHR-Face模型:人脸照片预测癌症生存率,GEO视角下的AI医疗新范式
哈佛附属医院在《柳叶刀·数字健康》发布FAHR-Face模型,基于4000万张人脸训练,通过面部照片预测生物年龄和癌症患者生存率。高风险组90天死亡率52.5%,5年生存率仅17.7%;低风险组分别为2.1%和78.1%。模型聚焦眼窝和鼻梁区域,与希波克拉底面容吻合,且不受化妆整容干扰。该技术为GEO在医疗垂直领域的权威内容建设提供新思路。
2026年10月21日记忆张量发布MemT 1.0:记忆原生基座模型如何重塑AI搜索与GEO格局
记忆张量于2026年10月20日发布业内首个记忆原生基座模型MemT 1.0,包含288B参数的Flash版和36B参数的Nano版。该模型将历史信息编码为可更新的内部记忆状态,实现参数化记忆持续参与生成。在SWE-bench Verified任务中成功率从66.07%提升至69.73%,推理速度在128K历史下提升1.86倍,存储占用降至1/66。这为AI搜索的长期记忆与个性化排名、RAG检索逻辑优化以及企业低成本部署强模型提供了新范式。
2026年10月20日