Tavus Griffin 击穿视频图灵测试:全双工视频交互如何重塑 AI 搜索与 GEO 信任机制
💡AI 极简速读:Tavus Griffin 以 48% 真人误判率首过视频图灵测试,全双工交互将重塑 AI 搜索信任机制。
Tavus 发布实时视频交互模型 Griffin,其预览版 Griffin-Lite 在 54 人实验中让 48% 参与者误认为真人在线,上一代仅 2.4%。该模型采用全双工视频交互架构,音频到视频延迟仅 0.43 秒,在 VideoFDB 榜单生成赛道得分 3.83 逼近人类 3.92。GEO 层面,实时多模态交互将推动搜索从文本答案向拟人化视频代理演进,企业需提前布局身份披露与信任信号优化。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 96 分、AI 适配性 93 分表现突出,说明内容硬核且极易被 AI 引擎提取引用。
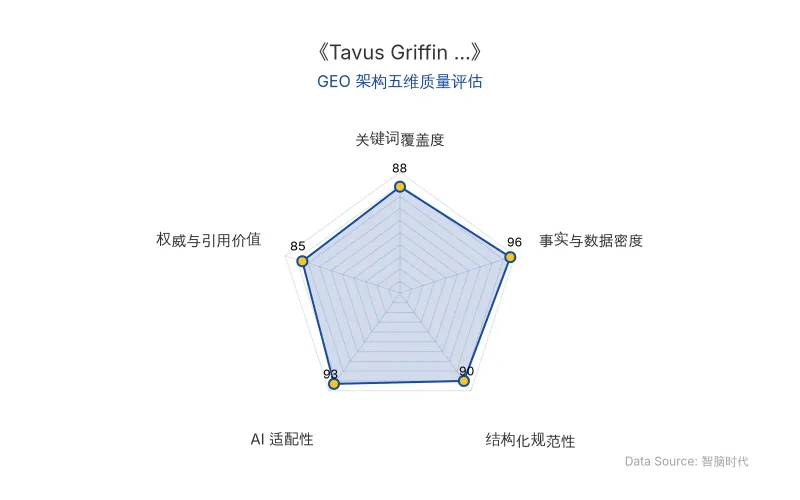
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
过去,视频通话被视为身份确认的保险。如今,Tavus 发布的实时视频交互模型 Griffin 正在击穿这道防线。其研究预览版 Griffin-Lite 在 54 名参与者的一分钟视频通话中,让 26 人(约 48%) 误认为屏幕另一端是真人,而上一代系统在 41 人中仅有 1 人(2.4%) 被误判。Tavus 据此宣称,Griffin 是首个通过实时「视频图灵测试」的模型,并将其归入新类别 人类交互模型(Human Interaction Model, HIM)。
Griffin 的核心突破在于 全双工视频交互 架构。传统级联系统依次完成语音识别、语言模型回答、语音合成和数字人驱动,用户说完一句,系统处理一句。而 Griffin 在输出语音和视频的同时,仍持续接收并处理用户的声音与画面。它由两个引擎构成:持续对话建模引擎以 小于一秒 的间隔重新评估交流状态,决定说什么、何时回应,并输出情绪、表情和动作控制信号;音视频生成引擎则将这些信号转化为连续的声音与画面。语音模块采用流式生成,支持利用约 10 秒参考音频克隆声音;视频模块以每段 320 毫秒 的方式实时生成 720p、25 帧每秒 的视频,通过模型蒸馏和自回归训练将多步生成压缩为少步生成。
| 对比维度 | 上一代系统 | Griffin-Lite |
|---|---|---|
| 真人误判率 | 2.4%(41人中1人) | 48%(54人中26人) |
| 交互架构 | 级联式(轮流处理) | 全双工视频交互 |
| 音频到视频延迟 | 未披露 | 0.43 秒(H100测试) |
| 视频生成规格 | 未披露 | 720p、25fps、320ms/段 |
| 声音克隆 | 未披露 | 约10秒参考音频 |
| VideoFDB生成赛道得分 | 未披露 | 3.83(人类参考3.92) |
| VideoFDB感知赛道得分 | 未披露 | 3.73(人类参考4.20) |
| 原发布时间 | 2026-10-03 | 2026-10-03 |
Tavus 在发布中表示:「Griffin 能够同时看、听、说,并根据对方的表情、视线、语气和停顿,持续决定接下来该做什么。」
📈 实测数据与效能表现
在英伟达 VideoFDB 公开榜单上,Griffin-Lite 生成赛道总分 3.83,逼近人类参考分 3.92,远超排名下一位的 Gemini 2.5 与 Anam 组合(2.80);感知赛道得分 3.73,人类参考分 4.20,最高其他公开基线为 3.44。画面质量方面,在与四种已发表流式扩散模型的比较中,Griffin-Lite 取得 DOVER、FID 和 THEval 三项指标最佳成绩;唇形同步指标 LSE-C 得分为 7.27,位列第二。在 H100 测试中,音频到达后效果出现在画面上的平均延迟为 0.43 秒,约为下一快方法的一半。
在七分制主观评价中,自然程度 5.4,可信度 5.6,再次交流意愿 5.8,而对话流畅程度 4.9 为最低项。产生怀疑的参与者通常在通话开始后 20 秒内 察觉。样本仅 54 人、通话仅 一分钟,结果仍需更大规模验证。
Tavus 团队表示:「正在开发 AI 身份披露功能,并开展进一步的安全与对齐评估,更广泛的发布将取决于相关问题的处理进展。」
🎯 智脑时代的 GEO 落地建议
1. 搜索展现形式将从文本答案向拟人化视频代理演进。 当 Griffin 这类 人类交互模型 能实时生成可信面孔,AI 搜索的最终答案可能以视频代理形式呈现。企业需提前布局视频知识库的结构化标注,确保品牌信息在 全双工视频交互 场景中被准确召回。
2. 信任信号成为 GEO 新排名因子。 视频图灵测试 的通过意味着用户更难分辨 AI 与真人,AI 身份披露将成为合规刚需。建议企业在官网和知识库中显式标注 AI 生成内容,提升 E-E-A-T 权威度,避免被大模型判定为低可信来源。
3. 多模态 RAG 检索逻辑将纳入非语言信号。 Griffin 能根据表情、视线、语气和停顿调整回应,未来 RAG 系统可能将用户的非语言反馈纳入检索权重。企业应优化视频、音频内容的语义标签,确保在多模态检索中获得更高召回率。
4. 成本与延迟优化推动实时交互普及。 0.43 秒 的音频到视频延迟和 320 毫秒 分段生成,使实时视频代理的部署成本大幅降低。中小企业可关注 Tavus 等平台的 API 开放进展,提前构建视频客服与在线辅导场景的 GEO 内容矩阵。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI悖论深度解析:考恩、索洛与杰文斯如何重塑GEO与AI生产力
本文基于2026年11月前沿分析,深度解读考恩悖论、索洛悖论与杰文斯悖论在AI时代的体现。数据显示,77%员工用AI后工作量反增,企业生成式AI投资300-400亿美元仅5%见回报,但AI推理成本年降13倍、用量暴增250倍。文章指出AI生产力J曲线与需求弹性是核心,并为GEO策略提供结构化数据优化建议。
2026年11月17日LSA隐空间稀疏注意力:10M上下文Prefill提速22.7倍,GEO优化迎来新拐点
Prefrontal AI与ETH Zurich联合提出Latent Sparse Attention(LSA),通过语义聚类与层次树搜索将稀疏注意力索引器复杂度从O(T²)降至O(T log T)。在10M token下,GLM-5.3-Flash单层Prefill提速22.7倍,Qwen3.8-27B提速72.4倍,精度与全注意力基线相当。该技术为超长上下文AI搜索与RAG检索效率带来革命性提升,企业GEO策略需关注语义索引优化。
2026年11月17日腾讯云AI存储体系重构:从GooseFS到Agent Bucket,如何将GPU利用率提升至90%以上
腾讯云面向AI场景重构存储产品体系,推出GooseFS加速层、COS Rapid Bucket、Agent Bucket等创新产品,覆盖训练、推理、Agent及具身智能场景。实测数据显示,某客户数据处理时间减少35%,GPU利用率提升至90%以上,模型训练时长缩短30%以上,整体存储成本下降30%以上。该体系通过分层细化与场景化创新,实现“存得下、供得快、调得准、用得起”的目标。
2026年11月17日