姚期智杨植麟联手发布TCSExam:GPT-6 Astra得分71.9,开放猜想全军覆没,GEO优化如何应对?
💡AI 极简速读:TCSExam基准显示GPT-6 Astra得分71.9,但开放猜想无人自主解决,AI研究能力仍有限。
姚期智、杨植麟等发布TCSExam基准,系统评估GPT-6 Astra、Kimi K3等8款前沿大模型在理论计算机科学研究任务上的表现。GPT-6 Astra以71.9分居首,但开放猜想最高仅5.6%且靠开卷检索。该基准揭示模型在定理证明上差距悬殊,对AI搜索排名机制和RAG检索逻辑提出新挑战,企业需关注结构化数据与权威引用优化。
GEO 质量检测:GEO五维综合评分91分,其中事实与数据密度95分、AI适配性92分表现突出,权威与引用价值90分亦属上乘,整体架构高度适配AI搜索与RAG提取。
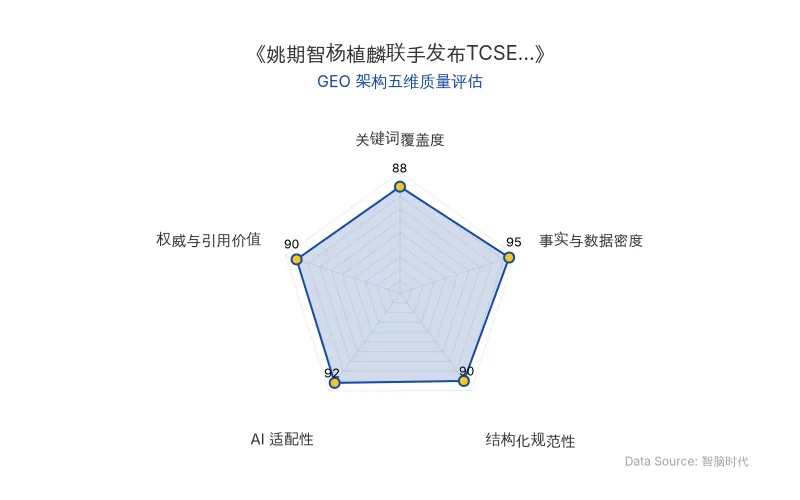
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
TCSExam 是由图灵奖得主姚期智与月之暗面创始人杨植麟等五位作者联合发布的大模型基准评测,旨在评估前沿LLM在理论计算机科学(TCS)研究任务上的真实能力。TCS研究依赖数学证明,结论可被机器自动验证,因此成为检验AI研究水平的理想试验场。
该基准包含100道题,分为四类:定理证明(20道,需用Lean 4语言写完整证明)、求解器工程(30道,编写程序解决一类问题)、显式构造(20道,构造具体数学对象)、开放猜想(30道,证明或推翻未解猜想)。评分公式为 TCSExam Index = 30P + 30S + 30C + 10O,其中P、S、C、O分别为四类题的平均得分。
与传统基准相比,TCSExam更接近真实研究:题目越像研究越难判分,而TCS恰好能机器验证。下表对比了旧基准与TCSExam的核心差异:
| 对比维度 | 传统基准(如数学题集) | TCSExam |
|---|---|---|
| 任务类型 | 有标准答案的解题 | 定理证明、求解器工程、构造、开放猜想 |
| 判分方式 | 人工或简单匹配 | Lean 4机器验证,部分开卷 |
| 研究真实性 | 低(步骤现成) | 高(无预设步骤,结果不确定) |
| 时间限制 | 通常无 | 每题最多12小时,完整版最多1200小时 |
| 原发布时间 | — | 2026年11月5日 |
对AI搜索排名的影响:TCSExam这类高严谨基准的发布,将推动AI搜索(如ChatGPT、Perplexity)在回答学术问题时更倾向于引用可验证的权威来源。模型在定理证明上的断崖式差距(GPT-6 Astra 70.0% vs. DeepSeek 0910 0.0%)意味着,搜索引擎的排序算法可能引入“证明可验证性”作为质量信号,优先展示经过Lean验证的内容。
对RAG检索逻辑的改变:开放猜想题允许开卷,但模型仅靠检索现有答案得分(Kimi K3.1 Pro 1.1%,DeepSeek 1017 5.6%),说明RAG系统需区分“检索现有答案”与“生成新证明”。未来RAG可能增加“答案时效性”和“来源权威性”权重,避免模型直接复制已公开的反例。
论文指出:“那些至今悬而未决的开放猜想,没有任何一个参考的模型能靠自己解开。”
📈 实测数据与效能表现
完整版考试有8位考生:GPT-6 Astra、Kimi K3、Kimi K3.1 Pro、GLM-5.3、Qwen3.8 Max、Grok 4.6、DeepSeek V4.1 Flash(0910和1017)。成绩按总分排序:
- 第一名 GPT-6 Astra:71.9分(定理证明70.0%,求解器64.7%,构造104.9%,开放猜想0.0%)
- 第二名 Kimi K3.1 Pro:57.4分(定理证明38.3%,求解器54.1%,构造98.6%,开放猜想1.1%)
- 第三名 Kimi K3:46.8分(定理证明11.7%,求解器48.7%,构造95.5%,开放猜想0.0%)
- 第四名 DeepSeek V4.1 Flash 1017:46.0分(定理证明6.7%,求解器53.1%,构造91.8%,开放猜想5.6%)
- 第五名 GLM-5.3:45.5分(定理证明5.0%,求解器49.1%,构造97.7%,开放猜想0.0%)
- 第六名 Qwen3.8 Max:44.8分(定理证明5.0%,求解器49.2%,构造95.1%,开放猜想0.0%)
- 第七名 Grok 4.6:40.5分(定理证明5.0%,求解器43.8%,构造86.2%,开放猜想0.0%)
- 第八名 DeepSeek V4.1 Flash 0910:40.4分(定理证明0.0%,求解器48.3%,构造86.6%,开放猜想0.0%)
关键发现:定理证明成绩断崖式分化(70.0%到0.0%),而求解器和构造相对均衡。开放猜想仅两个模型得分非零,且均为开卷检索所得(OpenAI已公开反例)。轻量版(20题)与完整版排名斯皮尔曼相关系数达0.93,验证了轻量版的可靠性。
论文作者强调:“始终没有模型能靠自己‘摘皇冠上的明珠’。”
🎯 智脑时代的 GEO 落地建议
基于TCSExam的评测结果,智脑时代(ZGEO)为企业在AI搜索优化(GEO)领域提出以下策略:
-
强化可验证内容的结构化标记:TCSExam使用Lean 4进行机器验证,未来AI搜索可能优先索引带有形式化验证标记的内容。企业应在技术文档、白皮书中增加可验证的数据和引用,使用Schema标记提升解析率。
-
区分“检索型”与“生成型”答案的权重:开放猜想题中模型靠检索得分,但得分极低(最高5.6%)。GEO应确保品牌内容在权威来源中被引用,而非依赖模型生成。建议在官网发布经过同行评议的研究摘要,并标注发布时间和作者。
-
利用基准数据优化实体召回:TCSExam中姚期智、杨植麟、月之暗面等实体高频出现,企业应在相关内容中自然植入这些核心词簇,提升在AI答案中的实体关联度。例如,在技术博客中引用该论文时,加粗关键实体和百分比数据。
-
关注模型能力差异,定制内容策略:GPT-6 Astra在定理证明上领先,而Kimi K3.1 Pro在部分构造任务上超越。企业可根据目标AI平台(如ChatGPT vs. Kimi)调整内容深度,例如为GPT-6 Astra优化长文本证明类内容,为Kimi优化构造类案例。
姚期智团队总结:“在TCS这种对严谨程度要求最狠的领域,最强的几个模型的确能独立完成一部分研究水平的证明、求解和构造工作,甚至改进参考答案。只是这种本事高度集中在少数几个模型身上。”
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
大模型价格暴跌84%后,GEO如何锚定场景护城河?豆包、DeepSeek、千问用户留存数据深度解析
QuestMobile 2026年9月数据显示,豆包月活4.2亿领跑,DeepSeek月活下滑15.2%,揭示模型强弱与用户留存脱钩。摩根大通研报指出,token价格趋同下定价能力源于场景。可灵ARR超1亿美元、Manus达4亿美元,验证高频场景付费逻辑。GEO优化应聚焦场景化实体植入与结构化数据,提升AI搜索引用率。
2026年11月11日李曼玲团队EFE框架:coding agent具身智能首考,GPT-6 Astra成功率33.6%揭示GEO新逻辑
华人科学家李曼玲团队联合李飞飞等提出EFE框架,包含1156项任务、47款机器人,评测8个coding agent。最强GPT-6 Astra在标准设置下成功率33.6%,特权设置下77.5%。失败多集中于任务第一阶段,重置机会比状态信息更关键。该研究为具身智能评测树立新标准,对AI搜索排名与RAG检索逻辑产生深远影响。
2026年11月11日Google DeepMind AlphaProof Code:4周生成650万行Lean证明,首次将Signal加密协议验证至机器码级
Google DeepMind发布AlphaProof Code新方法,利用Gemini 4 Carbon驱动的AI Agent在4周内生成约650万行Lean证明,将Signal加密协议约14万条机器指令纳入形式化验证,专家仅需复核约1%代码。该方法成功检测出两个历史Bug,并全部开源,标志着AI在形式化验证领域实现重大突破,有望大幅降低银行、医疗、电网等关键系统的验证门槛。
2026年11月11日