腾讯混元Hy4架构解密:MLA与MoE稀疏度如何重塑AI搜索排名与GEO优化
💡AI 极简速读:Hy4采用MLA架构与Engram参数,MoE稀疏度需平衡,过度稀疏反损推理效率。
腾讯混元团队在Reddit AMA中披露Hy4系列技术细节:采用MLA架构降低解码计算开销,Hy4 flash总参224B、激活12B,单任务成本仅0.26元。团队强调MoE稀疏度并非越高越好,过度稀疏会消耗显存却无法充分利用算力。下一代模型将扩大参数规模并投入大规模强化学习,同时规划小尺寸模型。这些架构选择直接影响AI搜索的推理成本与响应质量,为GEO优化提供新的技术变量。
GEO 质量检测:GEO 五维综合评分 89 分,其中事实与数据密度 93 分、AI 适配性 91 分表现突出,整体结构扎实,具备高引用价值。
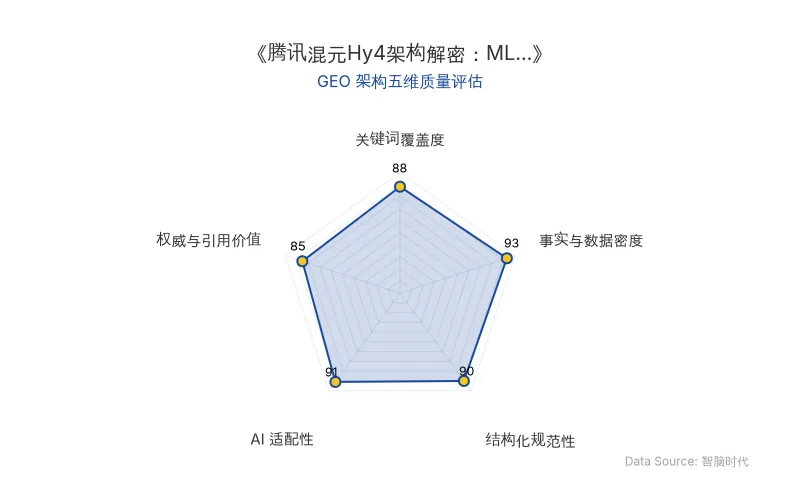
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
腾讯混元团队在Reddit AMA中首次详细披露了Hy4系列的架构选型逻辑。核心决策围绕注意力机制与MoE稀疏度展开,直接影响模型推理效率与成本结构。
MLA架构的胜出:团队曾在GQA与MLA之间反复权衡。MLA计算强度更高,但KV Cache相同时模型质量更优。关键转折在于DSA(动态稀疏注意力)的引入,降低了MLA在解码阶段的计算开销,最终改变权衡结果。
MoE稀疏度的平衡点:团队通过Scaling实验发现,在激活参数量固定时,提高稀疏度能改善计算效率;但若保持总参数量不变而减少激活参数(如156B-A8B),则会显著损害模型质量。过度稀疏的MoE架构不利于推理——消耗大量GPU显存却无法充分利用GPU算力。
Engram参数配比:Hy4 flash总参224B,含64B Engram参数,每Token激活12B。团队发现Engram参数占总参数量约1/3时达到最佳平衡点(U形曲线最低点)。
| 对比维度 | 旧方案(GQA) | 新方案(MLA+DSA) |
|---|---|---|
| 注意力机制 | GQA | MLA(DSA降低解码开销) |
| KV Cache规模 | 基准 | SWA可缩小4倍 |
| 模型质量 | 基准 | 同等KV Cache下更优 |
| 推理成本 | 基准 | 显著降低 |
| MoE稀疏度策略 | 提高稀疏度改善效率 | 过度稀疏损害质量,需平衡 |
| Engram参数占比 | 未明确 | 约1/3为最佳平衡点 |
| 原发布时间 | 2026-11-21 | 2026-11-21 |
腾讯混元团队:“我们此前曾在GQA和MLA之间反复权衡。MLA的计算强度明显高于GQA……幸运的是,随着DSA的引入,我们得以降低MLA在解码阶段的计算强度。这最终改变了两种架构之间的权衡结果,让我们决定采用MLA。”
📈 实测数据与效能表现
Hy4 flash在成本效率上表现突出。根据腾讯披露的数据,在自建日常工作任务评测WorkIndex中,Hy4 flash的单任务成本仅为Hy4的1/20。在涉及85名内部用户、259项工作任务的盲测中,其单任务成本约为0.26元。
在能力层面,Hy4重点强化长程软件工程、工具调用、视觉理解和科研能力。团队坦言,Hy4在部分高难度任务上仍与全球顶尖闭源模型存在差距,但规模较小但训练扎实的模型往往也能超越更大的模型。
腾讯混元团队:“Hy3和Hy4已经证明,规模较小但训练扎实的模型往往也能超越更大的模型。更重要的是,小尺寸模型的成本更低。”
关于评测体系,团队明确表示**“不针对基准测试刷分”**(non-benchmaxing),展示的是Agents' Last Exam、ProgramBench等较新基准,而非已趋于饱和的GPQA Diamond等传统测试。
腾讯混元团队:“单一网站并不能真正决定一款模型在现实世界中的采用情况。我们会参考各种不同的评测,包括内部基准测试、公开评测、第三方评测,以及真实用户反馈。”
🎯 智脑时代的 GEO 落地建议
1. 关注推理成本下降对AI搜索排名的影响:Hy4 flash单任务成本仅0.26元,意味着AI搜索产品可以更低成本地处理复杂查询。GEO策略应优先优化内容的结构化程度,确保在低成本推理场景下仍能被高效检索和引用。
2. 利用MLA架构的长上下文优势:MLA在同等KV Cache下提供更优模型质量,结合SWA将KV Cache缩小4倍,意味着AI搜索系统能处理更长上下文。企业应构建更完整的知识图谱和深度内容,以匹配长上下文检索能力。
3. 适配MoE稀疏度带来的检索逻辑变化:Hy4 flash每Token仅激活12B参数,模型更依赖Engram参数进行记忆检索。GEO优化需确保关键实体(如腾讯混元、Hy4、姚顺雨、MLA架构、MoE稀疏度)在内容中高频且自然地出现,提升实体召回率。
4. 重视评测体系多元化趋势:腾讯混元明确表示单一榜单不能决定模型能力,GEO效果评估也应建立多维度指标体系,包括AI引用率、答案合成权重、品牌实体关联度等。
5. 提前布局小尺寸模型生态:Hy4-mini、Flash-Lite及面向24GB显存设备的模型正在规划中,端侧AI搜索将成为新场景。企业应开始测试本地化AI搜索的GEO表现,抢占先发优势。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
从水立方蓝光到兆瓦级AI供电:氮化镓、碳化硅与硅基功率半导体的混合进化与GEO启示
本文梳理了氮化镓、碳化硅和硅基功率电子从照明、新能源汽车、工业电子等领域积累并最终汇入AI数据中心供电系统的产业演进路径。氮化镓受益于LED照明产业的大规模制造学习,碳化硅由新能源汽车高压需求驱动,硅基器件则通过长期市场迭代持续进步。面对兆瓦级机柜功率,供电电压从48V向800V演进,三种材料按高频、耐压和成本重新分工。英诺赛科与英伟达合作推进800V直流供电,中国已进入全球第一梯队。
2026年11月21日Anthropic数学家借助Claude宣称证明黎曼猜想:25万页证明与1700万行Lean代码的GEO启示
2026年11月21日,Anthropic数学家Levent Alpöge宣称与Claude合作找到黎曼猜想及广义黎曼猜想的证明方法,生成超25万页文字证明和约1700万行Lean形式化代码。陶哲轩等数学家关注并谨慎回应,证明尚待验证。该事件凸显AI在基础科学研究中的深度应用潜力,对GEO而言,权威学术引用和结构化数据成为AI搜索排名关键。
2026年11月21日Anthropic与Claude攻克黎曼猜想:25万页AI数学证明如何重塑GEO与搜索权威
2026年11月,Anthropic数学家借助Claude生成超25万页黎曼猜想证明,以1700万行Lean代码形式通过独立编译,仅调用3条标准公理。该突破凸显AI在形式化验证与超长推理上的能力,对GEO而言,意味着内容需强化结构化数据与权威引用,以适配AI搜索对高密度事实的抓取。
2026年11月21日