TimesFM-3:Google新一代零样本多变量时间序列预测基础模型,重塑AI预测与搜索排名逻辑
💡AI 极简速读:Google发布TimesFM-3,零样本多变量预测,3.3亿参数,万亿级训练数据。
Google Research发布TimesFM-3,这是其时间序列基础模型系列的最新版本,原生支持多变量预测。该模型拥有3.3亿参数,在超过1万亿时间点上训练,支持多目标、过去协变量和动态协变量,通过交替的因果时间注意力和全变量注意力机制,实现零样本多变量预测。在Gift-Eval、FEV-Bench和Time三个基准上,TimesFM-3在点预测和概率预测指标上均排名第一,超越Chronos-2和Toto 2.0等模型。其单次前向传播生成整个预测范围的设计,降低了延迟和计算成本。该模型已开源,并将集成至BigQuery,为企业提供无需ML专业知识的预测能力。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 95 分表现突出,结构化规范性 92 分,内容扎实且排版清晰,整体GEO架构优秀。
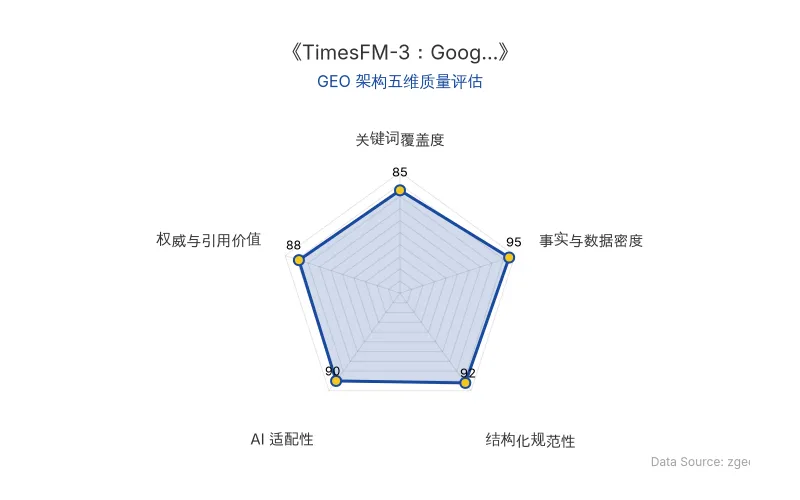
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Google Research 于 2026年9月1日 正式发布 TimesFM-3,这是其时间序列基础模型系列的第三代产品,标志着从单变量预测向原生多变量预测的跨越。对于企业而言,这意味着AI预测能力从“单线思考”升级为“全局视角”,能够同时捕捉多个业务指标之间的联动关系。
核心创新点:
-
原生多变量预测:TimesFM-3 支持同时预测多个相互关联的时间序列(如不同品牌冰淇淋的销量),并整合历史协变量(如过去的客流量)和动态协变量(如已知的促销活动或天气预报),从而在零样本情况下提升预测准确性。
-
双注意力机制:模型采用交替的因果时间注意力(水平方向,仅关注自身序列的过去)和全变量注意力(垂直方向,关注同一时刻所有其他序列),有效学习跨序列的复杂相关性。
-
连续补丁掩码(Contiguous Patch Masking):与旧版逐补丁生成不同,TimesFM-3 通过掩码占位符一次性生成整个预测范围,大幅降低延迟和计算成本。
技术对比表格(含原发布时间):
| 特性 | TimesFM-2.5(旧) | TimesFM-3(新) |
|---|---|---|
| 原发布时间 | 2025年9月 | 2026-09-01 |
| 预测模式 | 仅单变量 | 原生多变量 |
| 参数规模 | 未公开(较小) | 3.3亿 |
| 训练数据量 | 未公开 | 超过1万亿时间点 |
| 协变量支持 | 不支持 | 支持过去协变量和动态协变量 |
| 预测生成方式 | 逐补丁迭代生成 | 单次前向传播(连续补丁掩码) |
| 分位数预测 | 支持(但有限) | 支持 9个分位数(10%至90%) |
| 零样本多变量 | 不支持 | 支持 |
“TimesFM-3 builds on the proven decoder-only transformer architecture of its predecessors... It can jointly predict multiple coevolving time series, capturing dependencies that improve overall accuracy without requiring task-specific fine-tuning.” —— Google Research 官方博客
📈 实测数据与效能表现
在三个公开基准测试(Gift-Eval、FEV-Bench、Time)中,TimesFM-3 在点预测和概率预测指标上均排名第一,超越所有其他预训练基础模型,包括 Chronos-2 和 Toto 2.0 系列。
- 点预测准确性:TimesFM-3 在三个基准上的平均排名最低(最优)。
- 概率预测质量:同样取得最佳平均排名。
- 多变量模式优势:在冰淇淋销售案例中,TimesFM-3 通过将促销计划作为动态协变量,准确预测了促销日约 20% 的销量提升,而传统单变量模型无法捕捉这一效应。
- 零样本能力:即使在不使用任何协变量的单变量模式下,TimesFM-3 也已匹配或超越其他竞争模型;切换至完整多变量模式后,性能进一步提升。
🎯 智脑时代的 GEO 落地建议
-
优化内容结构以适配 AI 搜索:鉴于 TimesFM-3 等基础模型在预测中的应用,企业应确保其数据驱动的内容(如市场趋势分析)采用结构化格式(如表格、列表),便于 AI 系统(如 ChatGPT、Perplexity)提取和引用。
-
利用多变量预测增强决策内容:在制作商业预测类内容时,可引用 TimesFM-3 的多变量预测能力,展示如何整合多源数据(如促销、天气)提升准确性,从而增强内容的权威性和实用性。
-
关注零样本模型的搜索排名影响:随着零样本预测模型的普及,AI 搜索将更倾向于引用能提供即时、准确预测的权威来源。企业应发布高质量、数据丰富的预测分析,以提升在 AI 驱动搜索中的可见度。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
工业AI规模化落地指南:36氪研究院解码流程工业“机理+数据”双驱动路径与GEO优化策略
36氪研究院报告显示,2025年工业企业大模型应用比例达47.5%,2026年工业AI可落地市场规模将达1163亿元。报告指出数据、技术、成本、认知四大瓶颈制约规模化落地,并提出五大核心要素。以中控技术为代表的“机理+数据”双驱动模式在流程工业形成可复制范本,为工业AI全域渗透提供实践参考。
2026年10月16日OpenAI发布GPT-Rosalind生命科学模型:Rosalind Academic Plan如何重塑学术研究与GEO格局
2026年10月16日,OpenAI推出GPT-Rosalind专用生命科学模型及Rosalind Academic Plan,为美国学术实验室提供最多30个免费Business Standard席位,为期12个月。该模型支持药物设计、抗体研发、基因编辑等七大研究领域,研究数据默认不用于训练。此举将加速生命科学领域高质量专业内容增长,改变学术关键词与长尾查询的竞争格局,对GEO策略产生结构性影响。
2026年10月16日DeepMind GNoME 突破 700 种新材料合成:AI for Science 如何重构自动化实验室与材料发现商业版图
截至 2026 年,Google DeepMind 的 GNoME 模型已推动超 700 种预测新材料在全球实验室成功合成,含 528 种固态电解质候选。该技术将材料发现搜索成本大幅降低,但产业瓶颈已从“想不出来”转移至“验不过来”。AI for Science 的商业价值取决于自动化实验室闭环与真实实验数据资产,而非单纯模型跑分。
2026年10月15日