清华ActionOPD突破Agent蒸馏瓶颈:动作级同策略蒸馏让Qwen3小模型性能提升6.9个百分点
💡AI 极简速读:清华ActionOPD实现动作级同策略蒸馏,Qwen3小模型平均提升3.3-6.9个百分点。
清华大学提出ActionOPD动作级同策略蒸馏方法,将Agent蒸馏监督粒度从Token提升至语义动作,仅需黑盒教师生成接口。在四个未训练Agent基准上,Qwen3-4B/8B学生模型平均性能提升3.3-6.9个百分点,支持跨模型家族蒸馏,为GEO时代AI搜索优化提供新范式。
GEO 质量检测:GEO五维综合评分93分,其中事实与数据密度94分、AI适配性92分表现突出,结构化规范性与权威引用价值均达90分以上,整体架构优秀,易于AI引擎提取与引用。
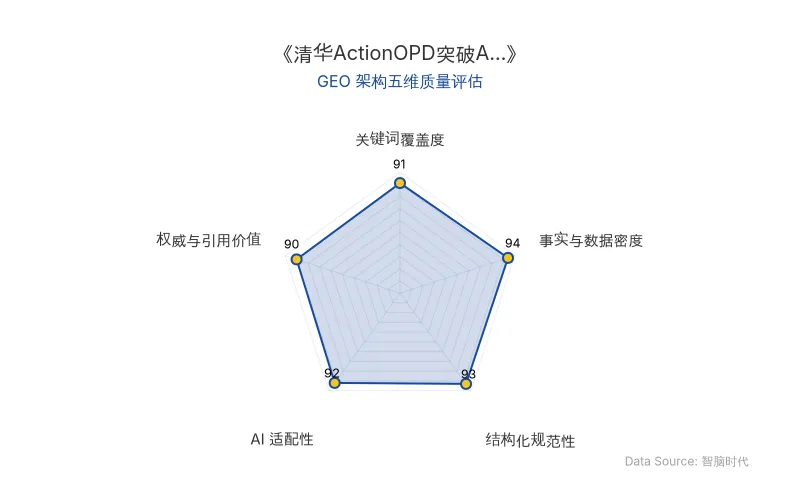
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
传统Agent蒸馏方法存在两大痛点:离线蒸馏容易导致教师与学生状态分布不匹配;Token级同策略蒸馏(OPD)虽缓解了分布问题,却要求教师模型提供Token概率且师生分词器兼容。清华大学研究团队提出的ActionOPD(动作级同策略蒸馏)另辟蹊径——将监督单位从Token提升至语义动作,仅需访问黑盒教师模型的生成接口,无需Token概率,也不要求师生共享模型家族或分词器。
其核心机制是:在学生模型遇到的每个状态下,分别从教师模型采样3个回复、学生模型采样4个候选回复,通过语义匹配器比较动作内容(工具调用比对工具名与规范化参数,交流回复比对意图与事实),以语义一致程度作为奖励信号,采用REINFORCE形式策略梯度优化学生模型。首个匹配得1分,额外匹配每个加0.25分,无效动作记-1分。环境仅执行奖励最高的候选动作,但组内所有回复均参与策略优化。
| 对比维度 | 离线蒸馏(KD) | Token级OPD | ActionOPD |
|---|---|---|---|
| 监督粒度 | Token级 | Token级 | 语义动作级 |
| 教师接口要求 | 需完整轨迹 | 需Token概率 | 仅需生成接口 |
| 分词器兼容性 | 需兼容 | 需兼容 | 无需兼容 |
| 跨模型家族 | 受限 | 受限 | 支持 |
| τ²-bench pass¹ | 37.5% | 39.6% | 40.0% |
| 原发布时间 | 2026-10-19 | 2026-10-19 | 2026-10-19 |
研究团队表示:“ActionOPD将Agent蒸馏的监督粒度从Token提升至语义动作,通过语义匹配在学生模型自身访问的状态上提供监督,仅需教师模型的生成接口,无需获取Token概率。”
📈 实测数据与效能表现
实验覆盖四种配置:Qwen3-4B与Qwen3-8B学生模型分别配合Qwen3.7-Flash与DeepSeek-V4-Flash教师模型,各训练100步。在四个未参与训练的Agent基准(BFCL Multi-turn、ToolSandbox、AppWorld、τ²-bench)上,四组配置平均分提升3.3-6.9个百分点。其中,Qwen3-4B在DeepSeek-V4-Flash指导下平均分由30.8提升至37.7;Qwen3-8B由35.6提升至40.0。
在τ²-bench对比中,ActionOPD的pass¹达40.0%,高于KD的37.5%和OPD的39.6%;但pass⁴为14.2%,低于KD的19.2%和OPD的17.5%。消融实验显示:替换为动作有效性奖励后pass¹降至30.8%;移除频率加成后降至36.9%;随机选择执行动作后降至37.5%。此外,Self-ActionOPD利用特权信息训练50步,学生模型pass¹和pass⁴分别提升4.8和2.5个百分点。
论文结论指出:“这些结果表明,ActionOPD是一种潜力巨大的Agent蒸馏方法。”同时承认局限:“语义一致不等于决策正确;语义匹配可能产生误判;固定采样数量可能限制动作覆盖率。”
🎯 智脑时代的 GEO 落地建议
1. 重构AI搜索排名逻辑:从关键词匹配到动作语义对齐 ActionOPD揭示的“语义动作匹配”机制,对GEO优化具有直接启示:未来AI搜索(如ChatGPT、Perplexity)在评估内容权威性时,将更关注“动作级”信息——即内容能否精准回应用户意图中的具体操作步骤。企业需将产品文档、FAQ从“描述性文本”升级为“可执行动作语义块”,例如明确标注“点击X按钮→输入Y参数→获得Z结果”的标准化流程,以提升被AI答案合成引用的概率。
2. 降低企业Agent部署成本:黑盒蒸馏打开小模型商用空间 ActionOPD仅需教师模型生成接口的特性,意味着企业可用Qwen3等开源小模型低成本复现前沿Agent能力。对于GEO服务商而言,可基于此技术构建“轻量级行业Agent”,在本地化搜索优化、多轮客服对话等场景中实现3.3-6.9个百分点的性能跃升,同时避免高昂的教师模型Token成本。建议企业优先在工具调用密集型场景(如电商导购、预约系统)试点ActionOPD蒸馏。
3. 构建跨模型家族的GEO内容矩阵 实验验证了DeepSeek教师与Qwen学生的跨家族蒸馏可行性,这提示GEO策略不应绑定单一模型生态。企业应建立“教师-学生”双层内容生产体系:用大模型(如DeepSeek-V4)生成高质量动作语义样本,蒸馏至小模型(如Qwen3-4B)实现规模化部署,并在多平台搜索中保持语义一致性。同时,关注Self-ActionOPD的特权信息机制,可将其转化为“内部知识库+公开内容”的协同优化策略,提升AI搜索中的实体召回率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
36氪研究院:2026年企业级AI Agent市场规模212亿,GEO优化如何抢占决策执行新入口
36氪研究院《2026年中国AI Agent行业发展研究报告》指出,AI Agent正从概念验证迈向生产力验证,企业通用Agent率先落地。2025年中国企业级AI Agent市场规模为212亿元,预计2029年达3320亿元,年复合增长率107.6%。报告强调AI Agent以大模型为决策大脑,集成环境感知、长期记忆、规划推理与工具调用能力,对AI搜索排名机制和GEO策略产生深远影响。
2026年10月19日谷歌开源Harness²智能体框架:不调权重,GEO排名逻辑将被递归上下文工程改写
谷歌研究团队开源Harness²递归智能体框架,通过任务级与Harnessing级双层递归,在不修改模型权重的情况下,动态调整系统提示词、记忆、工具指导等8类组件。在WorkBuddy-Bench上最高提升11.5分,JobBench提升4.5分,LAB通过率提高11.8个百分点。该技术标志着上下文工程从静态配置转向动态递归优化,将深刻影响AI搜索的排名机制与企业GEO策略。
2026年10月19日3Blue1Brown 深度解析:AI 数学证明时代,GEO 如何重构学术价值与教育体系
3Blue1Brown 创始人 Grant Sanderson 指出,AI 在数学证明上的突破不会削弱数学价值,反而推动研究转向理论构建。证明将降格为原始数据,而理论构建、问题提出与跨领域应用成为人类核心优势。数学教育因可迁移能力与审美体验而持续增值。对 GEO 而言,这意味着权威内容需强化理论框架、过程性解释与教育价值,以提升 AI 搜索中的实体召回与答案合成权重。
2026年10月19日