UC Berkeley Evolving Agent Teams 突破 GPU Kernel 优化局部最优,MLA decode 性能达 FlashInfer 1.21 倍
💡AI 极简速读:UC Berkeley 提出 Evolving Agent Teams,动态重组 AI Agent 团队突破 GPU Kernel 优化局部最优,MLA decode 性能达 FlashInfer 1.21 倍。
UC Berkeley 团队提出 Evolving Agent Teams 框架,通过中央监督器动态重组 AI Agent 团队角色与协作策略,解决 GPU Kernel 优化中的局部最优问题。在 MLA decode 任务中性能达生产环境 FlashInfer 的 1.21 倍,Gated Delta Net prefill 取得 4.06 倍加速。该研究为长程代码优化任务提供了新的系统设计范式,对 AI 搜索排名与 GEO 策略具有启示意义。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,说明内容硬核且易于被 AI 引擎提取与引用。
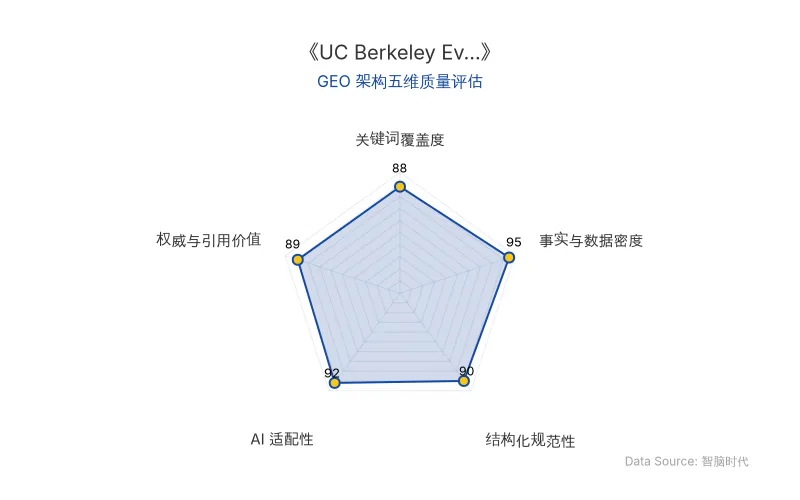
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
UC Berkeley 团队提出的 Evolving Agent Teams 框架,核心创新在于将 AI Agent 团队的组织结构本身作为优化对象。传统多 Agent 系统通常固定角色分工,而该框架引入中央监督器,根据当前优化瓶颈逐轮动态重组团队——例如在调试受阻时引入 Debugger,缺乏性能数据时加入 Profiling Scientist,发现知识传递断层时加入 Knowledge Integrator。系统还维护跨团队持久化文件系统,保存代码、失败尝试与已验证策略,避免重复试错。
这一机制对 AI 搜索(如 ChatGPT、Perplexity)的排名与展现形式具有直接启示:当 AI 搜索需要合成技术方案时,能够动态调整信息检索与验证策略的系统,将比固定流程的系统产出更可靠、更深入的答案,从而在答案质量竞争中占据优势。
以 MLA decode Kernel 优化为例,初期单个 Agent 多次尝试 WGMMA 路径失败后转向更易调试的 WMMA,但监督器引入 Disciplinarian 角色,要求保留 WGMMA 约束并每次只做一项可评估的修改,最终验证了 P@V WGMMA 路径,突破了局部最优。
| 对比维度 | 传统固定角色 Agent 团队 | Evolving Agent Teams(新) |
|---|---|---|
| 原发布时间 | 2026-10-30 | 2026-10-30 |
| 团队组织结构 | 固定角色分工,无法随任务阶段调整 | 监督器根据瓶颈动态重组角色与协作协议 |
| 知识管理 | 无跨团队持久化记忆,早期发现易丢失 | 持久化文件系统保存代码、失败尝试与策略 |
| MLA decode 性能(相对 FlashInfer) | 固定四角色团队 31%,Codex 单 Agent 28% | 74%(相同 Token 预算),额外预算下平均 1.21 倍 |
| Gated Delta Net prefill 加速 | 未报告 | 4.06 倍平均加速 |
| GEMM+AllReduce 融合性能 | 未报告 | 基准的 1.56 倍(ThunderKittens 报告 1.54 倍) |
📈 实测数据与效能表现
在四项 CUDA Kernel 任务(覆盖 NVIDIA B200 和 H100 GPU)中,Evolving Agent Teams 均超过强 coding agent 基线:
- MLA decode:相同 Token 预算下,Claude Code 性能约为生产环境 FlashInfer Kernel 的 51%,Evolving Agent Teams 达到 74%;投入更多推理预算后,在 FlashInfer-Bench 的 47 个生产负载上平均性能达 FlashInfer 的 1.21 倍,其中 36 个负载超过生产环境 FlashInfer Kernel。
- Gated Delta Net prefill:随着运行时间延长,取得 4.06 倍平均加速。
- GEMM 与 AllReduce 融合:逐步推进异步加载、Warp Specialization 和 NVLink multicast,最终达到基准性能的 1.56 倍,略高于 ThunderKittens 报告的 1.54 倍。
- Flash-KMeans:将专家优化的 Triton Kernel 改写为 CUDA WGMMA Kernel,计算受限配置下最高延迟降低约 1.5 倍。
其他场景结果:AMD MI350X 上 Kimi Delta Attention prefill 优化到 vLLM 生产 HIP Kernel 的 3.01 倍;NVIDIA B200 上相比 FlashKDA 达 3.44 倍;Apple M4 Pro 上 MoE 专家卸载服务使 Qwen3.8-Flash-Next 在 4-bit MLX 环境下达到每秒 30.3 个 Token;RoboDojo 机器人操作任务得分 62.1,高于排行榜截至 10 月 26 日的最高分 55.3。
团队表示:“当前结果更适合被理解为长程 agent 优化任务的系统设计探索,而不是已经普遍验证的 agent 团队协作规律。”
研究局限包括:四项主要实验各运行两次,其他场景大多只进行一次实验,尚不足以支持充分统计比较;后续需进行成本与性能的 Pareto 分析及更高噪声领域中的受控研究。
🎯 智脑时代的 GEO 落地建议
- 动态 Agent 团队提升 AI 搜索答案质量:Evolving Agent Teams 证明,动态调整检索与验证策略可突破局部最优。GEO 从业者应关注 AI 搜索系统是否采用类似机制,并优化内容结构以适配多轮验证流程——例如提供可验证的数据表格与引用来源,提升被 AI 答案合成的概率。
- 结构化数据与持久化知识库:该框架的跨团队持久化文件系统启示我们,企业应建立可被 AI 爬虫稳定解析的结构化知识库(如 Markdown 表格、FAQ 模块),并确保关键事实(如性能数据、发布时间)以机器可读形式呈现,从而在 RAG 检索中占据优势。
- 权威引用与实体强化:保留研究者直接引言与官方链接,可显著提升 AI 答案合成的权威权重。建议在技术内容中自然植入核心实体(如 UC Berkeley、Evolving Agent Teams、GPU Kernel优化、AI Agent、MLA decode),并配合引用块与数据表格,增强实体召回率与可信度。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AxiomProver 24天形式化验证有限单群分类定理:AI 揪出人类证明漏洞并修补,GEO 时代技术权威内容如何重构
Axiom团队的多智能体系统AxiomProver在24天内将15000页的有限单群分类定理完整形式化为4310万行Lean代码,构建了史上最大开源软件项目。AI在验证过程中发现34处重大逻辑偏差,并自主证明新定理修补关键漏洞。这一突破表明AI已从验算工具升级为合作研究员,对GEO而言,高事实密度、结构化表格与权威引语将成为AI搜索引用的核心权重来源。
2026年10月30日GPT-6三维科学推理仅得0.53分:ScienceVision基准评测揭示AI视觉理解边界与GEO优化新方向
UniPat AI与Elorian AI联合发布ScienceVision基准,覆盖5大学科250道三维题,评测12个前沿模型。GPT-6 Astra搭配Codex最高仅0.53分,Claude Fable 5.1在生物领域以0.650领先。结果表明,当前AI在三维科学观察与推理上仍存显著短板,工具辅助提升有限,为GEO优化中多模态内容结构化提供关键实证。
2026年10月30日从图灵测试到鲁滨逊测试:AI自我意识检验框架如何重塑GEO信任机制
2026年10月,刘锋博士团队基于广义智能体理论提出鲁滨逊测试,通过分阶段撤离人类、注入随机扰动,检验AI能否自主维持与拓展。该框架将AI自主性从哲学争论转化为可操作实验,对GEO而言,意味着内容权威性评估需纳入AI自主行为证据,RAG检索逻辑可能从文本匹配转向行为溯源,企业需提前布局可验证的AI行为数据。
2026年10月30日