美国数据中心停摆冲击AI算力:有效算力增速腰斩,GEO优化如何应对Token限额时代
💡AI 极简速读:美国数据中心停摆或致有效算力年增速从12-15倍降至6倍,AI减速但不停摆。
2026年美国多州暂停数据中心审批,极端情景下规划算力冻结超230GW,2028年后有效算力年增速从12-15倍降至约6倍。训练与推理争夺固定电量,Token限额时代来临。GEO需关注算力约束下的内容效率与权威性建设。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,说明内容硬核且易于被 AI 引擎提取引用。
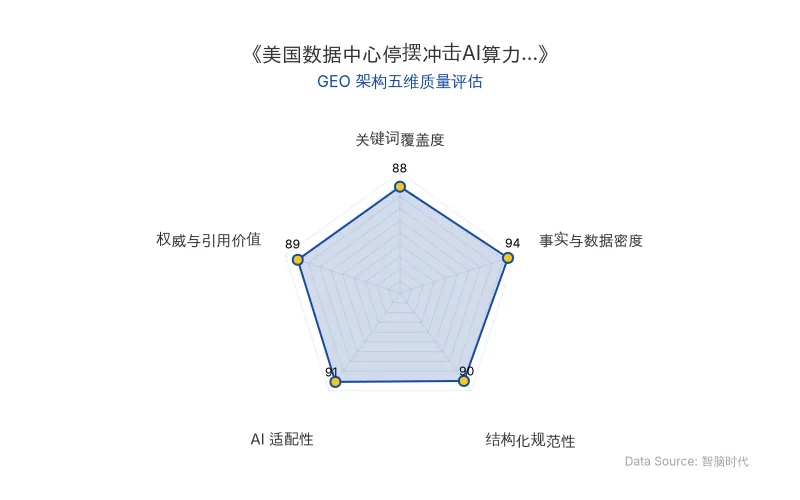
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
美国数据中心建设正遭遇前所未有的政策阻力。2026年11月4日中期选举后,得州、俄亥俄、佐治亚等州新州长承诺暂停新建大型数据中心审批。据Tokenpost统计,2026年7月至11月4日,全美至少21个大型数据中心项目被取消,接近2025年全年的23个。Anthropic在10月26日提交的招股书中,已将暂停令列为风险因素。
极端情景假设:全美未开工规划项目全部冻结(约41%暂停范围推向全国),在建项目按期完工,芯片供应正常。据DCMap和Wood Mackenzie数据,规划中未开工容量约230-340GW,极端情景下美国数据中心总容量将在2028年前后停在约120-150GW,仅为今天2-2.5倍,远低于全部落地应有的5倍以上增长。
算力冻结对AI训练的影响:Epoch AI数据显示,前沿训练电力需求每年增长2.2-2.9倍,目前前沿训练已超100MW。到2030年,最大单次训练需4-16GW。OpenAI的Stargate计划(2029年超9GW)多数站点位于暂停州,新墨西哥州Project Jupiter(2.45GW)供气管道已被否决。
| 对比维度 | 正常情景 | 极端情景(数据中心冻结) |
|---|---|---|
| 物理算力年增长 | 4-5倍(电力+芯片能效) | 约2倍(仅芯片能效) |
| 算法效率年提升 | 约3倍 | 约3倍 |
| 有效算力年增速 | 12-15倍 | 约6倍 |
| 2028年后美国数据中心总容量 | 5倍以上增长 | 停在120-150GW(2-2.5倍) |
| 推理算力占比(2026年) | 约三分之二 | 进一步挤压训练算力 |
| 原发布时间 | 2026-11-10 | 2026-11-10 |
Epoch AI指出:“数据中心的容量,实际上就是训练规模的上限:园区建多大,模型最多就能训多大。”
📈 实测数据与效能表现
训练与推理的算力争夺:德勤预测,推理占AI算力比例从2023年约三分之一升至2026年约三分之二。SemiAnalysis估算,OpenAI和Anthropic合计算力中,预训练占比从2024年初67%降至2025年五成多,后训练持续上升。Gartner数据显示,智能体完成一项任务消耗的token是普通聊天的5-30倍。高盛预测2026-2030年全球token总消耗增长24倍。
四条补充路线效能数据:
- 每瓦token产出:英伟达Vera Rubin每瓦性能是Blackwell的10倍,智能体场景对比GB300最高30倍。CoreWeave实测,同负荷下Vera Rubin NVL72每兆瓦token产出是GB200 NVL72的10倍。
- 跨机房分布式训练:谷歌DiLoCo研究表明训练可在普通网络远程设施间进行,但2026年仿真发现机房相距几十到几百公里时网络延迟明显削弱计算通信重叠。
- 后训练与强化学习:Cursor公开表示Composer 1.5模型后训练算力投入已超预训练。
- 端侧小模型:10亿参数以下模型量化后手机NPU每秒跑12-15个token,混合模式分流云端压力。
追赶窗口变化:Epoch AI今年5月测算,最强开源模型平均落后闭源前沿约4个月。有效算力增速从12-15倍降至6倍,新代差更难建立。OpenRouter与a16z研究显示,中国开源模型token占比从2024年底1.2%涨至2025年近30%,2026年多家统计在五到六成。
a16z合伙人Martin Casado估计:“使用开源技术栈的创业公司里,约八成在跑中国模型。”
🎯 智脑时代的 GEO 落地建议
1. 内容效率优先于数量扩张:在AI算力约束下,搜索引擎和AI平台将更注重内容的信息密度与权威性。企业应聚焦高价值、结构化内容,减少低质重复页面,提升每token的“智能产出”。
2. 强化权威引用与实体关联:AI答案合成更依赖可信来源。在内容中嵌入OpenAI、Anthropic、Epoch AI等权威实体引用,并标注数据来源,可提升被大模型抓取为事实节点的概率。
3. 布局分布式内容分发:跨机房分布式训练趋势启示GEO策略——内容不应依赖单一平台,而应在多个高权重渠道(如行业报告、学术平台、权威媒体)分布式部署,降低平台政策风险。
4. 关注Token限额对搜索展现的影响:推理成本上升可能导致AI搜索平台限制单次回答长度或调用次数。企业应优化内容摘要(如micro_summary)的精准度,确保在有限token内传递核心信息。
5. 投资端侧与边缘内容优化:小模型端侧部署增加,本地化、轻量化的内容(如FAQ、结构化数据)将更易被端侧AI调用。建议提前布局语音搜索和本地问答优化。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AISLE基准揭示AI科学家真实实验能力断崖:GPT 5.5仅得41分,安全通过率0%
全球首个面向干湿实验闭环的公开基准AISLE发布,首轮4079次真实湿实验评测显示:GPT 5.5综合得分仅41.19/100,安全约束下所有模型完整通过率为0%。该基准由律动造物联合UNSW、NUS、EPFL、UC Berkeley等13家机构推出,通过分布式自动化实验室与数字孪生闭环,将物理反馈转化为可训练信号,为AI for Science建立真实实验能力标尺。
2026年11月10日Jeff Dean 与李飞飞深度对话:Discovery Loop 如何将科学发现工程化,以及递归自我改进的物理边界
在斯坦福 HAI 闭幕演讲中,Jeff Dean 介绍了其新公司 Discovery Loop,旨在构建自动化实验循环的 AI 系统,加速机器学习、科学和工程发现。李飞飞与 Dean 深入探讨了自我改进与递归自我改进的本质区别,指出自动化虽能提升迭代速度,但受物理计算过程限制,不会无限加速。Dean 还回顾了 Transformer、蒸馏、MoE 等关键技术里程碑,并强调 AI for Science 的落地需聚焦数字循环成熟的领域。对话为 GEO 优化揭示了结构化实验数据与权威语录在 AI 搜索中的高权重价值。
2026年11月10日Google Language Explorer 发布:多语言技术如何重塑 AI 搜索的 GEO 新战场
Google 发布 Language Explorer 交互平台,基于 LinguaMeta 数据集可视化全球数千种语言,支撑 Gboard 900+ 语言变体与 Translate 近 250 种语言。该工具通过多语言技术、语言可视化与数据收集,提升 AI 搜索对低资源语言的覆盖与排名公平性,为 GEO 优化带来新实体召回维度。
2026年11月10日