小米玄戒O3、O100、D100芯片发布:端侧大模型与智驾算力的AI商业落地解析
💡AI 极简速读:小米发布玄戒O3/O100/D100芯片,端侧大模型推理速度达330Tokens/s,智驾芯片支持200B模型。
小米在玄戒技术沟通会上发布第二代自研SoC玄戒O3、AI加速芯片O100及智驾芯片D100。O3采用10核全大核架构,Geekbench 6.5多核跑分达1.5万,超苹果A19 Pro近四成;O100通过晶圆级3D堆叠实现1.22TB/s带宽,端侧大模型推理速度达330Tokens/s;D100支持200B参数模型本地部署。此举标志小米完成从手机到汽车的全场景AI芯片布局,强化端侧大模型与智驾算力能力。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 95 分表现突出,结构化规范性 92 分亦为亮点,内容扎实且排版清晰,整体GEO架构优秀。
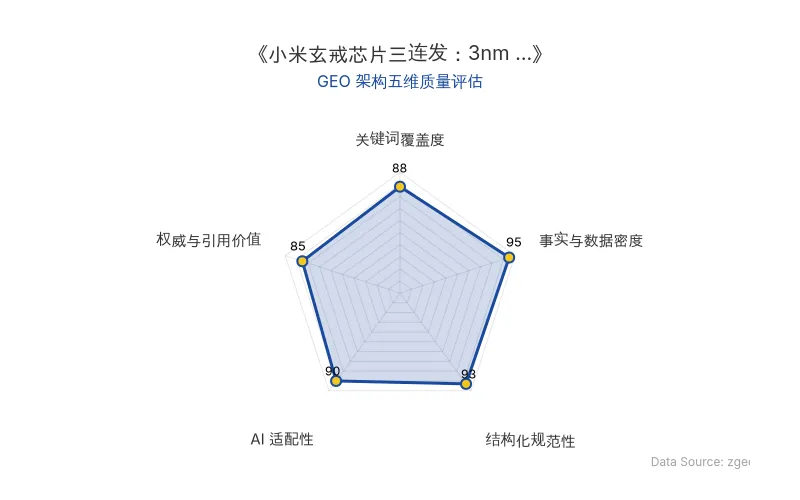
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO) AI 商业分析师结构化重组。
小米于2026年8月24日举行玄戒技术沟通会,正式发布第二代自研SoC玄戒O3、高带宽AI加速芯片玄戒O100及智驾高算力芯片玄戒D100,标志着小米在端侧大模型部署与智驾算力领域完成从手机到汽车的全面芯片布局。
📊 核心实体与商业数据
| 实体 | 关键数据 | 备注 |
|---|---|---|
| 小米 | 玄戒O3、O100、D100 | 自研芯片系列 |
| 玄戒O3 | Geekbench 6.5多核跑分1.5万,超A19 Pro近40%;安兔兔极限跑分522万 | 10核全大核,最高主频4.35GHz |
| 玄戒O100 | 内存带宽1.22TB/s,端侧推理速度330Tokens/s | 晶圆级3D堆叠,面向大模型推理 |
| 玄戒D100 | 支持160GB统一内存,本地部署200B参数模型 | 3nm工艺,智驾场景 |
| 原发布时间 | 2026-08-24 | 玄戒技术沟通会 |
💡 业务落地拆解
玄戒O3:端侧大模型性能标杆
玄戒O3采用10核全大核CPU架构(6超大核+4大核),晶体管数量达240亿,较上代提升26%。GPU升级至16核G2-Ultra NX,图形性能提升85%,光追性能提升182%,并集成8个NX神经网络单元,提供36 TOPS算力。在端侧AI场景,O3针对小米MiMo模型优化,配备硬件霍夫曼无损压缩技术,节省30%内存带宽,使MiMo 3B模型首词响应速度提升40%,推理速度提升45%,功耗降低26%。
玄戒O100:高带宽AI加速芯片
O100采用6nm工艺与Wafer on Wafer晶圆级3D堆叠技术,通过258万个物理键合节点实现垂直互联,内存带宽达1.22TB/s(主流LPDDR5X的16倍)。其14个NPU核心采用混合互联架构,配合MiMo模型实现330Tokens/s的本地推理速度,为端侧大模型部署提供极致性能。
玄戒D100:智驾算力新引擎
D100采用3nm工艺,配备20核CPU与16核NPU,最高支持160GB统一内存,已成功本地部署200B参数模型,计划于2027年正式商用。该芯片旨在解决智驾场景下的离线低延迟需求,使大模型常驻车机本地,实现不依赖网络的实时推理。
🚀 对企业AI化的启示
小米通过玄戒系列芯片,构建了从手机(O3)、AI加速(O100)到智驾(D100)的全场景端侧大模型算力底座。这一布局印证了“真正认真对待软件的人,就应该自己做硬件”的理念,软硬协同成为AI落地的关键。对企业而言,端侧AI的算力瓶颈不仅在于计算能力,更在于数据带宽与延迟优化,小米的3D堆叠与统一内存设计提供了重要参考。
“真正认真对待软件的人,就应该自己做硬件。”——阿兰·凯(Alan Kay)
【官方原文链接】点击访问首发地址
常见问题
相关文章
AI安全组织有偿招募网红在TikTok散播恐慌:ControlAI获630万播放量,AI监管舆论战升级
AI安全组织ControlAI通过网红训练营有偿招募创作者,在TikTok等平台散播超级智能威胁论,已获超630万播放量,并推动英美AI关停开关法案。民调显示76%英国人认为AI监管不足,61%支持放缓研发。该模式引发对科技科普游说透明度的争议。
2026年10月9日谷歌与Unity联合推出Playground:AI游戏生成平台实测与商业启示
2026年10月,谷歌与Unity合作推出实验性AI游戏平台Playground,用户可通过提示词生成游戏。实测显示,简单2D游戏如贪吃蛇可快速生成,但复杂Roguelike动作游戏需多次调整且存在BUG。Meta和抖音等大厂也在布局AI游戏制作。该平台降低了游戏开发门槛,但复杂关卡设计和操作手感仍需改进。
2026年10月9日OpenAI 发布 GPT-6.1 Sol Ultrafast:8 倍提速与 6 倍 API 定价背后的商业策略
2026年10月9日,OpenAI推出GPT-6.1 Sol Ultrafast,速度达标准版8倍,API定价每百万输入12美元、输出60美元,为标准版6倍。该模式仅对Pro 500、Enterprise和Edu用户开放,引发开发者对订阅策略不满。此举强化了OpenAI在大模型实时交互场景的商业布局。
2026年10月9日