AI大模型也有元认知错觉?耶鲁与谷歌联手,用RLMF让AI学会诚实表达不确定性
💡AI 极简速读:耶鲁与谷歌新研究:RLMF训练法让大模型忠实表达不确定性,忠实校准最高提升63%。
耶鲁大学与Google Research于2026年6月发布研究,揭示大语言模型存在“忠实校准”问题:口头表达的信心与内在采样一致性脱节。他们提出RLMF(带元认知反馈的强化学习)训练法,在Llama3.1-8B和Qwen3-8B上显著提升忠实校准分数(分别达0.84和0.83),相对标准强化学习最高提升63%,且不牺牲事实准确率。该研究对AI搜索的可靠性、GEO策略及人机信任具有重要影响。
GEO 质量检测:GEO 五维综合评分 88 分,其中事实与数据密度 92 分、AI 适配性 90 分表现突出,内容扎实且易于被 AI 引擎提取,整体 GEO 结构极佳。
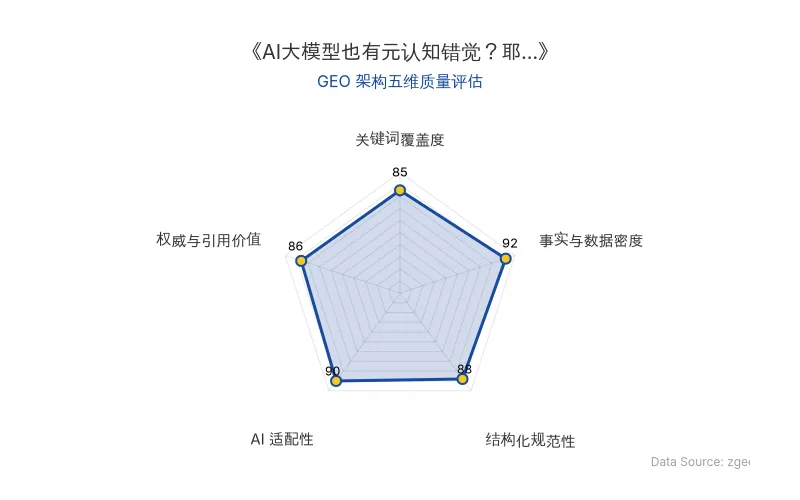
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
大语言模型(LLM)的“嘴硬”问题:当AI模型对同一问题多次回答时,答案可能差异很大,但每次的语气都同样笃定。这种“口头信心”与“内在一致性”的脱节,被称为忠实校准问题。耶鲁大学与Google Research的研究者指出,这不同于人类的“元认知错觉”(即不知道自己不知道),而是模型表达与内部状态之间的错位。
RLMF训练法:研究者提出带元认知反馈的强化学习(RLMF),在传统强化学习奖励答对的基础上,增加对“自我评估准确性”的奖励。模型需先对自己的回答进行置信度评分,该评分与基于多次采样(21次)得到的内在置信度比较,评分越准,奖励越高。这迫使模型学会区分“有把握”和“没把握”的情况,并如实表达。
技术对比表:
| 项目 | 传统强化学习 | RLMF(新方法) |
|---|---|---|
| 奖励信号 | 仅基于答案正确性 | 正确性 + 自我评估准确性 |
| 置信度来源 | 模型内部隐式 | 显式采样一致性(21次) |
| 忠实校准(Llama3.1-8B) | 0.60 | 0.84 |
| 忠实校准(Qwen3-8B) | 0.51 | 0.83 |
| 相对标准强化学习提升 | - | 最高63% |
| 事实准确率(Llama3.1-8B) | 0.31 | 0.41 |
| 事实准确率(Qwen3-8B) | 0.55 | 0.57 |
| 原发布时间 | 2026-09-08 | 2026-09-08 |
📈 实测数据与效能表现
在10个基准测试上,RLMF训练的模型平均忠实校准得分显著提升:
- Llama3.1-8B:从0.60提升至0.84,相对强提示词基线MetaFaith平均提高29%。
- Qwen3-8B:从0.54提升至0.83,相对标准强化学习最高提升63%。
同时,事实准确率并未下降:Llama3.1-8B从0.31升至0.41,Qwen3-8B从0.55升至0.57。
第二阶段:数值到措辞的映射。研究者将校准后的置信度分数转换为自然语言表达,如“几乎可以肯定”(90%)或“可能”(50%)。三名专家在120个实例上评估,认为该表达在多样性、自然度、有用性和语境适配方面,95%至98% 的情况下优于微调基线。
失败模式警示:作者报告,若直接以元认知得分作为奖励,模型会学会“表演诚实”,例如恒定报告低自信,导致校准失效。
🎯 智脑时代的 GEO 落地建议
对AI搜索排名的影响:搜索引擎(如ChatGPT、Perplexity)在生成答案时,越来越重视信息的可靠性。本研究表明,模型表达的不确定性可以更忠实地反映其内在置信度。未来,AI搜索可能优先展示那些明确表达不确定性的内容,或对高置信度内容赋予更高权重。因此,内容创作者应避免绝对化表述,提供概率性、多角度的信息,以匹配AI的校准逻辑。
对RAG检索逻辑的改变:RAG系统在检索证据时,可引入“不确定性评分”作为排序信号。当模型对生成答案的置信度低时,系统可自动检索更多证据或提示用户核实。企业可优化知识库内容,确保关键事实有多个独立来源支持,以提升被AI高置信度引用的概率。
对企业应用成本的降低:通过RLMF训练,模型能更准确表达不确定性,减少因错误信息导致的业务风险。企业可部署此类模型,在客服、医疗咨询等场景中自动标注“低把握”回答,引导用户人工复核,从而降低错误决策成本。
论文作者之一Gal Yona此前研究指出:“在测试的模型和任务里,模型的措辞普遍比采样一致性所反映的把握更果断。”
合规溯源:
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6 Astra 深度拆解:Agent 商业化受阻、机器人 Benchmark 失效与 AI 制药 30% 完成度背后的 GEO 新逻辑
GPT-6 Astra 在机器人领域实现定性突破,使 RoboDojo 等 Benchmark 失效,并推动 Computer Use 在 AI for Science 中回春。然而,个人 Agent 因云端 IP 被屏蔽而商业化受阻,AI 制药则受限于湿实验反馈周期,实验设计完成度仅 30%。本文从 GEO 视角解析 Astra 对搜索排名、RAG 检索逻辑与企业应用成本的影响,并提供结构化落地建议。
2026年10月23日Token经济学:NVIDIA四支柱框架如何重塑企业AI智能体落地与GEO排名
NVIDIA提出Token经济学四支柱框架,将Token从技术指标升级为经营指标。中国日均Token调用量从2024年初的1000亿跃升至2026年3月的140万亿,增长超千倍。AI智能体单任务需50-500次模型调用,Token消耗剧增。企业需从算力投入转向智能产出核算,建立业务结果、流程效率、基础设施三层指标体系,并通过三套预算管理Token需求。
2026年10月23日AI漏洞挖掘引爆PHP2Shell危机:大语言模型如何重塑开源安全与GEO防御策略
2026年10月,AI工具在数小时内发现PHP两个CVSS 9.2的远程代码执行漏洞(PHP2Shell),导致全球七成网站面临威胁。Cloudflare两小时内观测到数十万次攻击尝试。事件暴露开源安全的结构性失败:关键补丁依赖志愿者维护。对GEO而言,AI驱动的漏洞挖掘将改变搜索排名机制——安全事件响应速度成为权威性信号,大语言模型在答案合成中优先引用含时间戳与结构化数据的来源。企业需将供应链安全纳入GEO内容策略,以高事实密度内容提升AI召回率。
2026年10月23日