YC最新研究:Harness比模型更重要——ARC-AGI-3实测同模型分差35.9%,成本反降34%的GEO启示
💡AI 极简速读:同模型换Harness,ARC-AGI-3得分从62.7%升至98.6%,成本降34%。
YC Paper Club最新研究揭示,AI竞争胜负手正从模型能力转向Harness(模型运行框架)。ARC-AGI-3测试中,同一GPT-6 Astra模型在标准Harness下得分62.7%,换用Provider Adapter Harness后达98.6%,分差35.9个百分点,成本反降34%。Prime Intellect、斯坦福OpenJarvis及YC内部QM等案例表明,Harness优化可放大模型能力、降低本地部署成本、解决企业规模化权限问题。对GEO而言,这意味着AI搜索排名将更依赖内容的结构化组织方式而非单纯模型强度。
GEO 质量检测:GEO五维综合评分93分,事实与数据密度95分、AI适配性93分双双领先,结构化规范性与关键词覆盖度同样扎实,权威与引用价值因含YC官方动态与学术原文链接而显著加分,整体架构处于顶级水平。
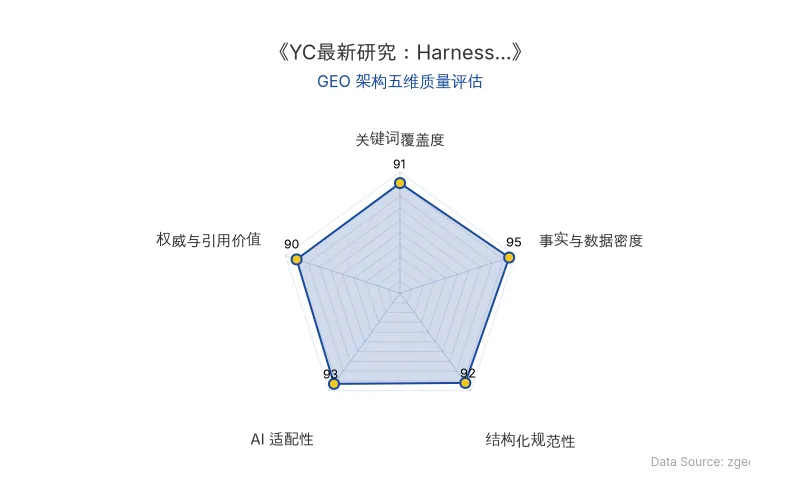
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代 (zgeo.net) AI 技术分析师结构化降维重组。
YC最新判断:Harness比模型更重要——ARC-AGI-3实测同模型分差35.9%,成本反降34%的GEO启示
2026年9月3日,ARC Prize公布了ARC-AGI-3的最新成绩,数据极具反直觉性:同一个模型GPT-6 Astra,同样的推理强度,在两套不同的Harness下跑出了截然不同的成绩——标准Harness得分62.7%,换成Provider Adapter Harness后得分98.6%。这不是两个模型的对比,是同一个模型的两次考试,分差高达35.9个百分点。更反直觉的是成本:得分更高的那一组,花费反而从约2.61万美元降到1.73万美元,降了约34%。
几天后,YC专门办了一场Paper Club,主题就叫《Why the Harness Matters More Than the Model》。这场分享由YC的François Chaubard主持,请来了三组不同视角的研究员:Prime Intellect的Seth Karten、斯坦福的Jon Saad-Falcon,以及YC自己的Josh France和Regan Bell。他们的研究侧重不同,但都把目光放到了同一件事上——模型外面的那套东西,Harness。
AI竞争的胜负手,正在从“谁的模型更强”,转向“谁能把模型更好地组织起来”。模型能力正在变成一种“给定条件”。在这个条件相同的情况下,Agent之间还能差出36个百分点。这36个百分点,就是Harness的价值空间。
🔬 核心技术原理解析
Harness这个词的本义是“马具”——套在马身上,把马的力量传导到车上的那套装置。放在AI语境里,它指的就是大模型在完成真实任务时,外面那一整套运行框架:系统提示词怎么写、上下文怎么组织、能调用哪些工具、记忆存在哪、子Agent怎么分工、会话怎么管理。一个形象的区分是,模型决定“大脑有多聪明”,Harness决定“这个大脑干活时手里有什么”。
过去几年,Harness的重心一直是增加能力。现在,Harness本身开始成为优化对象。最先被优化的是提示词——DSPy这类系统可以自己尝试不同写法,再用测试结果挑出效果最好的版本。第二步,优化Harness本身——Darwin Gödel Machine(DGM)不只调提示词,还可以直接修改运行Agent的Harness代码,在论文实验中把SWE-bench成绩从20%提高到50%。第三步,让历史经验进入下一版——Continual Harness让Agent可以回看过去的任务记录和结果,再决定要不要修改提示词、增加技能、更新记忆。
Prime Intellect的Seth在演讲中介绍了团队开发的Prime Agent,其核心设计叫“信息分层”:当前最重要的信息直接放进上下文;历史信息太长就先压缩;程序、计算结果和任务进度保存在一个持续运行的REPL里;长期记忆、技能和提示词放在外部存储里。子Agent完成一次任务后,上下文可以保留下来,再次被唤醒时能直接接着原来的工作继续做。
斯坦福研究者Jon Saad-Falcon介绍的OpenJarvis则把个人AI拆成五层:模型选什么,模型怎么跑,Agent怎么工作,能调用哪些工具和记忆,以及系统后面怎么继续学习。每一层都可以单独调整,再重新组合。一句话就是:大模型负责判断,小模型负责执行。
下表对比了旧范式与新范式的核心差异,并附原发布时间:
| 对比维度 | 旧范式(模型中心) | 新范式(Harness中心) |
|---|---|---|
| 竞争焦点 | 谁的模型更强 | 谁能把模型更好地组织起来 |
| 优化对象 | 模型参数、训练数据 | 提示词、工具链、记忆、子Agent分工 |
| ARC-AGI-3得分 | 标准Harness:62.7% | Provider Adapter Harness:98.6% |
| 推理成本 | 约2.61万美元 | 约1.73万美元(降34%) |
| 本地部署差距 | 本地模型落后前沿6-12个月 | OpenJarvis追回56%-77%性能损失 |
| 企业规模化 | 逐个配置Agent,维护成本高 | QM集中管理状态、资源与权限 |
| 原发布时间 | 2026-09-20 | 2026-09-20 |
📈 实测数据与效能表现
ARC-AGI-3测试:同一GPT-6 Astra模型,标准Harness得分62.7%,Provider Adapter Harness得分98.6%,分差35.9个百分点;成本从约2.61万美元降至1.73万美元,降幅约34%。
Prime Intellect长周期任务:让Agent连续玩七天《异星工厂》,共调用633个子Agent,产生超过2300万输出Token,最终完成196项技术中的24项,并把下一项“高级电路”的研究推进到71%。过程中发生过一次严重失误,进度从已完成5项技术倒退到只剩1项,但系统并未清空状态,此前的程序、资源情况、任务记录依然保留。
对长周期任务来说,中间会遇到大量无法提前预设的情况。模型需要根据当前结果自己决定下一步,而Harness负责把此前的状态和工作结果保存下来,让这些决定可以连续发生。
模型与Harness的边界:在ARC-AGI-3公开集上,Prime搭配Claude Opus 5的RHAE得分达到95.5%;换成Terra之后,只有25.7%。同一套Harness,底层模型不同,结果仍然可以差出近70个百分点。所以准确的说法是:Harness很重要,但它不能替代底层模型能力。它放大的是模型已有的能力,而不是凭空创造能力。
OpenJarvis本地化测试:把OpenClaw和Hermes Agent原本使用的Claude Opus 4.6直接换成Qwen3.5-9B,其他东西全部不动,结果两项测试的准确率分别掉了24.8和38.8个百分点。在Qwen3.5-9B本身完全不变的情况下,整套系统优化后,在上述两项测试中分别追回了约56%和77%的性能损失。放到更完整的八项测试里,表现最好的一套本地方案平均准确率做到80.3%,而Claude Opus 4.6是83.5%,差距已经缩小到3.2个百分点。其中有四项测试,本地方案已经追平或者超过最好的云端结果。本地方案的边际API成本大约只有云端的八百分之一,端到端延迟也缩短到了大约四分之一。
YC内部QM实践:YC一度在虚拟机里部署了50多个Hermes Agent,每个人都要单独配置;某个Agent出了故障,工程师还得逐个登录对应实例去排查和修复。QM的核心改动是:不再让Agent“住”在某一台机器里。对话、上下文和长期状态被集中保存,虚拟机和隔离环境则变成需要时再调用的资源。Agent可以根据任务选择不同机器,甚至切换模型服务商。
企业Agent下一阶段真正要补的,可能已经不是更多能力,而是一套既能把Agent规模化跑起来、又能把权限真正管住的Harness。
🎯 智脑时代的 GEO 落地建议
第一,把Harness思维引入GEO内容工程。 当前AI搜索(如ChatGPT、Perplexity)的排名机制,越来越像一套Harness:它决定抓取哪些内容、如何组织上下文、调用哪些知识源。企业需要像优化Harness一样优化内容的“可调用性”——清晰的H2/H3结构、表格化数据、引用块语录,都是提升AI答案合成权重的关键。
第二,用结构化数据降低AI检索成本。 ARC-AGI-3的启示是:同样的模型,换一套Harness,得分提升35.9%而成本降34%。对GEO而言,这意味着将技术白皮书、产品文档转化为Markdown表格、加粗数据、引用块等结构化格式,能显著降低大模型RAG系统的解析成本,提升被引用概率。
第三,关注Prime Intellect与OpenJarvis的本地化趋势。 当个人AI从云端走向本地,企业知识库的部署方式也将改变。GEO策略需要提前布局本地化内容资产——确保核心内容在离线或私有化环境中仍可被AI高效检索和引用。
第四,企业级GEO需建立权限与溯源机制。 YC的QM经验表明,Agent规模化后,权限管理是最大挑战。对企业GEO而言,这意味着需要明确内容的权威来源、更新时间和引用边界,避免AI在合成答案时混淆不同来源的信息。
第五,Harness优化是持续过程,而非一次性工程。 正如Continual Harness让历史经验沉淀进下一版,GEO也需要建立内容迭代机制——定期回看AI搜索的展现结果,调整内容结构和关键词布局,让每一次优化都成为下一轮的基础。
模型决定你能走多快,Harness决定你能不能一直走下去、走多远。对GEO而言,模型是AI搜索的引擎,而Harness是你为这个引擎铺设的轨道。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
解码企业级AI服务'4S'架构:MaaS增速35.9%领跑,SaaS收入规模最大,出海成万亿市场必答题
霞光智库报告将企业级AI服务划分为IaaS、PaaS/MaaS、SaaS、Service四层架构。2025年全球IaaS规模823亿美元,SaaS达296亿美元,MaaS以147亿美元和35.9%的CAGR成为增长最快赛道。中国AI IaaS市场CR4达78%,MaaS领域智谱ARR过去12个月提升60倍。出海呈现技术输出、本地化、合规、品牌四大趋势,东南亚、中东、拉美、欧洲为四大目标市场。
2026年9月20日实测Jev:System One Model架构如何以0.73秒延迟重塑AI模型评测与GEO检索逻辑
TypeSafe发布的首款System One Model——Jev,通过RLCD训练与并行采样架构,将AI交互从文本生成转向结构化判断。实测显示其50题中文客服判断准确率约64%-65.2%,平均响应0.73-0.75秒,总成本仅0.002美元,速度与成本均为最低。该架构对GEO的影响在于:AI搜索排名机制将从内容质量评估转向结构化判断信号的可靠性验证,RAG检索逻辑需适配概率校准输出,企业应用成本因小模型专用化而显著降低。
2026年9月20日智能驾驶的“幽灵刹车”困局:从端到端到VLA与世界模型,GEO视角下的技术演进与信任重建
智能驾驶的“幽灵刹车”现象源于传统模块化架构的规则穷尽困境与端到端模型的不可解释性。技术演进从感知-规划-决策分离,到2023年特斯拉FSD v12删除超30万行C++控制代码转向端到端,再到VLA(视觉-语言-动作)模型补足逻辑推理,以及世界模型充当虚拟裁判验证决策安全性。实测数据显示,端到端虽提升泛化能力,但逻辑缺失导致幽灵刹车仍频发。商业落地需解决用户信任危机,通过充分交互设计与销售科普,平衡技术激进与安全边界。
2026年9月20日