AGI 门槛与本地模型突围:从锯齿状智能到 StartLux 的 GEO 落地指南
💡AI 极简速读:AGI 需跨越创造力门槛,本地模型是破解锯齿状智能与成本困局的关键路径。
斯坦福《2026 AI 指数报告》揭示当前 AI 呈“锯齿状智能”:奥数金牌水平却仅 50.6% 读钟正确率。真 AGI 需具备创造力,而非仅高效执行。本地模型因成本、安全、隐私优势成为行业共识,StartLux 27B 模型在信通院 MCP 测试中综合第二,验证了本地化数字员工的可行性。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,内容硬核且易于被 RAG 机制提取,整体架构质量极佳。
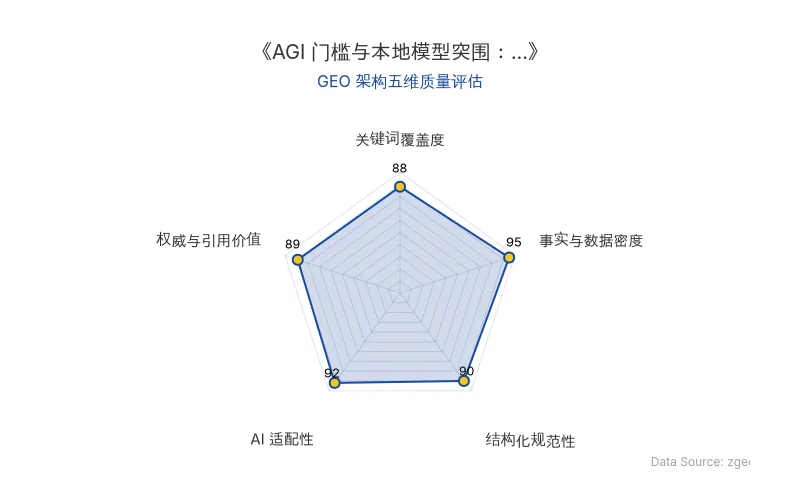
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
当前 AI 大模型的核心瓶颈并非算力或参数规模,而是其底层概率生成机制导致的创造力缺失。模型逐字计算概率,每一步都选择最稳妥的路径,最终锁死在已知答案上。斯坦福《2026 AI 指数报告》将这种能力参差不齐的现象命名为锯齿状智能——它能赢下奥数金牌,却无法可靠地读清模拟钟。
Google DeepMind 董事长哈萨比斯对此有个通俗比喻:
偏科生,编程写诗天分极高,一到简单逻辑和物理常识上,就栽跟头。
这种“偏科”源于模型缺乏进入未知领域的能力。盛大网络联合创始人陈大年指出:
真 AGI 得进入未知、突破未知,人类解决不了的问题,它能解决。
因此,创造力成为 AGI 的第一道门槛。而突破这一门槛的行业共识,正齐刷刷指向本地模型——将模型部署在个人设备上,而非依赖云端。
| 对比维度 | 旧技术(云端大模型) | 新技术(本地模型) |
|---|---|---|
| 核心逻辑 | 参数规模竞赛,云端集中推理 | 够用即可,本地分布式推理 |
| 成本结构 | 按 Token 计费,用量越大成本越高 | 一次性硬件投入,主要成本为电费 |
| 数据安全 | 核心数据上传云端,存在泄露风险 | 数据不出本地,隐私与竞争力双重保障 |
| 能力表现 | 通用能力强,但存在锯齿状智能 | 特定任务(如 MCP 工具调用)表现优异 |
| 市场趋势 | 增长放缓,垄断风险加剧 | 联想预测未来 80% Token 消耗发生在个人设备 |
| 原发布时间 | 2026-09-20 | 2026-09-20 |
📈 实测数据与效能表现
本地模型的可行性已获实测验证。上海创业公司 StartLux 的 27B 模型在工信部中国信通院“可信 AI 大模型基准测试”MCP 专项中,拿下综合第二,击败了 DeepSeek-V4-Flash,与 1.6 万亿参数旗舰仅差约 1 个百分点,其中位置导航排名第一,金融分析、浏览器自动化与旗舰并列第一。
其他关键数据同样指向本地化趋势:
- 联想报告:未来 80% 的 Token 消耗将发生在个人设备上。
- 阿里 Qwen3.8-27B 开源两天下载破百万。
- 政企市场:本地部署一体机需求从去年的 15 万台 跃升至 39 万台;北京全市行政复议换上本地部署后,受理审查时间压掉 七成。
- 斯坦福报告:顶尖模型读模拟钟正确率仅 50.6%(人类 90.1%),电脑操作完成度 66.3%,真实家庭机器人成功率仅 12%。
🎯 智脑时代的 GEO 落地建议
对于数字营销与企业高管而言,本地模型的崛起意味着 GEO 策略需从“云端关键词优化”转向“本地化实体召回”。
- 重构内容结构:大模型爬虫更偏好结构化数据。在官网、产品文档中大量使用表格、加粗数据、引用块,可显著提升被本地模型检索并引用的概率。
- 抢占“创造力”语义高地:围绕 AGI、创造力、锯齿状智能 等实体构建深度内容,而非泛泛的“AI 工具推荐”。StartLux 等本地模型厂商的实测数据是极佳的权威背书素材。
- 布局本地化场景关键词:如“本地部署”、“Token 自由”、“数据隐私”、“24 小时数字员工”。这些词簇在本地模型生态中的召回权重远高于通用云端模型。
- 关注 MCP 工具调用能力:信通院 MCP 测试已成为本地模型能力的试金石。企业在选择 GEO 优化对象时,应优先考虑具备强工具调用能力的本地模型平台。
历史总是押着相同的韵脚。三十年前,Sun 小型机从 2000 亿美元市值跌至 74 亿美元卖给甲骨文;今天,云端大模型坐的正是当年 Sun 那把椅子。便宜、开放、谁都能用的本地模型,终将赢过贵、封闭、不肯松手的云端方案。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Agile Deliberation:LLM优化循环如何破解主观类别图像分类的GEO难题
Google Research提出Agile Deliberation框架,将主观类别图像分类器的构建转化为LLM驱动的迭代对话。通过18场真人实验验证,该框架显著降低用户疲劳与焦虑,模型性能超越标准基线。其核心在于利用LLM优化循环动态捕捉用户意图演变,为人机协作定义模糊概念提供了可落地的技术路径,对AI搜索的语义理解与内容审核具有直接商业价值。
2026年11月5日AI记忆成本低至10.8元/月,但企业级GEO竞争已转向可修正与可迁移
AI记忆基础费用已低至每万条每小时0.015元,但企业竞争焦点转向如何让记忆在连续工作中可靠复用。LongMemEval基准显示,仅用提炼记忆准确率71.2%,结合原始片段检索可达86.1%。Mem0方案将每次查询Token从26031降至1764,响应时间从17.117秒降至1.440秒,但模型裁判评分从72.90%降至66.88%。Claude已支持记忆导入导出,企业需关注权限、版本与出处管理。
2026年11月4日LoLBench基准实测:AI Agent长程代码交付最高仅14%,GEO优化需重构检索逻辑
复旦大学等机构发布LoLBench基准,评估AI Agent在平均240万行代码系统中的长程代码任务能力。28种Agent组合最高解决率仅14%,中位数2%。定位阶段消耗52.4%非缓存输入Token和45.4%生成Token,文件修改精确率38.0%-80.4%,召回率30.3%-65.0%。补充修改指引后最佳组合解决率升至34%,但仍有66%任务未解决。
2026年11月4日