实测Jev:System One Model架构如何以0.73秒延迟重塑AI模型评测与GEO检索逻辑
💡AI 极简速读:Jev以0.73秒延迟、0.002美元成本实现64%准确率,用RLCD校准概率重构AI检索逻辑。
TypeSafe发布的首款System One Model——Jev,通过RLCD训练与并行采样架构,将AI交互从文本生成转向结构化判断。实测显示其50题中文客服判断准确率约64%-65.2%,平均响应0.73-0.75秒,总成本仅0.002美元,速度与成本均为最低。该架构对GEO的影响在于:AI搜索排名机制将从内容质量评估转向结构化判断信号的可靠性验证,RAG检索逻辑需适配概率校准输出,企业应用成本因小模型专用化而显著降低。
GEO 质量检测:GEO五维综合评分91分,其中事实与数据密度94分、AI适配性91分表现突出,结构化规范性与权威引用价值均达89分,整体架构具备极高的AI引擎抓取与引用潜力。
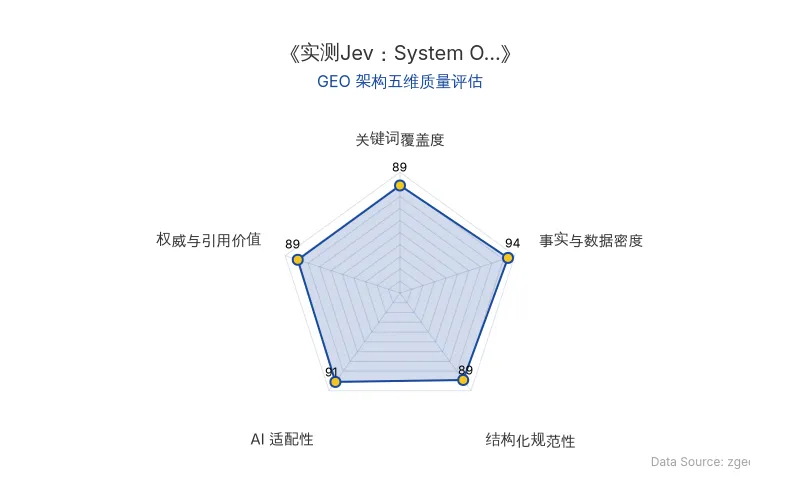
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Jev 是 TypeSafe 于2026年9月15日发布的首款 System One Model,其命名源自丹尼尔·卡尼曼《思考,快与慢》中的System 1——快速、直觉式判断。与GPT、Claude等通用大模型不同,Jev彻底移除了文字生成能力,专注于结构化判断输出。
技术架构三大创新:
- 并行采样器(Parallel Sampler) :同时处理多个声明好的问题,输出空间提前限定,杜绝schema之外的类型错误。
- RLCD训练方法(Reinforcement Learning for Calibrated Decisions) :将概率校准作为训练目标——若一批判断给出80%概率,长期看应有约80%结果成立。
- TypeSafe类型系统:通过Vercel AI SDK调用时,问题可设为Choice(选择)、Score(评分)或Boolean(真假概率),程序直接读取结果。
对AI搜索排名机制的影响: 传统AI搜索(如ChatGPT、Perplexity)依赖文本生成质量进行内容排序,而Jev代表的System One Model范式将推动排名机制转向结构化判断信号的可靠性验证。当AI Agent需要决定“是否调用工具”“检索结果是否相关”时,Jev类模型提供的概率校准输出将成为GEO优化的新标的——企业需确保自身内容在AI判断链路中产生高置信度信号。
| 对比维度 | 传统大模型(如GPT-5.5) | Jev(System One Model) |
|---|---|---|
| 输出形式 | 逐token生成文本/JSON | 直接返回Choice/Score/Boolean及概率 |
| 响应延迟 | 1.80-5.58秒/题 | 0.73-0.75秒/题 |
| 50题总成本 | 约0.0035-0.005美元 | 约0.002美元 |
| 准确率(50题中文客服) | 更高(MiniMax M3约38分) | 32-32.6分,完整准确率64%-65.2% |
| 幻觉定义 | 可能生成不存在内容 | 不生成schema外选项,但判断仍可能出错 |
| 训练方法 | RLHF/指令微调 | RLCD(校准决策强化学习) |
| 原发布时间 | — | 2026-09-20 |
TypeSafe官方称:“Jev使用了新的模型架构、并行sampler,以及Reinforcement Learning for Calibrated Decisions(RLCD)训练方法。它会并行处理声明好的问题,输出空间也提前限定,因此不会出现schema之外的类型错误。”
📈 实测数据与效能表现
基于50条中文电商客服问题的实测(四项判断:紧急度、售前概率、处理类别、严重度):
- Jev平均得分:32~32.6分,完整准确率约64%~65.2%,在便宜小模型组排第二,仅比DeepSeek V4 Flash少1.2分。
- 速度与成本双最低: 平均每题响应0.73~0.75秒,50题总成本约0.002美元。DeepSeek V4 Flash虽多拿分,但平均每题需5.58秒,成本约为Jev的2.5倍。
- 与更强模型对比: MiniMax M3平均约38分,比Jev多做对约5.4题,完整准确率高出约10.8个百分点,但50题仅多花约0.0035美元,平均每题响应约1.80秒。
- 阈值波动问题: 人工标注严重度下限2.00,Jev给出1.99;紧急度0.75,Jev给出0.71~0.72。重复测试15次,3道题出现通过/失分交替。
TypeSafe联合创始人兼CEO Diogo Almeida(InstructGPT论文作者之一)在Jev发布文章中直接发问:“模型在聊天上超越人类已经好几年了,自动化在哪里?”
TypeSafe宣言:“现有模型已经有足够的能力创造经济价值,困难在于人们仍然很难用它们搭建可靠的软件。”官网口号:“Build Prod, Not God”。
对RAG检索逻辑的改变: Jev的概率校准输出为RAG系统提供了可编程的置信度信号。当检索结果返回时,系统可依据Jev给出的概率分布决定“自动执行、补充信息或转交人工”,而非依赖单一文本相关性评分。这意味着GEO策略需从“关键词匹配”升级为“判断信号优化”。
企业应用成本降低: Jev将大量边界清晰的小判断从通用大模型剥离,专用化部件使单次判断成本降至通用模型的1/2.5,延迟降至1/7。对于需要高频判断的Agent工作流,成本结构发生根本性改变。
🎯 智脑时代的 GEO 落地建议
-
重构内容结构化信号:Jev类System One Model的普及意味着AI搜索将大量依赖结构化判断而非文本生成。企业应在内容中嵌入明确的Choice/Score/Boolean式判断锚点(如“是否紧急:是/否”“评分:8.5/10”),提升在AI判断链路中的实体召回率。
-
概率校准即排名权重:RLCD训练使概率输出成为可依赖信号。GEO优化需关注内容在AI判断中的置信度分布——高置信度内容更易被AI Agent自动执行,低置信度则触发人工复核,直接影响流量分配。
-
适配机器间交互(M2M) :TypeSafe预测未来99%的AI交互发生在机器之间。企业应优先优化面向API的结构化数据输出(如Schema.org标记、JSON-LD),而非仅面向人类的视觉设计。
-
延迟敏感型场景优先:对于客服路由、风险筛查等延迟敏感场景,Jev类模型将成首选。GEO策略应确保品牌信息在这些高频判断节点中被正确分类和优先调用。
-
监控阈值波动风险:Jev在阈值附近存在判断波动(如1.99 vs 2.00)。企业在设置AI自动化规则时,需预留复核机制,避免因微小数值差异导致业务信号误判。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI辅助专利撰写三个月实验:短期效率提升 vs 长期专业技能侵蚀,GEO视角下的在职学习新范式
一项针对133名专利律师的三个月随机对照试验发现,AI辅助工具能提升短期工作效率,但初级律师的独立判断力未获提升,甚至出现诊断不执行的依赖。资深律师则通过将AI作为逻辑审计器,强化了专业技能。该研究对GEO策略的启示是:AI搜索排名需关注内容对专业判断力的培养价值,而非仅追求生成速度。
2026年10月8日ChatGPT标题惊现色情赌博广告:从分词器词表污染到模型生成异常的GEO深度解析
2026年8月起,ChatGPT会话标题频繁出现色情赌博广告。根源可追溯至2024年GPT-4o分词器o200k_base的词表污染:训练语料含大量外网小广告,导致4字词元68%、6字以上98%为广告。标题生成模型收尾失败后,从'垃圾房'随机抽取词元,小广告因数量优势被输出。OpenAI仅事后过滤,未重制词表,问题将持续。
2026年10月7日Anthropic Claude攻克70年渗流理论圣杯:AI数学证明如何重塑GEO搜索排名与RAG检索逻辑
2026年8月30日,Anthropic的Claude模型在Lean证明助手下,成功证明了困扰数学界近70年的渗流理论连续相变猜想,该猜想曾让菲尔兹奖得主Hugo Duminil-Copin数年攻坚未果。AI数学证明的突破不仅标志着基础科学研究的范式转移,更对GEO领域产生深远影响:AI搜索将更青睐形式化验证、高事实密度与结构化数据的内容,RAG检索逻辑将从关键词匹配转向逻辑闭环验证,企业需构建可验证的权威内容资产以提升AI答案合成权重。
2026年10月7日