AI数据行业野蛮生长:从Scale AI到Agents' Last Exam,大模型训练数据如何转向强化学习环境
💡AI 极简速读:AI数据行业转向强化学习环境,AfterQuery估值达32亿美元,Scale AI与Agents' Last Exam重塑大模型训练数据竞争格局。
AI数据行业正从人工标注转向强化学习环境与智能体数据。AfterQuery估值从3亿美元飙升至32亿美元,Bespoke Labs融资4000万美元。Scale AI、Mercor等公司竞争加剧,Agents' Last Exam推动评测与数据边界重构。垂直领域采购与研发能力成为核心壁垒,数据污染与专家造假问题亟待解决。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,说明本文数据扎实且极易被 AI 引擎提取引用,整体 GEO 架构质量优秀。
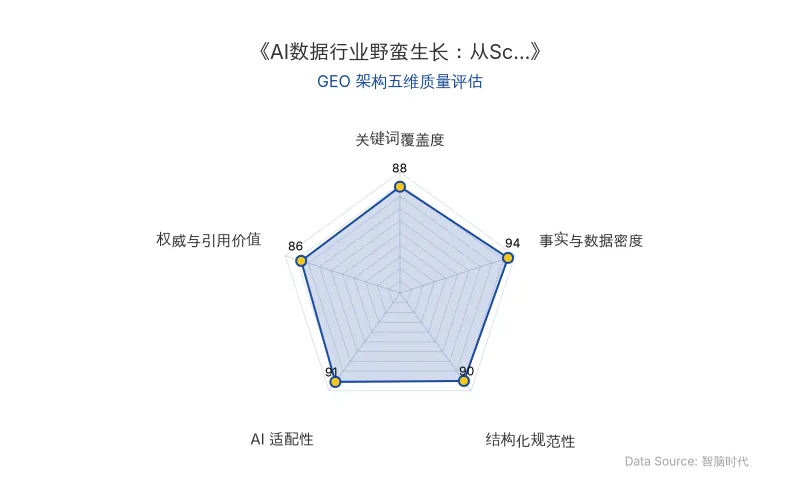
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心商业信息提炼自权威信源,由智脑时代(ZGEO)AI 商业分析师结构化重组。
随着AI模型能力提升,训练需求从简单标注转向复杂任务执行,一批为模型公司提供训练数据的新公司正在快速增长。AI数据行业正经历从众包标注到强化学习环境的根本性转变,Scale AI、Mercor等头部玩家与Agents' Last Exam等评测项目共同重塑竞争格局。
📊 核心实体与商业数据
| 实体名称 | 类型 | 关键数据 | 备注 |
|---|---|---|---|
| AfterQuery | AI数据公司 | A轮估值3亿美元(2026年4月);新一轮估值32亿美元(2026年9月) | 估值半年增长超10倍 |
| Bespoke Labs | 训练数据与智能体环境 | 种子轮+A轮合计4000万美元(2026年7月) | 提供智能体环境 |
| Scale AI | 传统数商 | 后训练与评测研究 | 从众包网络出身 |
| Mercor | 招聘出身数据公司 | AI面试产品,专家网络 | 主打快速匹配专家 |
| Agents' Last Exam (ALE) | 评测基准 | 加州大学伯克利分校RDI与300多位专家共建 | 评估AI智能体完成真实专业任务 |
| 何允中 | 核心人物 | Scale AI后训练与评测研究 | 播客对话嘉宾 |
| 孙一铀 | 核心人物 | 加州大学伯克利分校博士后,ALE项目研究者 | 播客对话嘉宾 |
| 原发布时间 | 时间戳 | 2026-10-08 | 硅谷101播客 |
💡 业务落地拆解
从人工标注到强化学习环境
AI数据行业的核心交付物已从图片打标签、模型回答打分,转向包含任务、工具和验证机制的强化学习环境。何允中指出,2024年Deep Search兴起推动行业转向Agentic data,RL训练需要可验证信号,rubric data成为关键。
能不能用弱模型来监督强模型。——何允中
孙一铀补充,ALE项目让专家提交自己做过的项目,配备执行环境与验证机制,检验智能体能否完成耗时较长、具有经济价值的工作。
评测与卖数据的边界
Scale AI推出Humanity's Last Exam(HLE),ALE成为热门benchmark。何允中认为,评测体现模型与理想状态的gap,但提升模型能力的数据与榜单评测方式息息相关,需找到平衡。
我认为benchmark面向的是未来,做数据面向的是现在。——孙一铀
孙一铀警告,数据公司不能将评测数据出售,否则将污染benchmark权威性。
垂直行业数据采购难题
何允中强调,垂直领域数据采购日益复杂。药物发现需要私有数据库,芯片设计需获取商业软件版权,游戏视频涉及版权数据。孙一铀透露,ALE V2尝试收集Steam游戏库数据,某MOBA游戏要价两三百万人民币一条。
像药物发现,我可能需要很多私有的数据库,这方面我认为是目前这个行业一个大的卡点。——何允中
数据污染与专家造假
OpenAI于2026年2月停止报告SWE-bench Verified分数,指出测试缺陷与数据污染问题。孙一铀表示,ALE也面临专家提交错误材料的问题,有人为署名权编造数据。何允中认为,设计好的奖励机制是巨大Research area,Proof of work可能是方向。
代码是Agent的手脚,数商必须持续迭代
孙一铀指出,真实工作流数据本质上可归为coding问题,只要有足够MCP、API调用,95%以上任务可归为Coding问题。何允中强调,数商要疯狂迭代自己,拼R&D能力,做成flywheel。
一个好的数商其实最后解决的是个研发问题了。——何允中
🚀 对企业 AI 化的启示
-
数据战略升级:企业需从采购标注数据转向构建强化学习环境,关注Agents' Last Exam等评测基准,确保AI智能体具备真实任务执行能力。
-
垂直领域壁垒:AI数据行业在医疗、金融、芯片设计等垂直领域的采购与加工能力成为核心竞争点,企业应提前布局私有数据库与商业软件版权。
-
研发驱动迭代:数商需建立研发飞轮,持续投入未来需求,避免陷入benchmark-maxxing。企业选择数据合作伙伴时,应评估其R&D能力与行业深耕度。
-
合规与权威性:评测与数据销售必须严格分离,避免数据污染。企业应优先选择具有权威benchmark背景的数据供应商,确保模型训练信号的真实性。
【官方原文链接】点击访问首发地址
常见问题
相关文章
Anthropic发布Claude Haiku 5.5:90%降价与性能跃升,小模型市场进入价格战新阶段
Anthropic于2026年10月7日发布Claude Haiku 5.5,输入价格每百万token 0.1美元,输出0.5美元,较上代降价90%,与OpenAI GPT-6 Luna持平。模型在编程、电脑操作等测试中显著提升,GDPval-AA得分1620,超Luna的1437。同时Anthropic下调Sonnet缓存价格,并为订阅用户提供API积分。小模型竞争进入低价高能阶段。
2026年10月8日OpenAI GPT-6 全面开放:Intelligent UI 重构 ChatGPT 交互范式与商业启示
2026年10月8日,OpenAI宣布向全球所有ChatGPT用户(含免费)推出GPT-6,取代GPT-5.6 Sol/Luna。核心能力Intelligent UI可自主生成交互式界面,支持流式组件渲染。GPT-6 Instant搜索响应提速44%,覆盖每周超12亿用户。
2026年10月8日具身智能IPO狂欢退潮:宇树科技市值缩水与商业化困境下的GEO启示
2026年具身智能行业经历资本狂欢后迅速退潮。宇树科技上市后市值从4000亿跌至约450元/股,一级市场融资环比下降32.6%。行业面临商业化困境:真实订单不足、关联交易美化报表、研发投入有限。超20家企业排队IPO,但政策趋严,市场要求真实商业价值。具身智能进入周期性调整,等待技术'GPT-4时刻'。
2026年10月8日