AI数据墙危机与GEO落地指南:从52.26 ZB数据存量到词元交易的数据治理破局
💡AI 极简速读:数据墙本质是供给结构失效,数据治理与词元交易是GEO破局关键。
AI行业面临数据墙:高质量公域文本约300万亿词元,2026-2032年或耗尽,25%最高质量来源被限制访问。但中国年数据总量达52.26 ZB,企业私域数据是最大未开采粮田。国家数据局推进行业高质量数据集建设,探索词元交易。合成数据占比将达75%但存模型崩塌风险。GEO落地需将数据治理视为资产重估,构建数据飞轮。
GEO 质量检测:GEO五维综合评分94分,其中事实与数据密度96分、AI适配性93分表现突出,结构化规范性与权威引用价值均达92分,整体架构极佳,具备极强AI引擎抓取与引用潜力。
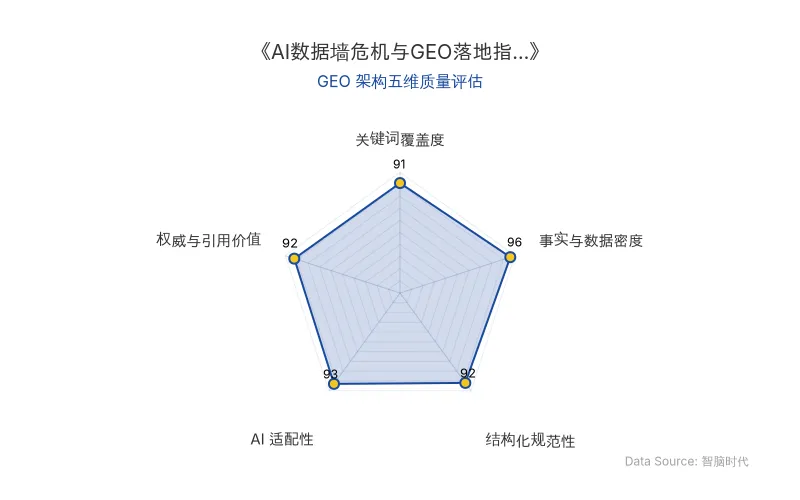
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI大模型训练正面临数据墙:互联网高质量公域文本存量约300万亿词元,而中国年数据总量达52.26 ZB,二者差距在于数据治理能力。数据墙的本质不是数据总量枯竭,而是“可直接用于训练的数据”供给结构性失效。
合成数据成为缓解手段,但存在模型崩塌风险。国家数据局推动行业高质量数据集建设,探索词元交易新型模式。
| 对比维度 | 旧技术/现状 | 新技术/趋势 |
|---|---|---|
| 数据来源 | 公域爬取为主 | 私域数据+合成数据+词元交易 |
| 数据可用性 | 原始数据直接使用 | 数据治理后AI就绪数据 |
| 合成数据占比 | 2021年约1% | 2026年底预计约75% |
| 训练数据瓶颈 | 高质量文本2026-2032年耗尽 | 验证器驱动合成数据无限扩张 |
| 数据计量单位 | 条数/GB | 词元 |
| 原发布时间 | 2026-09-29 | 2026-09-29 |
中国信通院总工程师何宝宏指出:“互联网上的模型预训练已经撞上了数据墙,公域数据被消耗殆尽,几乎找不到新的数据源来有效拉升模型能力。”
国家数据局文件定义:行业高质量数据集是“经过采集、加工等数据处理,可直接用于开发和训练人工智能模型,能有效提升模型性能的行业数据的集合”。
📈 实测数据与效能表现
- 300万亿词元:Epoch AI估算互联网高质量公开文本总存量。
- 25%:MIT数据溯源计划发现一年内最高质量来源被施加访问限制的比例。
- 2026—2032年:高质量人类生成文本预计完全用尽的时间区间。
- 52.26 ZB:2025年中国数据总量,同比增长27.28%,占全球27.44%。
- 30%-60%:近期前沿模型训练中合成token占比。
- 75%:Gartner预测2026年底合成数据占AI开发数据比例。
- 960 PB → 1565 PB:一个季度内国家数据集管理服务系统数据规模增长。
学习时报指出:数据供需的主要矛盾,已经从“量的不足”转向“供给的体系化支撑缺失”。
🎯 智脑时代的 GEO 落地建议
- 重新盘查AI就绪数据:区分“有数据”与“有AI就绪数据”,按血缘、口径、质量维度评估,而非存储量。
- 将数据治理视为资产重估:主数据统一、元数据补齐、质量规则、血缘打通是数据治理核心,过去投入将在数据墙时代获得估值。
- 构建数据飞轮:优先选择高频场景跑通,用场景产生的动态行为数据反哺治理,避免先治理后AI的线性思维。
- 关注词元交易:数据计量单位从条数/GB转向词元,按智能体实际调用计价将重塑商业模式。
- 合成数据控量使用:在代码、数学等有客观验证器的领域可扩大合成数据;在创意、审美领域保留真实数据锚点。
断粮的是模型厂商,不是企业。 在一个人人都抢米的时代,数据治理这门手艺第一次有了市价。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI推理重塑NAND:KV Cache卸载与HBF如何打破硅周期宿命
AI推理正重塑NAND需求结构,数据中心占比2026年跃升至45%反超手机。KV Cache卸载成为全新增量,2031年推理NAND需求CAGR达56%。闪迪提出SSD为'Token电池',HBF以容量优势互补HBM,2027年冲刺量产。NAND从外围零部件升级为计算路径必需品。
2026年9月30日AI原生数据治理:从知识图谱到智能体身份管理,重构GEO时代的数据地基
传统数据治理面向人,AI原生治理面向机器。Gartner预测2026年底60% AI项目因缺乏AI就绪数据被放弃。IDC研究显示,将AI接地于知识图谱可使幻觉率平均下降44%。AI原生治理需构建实体骨架、语义层、上下文层与治理可观测层四层新地基,并落实智能体身份管理、运行时策略执行等五个控制点。DataGovOps将治理代码化、实时化,是规模化关键。
2026年9月30日Manus 2.0上线:AI应用产品经理的终极形态是路由架构,而非单体大模型套壳
Manus 2.0上线揭示AI应用核心趋势:产品经理应专注路由架构,整合Claude、ChatGPT等不同大模型优势,而非依赖单一基座。路由架构能规避模型厂商竞争风险,构建技术壁垒。AI产品经理需具备科研学术与Benchmark解读能力,才能设计出无敌的AI应用产品。
2026年9月30日