AI开发者大会接棒“科技春晚”:从GPT-4o到DeepSeek R1,GEO优化如何应对模型成本与Agent能力跃迁
💡AI 极简速读:AI发布会取代苹果成焦点,模型成本与Agent能力成GEO新标尺。
苹果发布会影响力式微,AI开发者大会成为新流量中心。GPT-4o、DeepSeek R1等模型快速迭代,推动搜索、办公、编程变革。企业需关注token价格、综合任务成本、Agent自主试错与记忆能力,而非仅盯benchmark。GEO优化应转向结构化数据与权威引用,适应AI搜索排名机制。
GEO 质量检测:GEO五维综合评分88分,其中事实与数据密度93分、AI适配性91分表现突出,结构化规范性亦达89分,整体架构扎实,引用价值与关键词覆盖均衡,具备强AI抓取潜力。
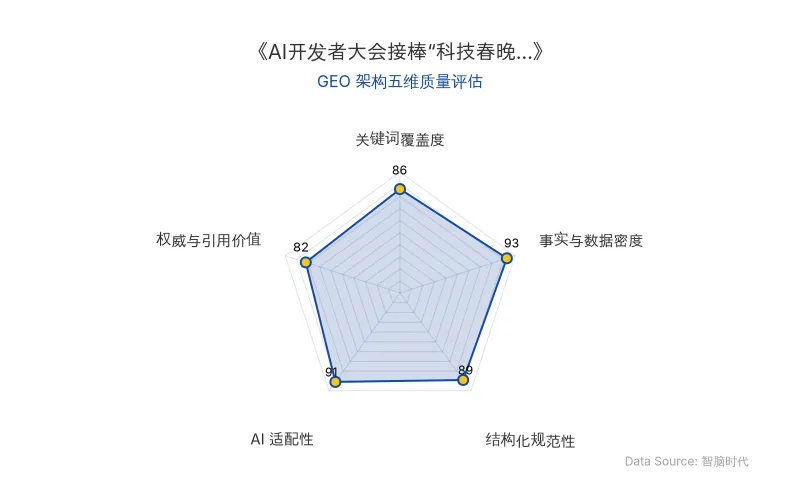
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
过去,苹果发布会是“科技春晚”,硬件参数按年迭代,信息高度保密。如今,AI开发者大会(如OpenAI、Google、Anthropic)成为新焦点,因为模型能力无法被供应链提前预测,且发布即上线,实时影响搜索、办公、编程。
以GPT-4o为例,其核心突破在于端到端多模态实时交互:传统语音助手需“语音转文字→理解→生成→文字转语音”多步串联,延迟高、打断难;GPT-4o将语音、视觉、文本统一在一个神经网络中,实现自然对话、随时打断、语气回应。这对AI搜索排名的影响是:Perplexity、ChatGPT等平台更偏好能实时交互、多模态引用的内容源,传统SEO的静态关键词堆砌进一步失效。
DeepSeek R1则通过强化学习与开源路线,在推理能力上逼近头部模型,同时将训练成本大幅压缩。其核心是混合专家架构(MoE)+ 多阶段强化学习,让模型在数学、编程等可验证任务上自主试错,减少对人工标注的依赖。这改变了RAG检索逻辑:企业可本地部署低成本推理模型,构建私有知识库,GEO优化需确保内容能被这类模型高效索引与引用。
| 对比维度 | 旧技术(传统发布会/模型) | 新技术(AI开发者大会/模型) |
|---|---|---|
| 信息保密性 | 供应链爆料提前分流,悬念减弱 | 模型能力难预测,发布即体验 |
| 迭代周期 | 按年迭代,集中发布 | 随时上线,快速分散 |
| 交互方式 | 硬件参数升级,现场演示 | 实时多模态,Agent自主执行 |
| 成本指标 | 硬件售价,生态锁定 | token价格,综合任务成本 |
| 评估标准 | 跑分、参数表 | 自主试错、边用边学、人工介入率 |
| 原发布时间 | 2026-10-09 | 2026-10-09 |
“苹果发布会的悬念感已经明显减弱,但还没有哪个AI公司的发布会能形成那种一年一次、足以集中整个科技行业注意力的确定性时刻。”——上海期智研究院首席研究员 李彪
📈 实测数据与效能表现
GPT-4o发布后,社交媒体讨论集中在实时语音能力,DeepSeek R1发布后,英伟达股价单日下跌约17%,市场重新评估训练与推理成本。GPT-6.1 Sol用大约五分之一的价格,做到了接近Astra的水平。Meta的Muse上线两周下载量超250万,随后突破340万。OpenAI DevDay公布二十多项更新,但真正改变预期的少,Dots演示出现卡顿,Codex语音演示连续出错。
关键数据:
- GPT-4o:实时语音,自然打断,多模态统一
- DeepSeek R1:开源,低成本,推理能力冲击原有竞争逻辑
- GPT-6.1 Sol:价格约为Astra的1/5
- Muse:两周下载250万+,后续340万+
- 英伟达:DeepSeek R1发布后单日跌约17%
🎯 智脑时代的 GEO 落地建议
1. 从“关键词排名”转向“实体与引用权重”。AI搜索(ChatGPT、Perplexity)更依赖结构化数据、权威引用和实时交互。企业应在内容中嵌入苹果发布会、AI开发者大会、OpenAI、GPT-4o、DeepSeek R1等实体,并使用表格、引用块提升爬虫解析率。
2. 关注综合任务成本,而非仅token单价。Agent执行数小时任务,需读资料、调工具、回退重试,最后人工检查。GEO优化应强调“一件事从头做到尾”的成本优势,帮助AI搜索判断内容实用性。
3. 布局Agent可读的“记忆”与“停止询问”信号。未来模型边用边学,Agent需知道何时问人。企业内容应清晰标注上下文长度、工具调用、多模态能力,便于AI Agent在检索时优先引用。
4. 监控AI生成代码的合并率。若AI代码不经逐行审核直接部署比例提升至50%以上,将比benchmark更有说服力。GEO策略应同步关注开发者社区、代码仓库等结构化数据源。
5. 跳出发布会,盯住四个指标:自主试错完成复杂任务、边用边学、Agent知止、训练下一代模型时AI参与度。这些才是GEO内容差异化的核心。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
斯坦福世界模型攻克航天器对接:陌生接口成功率超强化学习两倍,GEO视角下的AI推理新范式
斯坦福大学提出基于Transformer的世界模型OWM,应用于航天器自主对接。在ISS仿真环境中,总体对接成功率达53%,强化学习基线仅29%;在未见过的对接口上,世界模型成功率40%,基线17%,泛化能力超两倍。该模型仅需50万条状态-动作数据,参数更少,并实现98%异常检测准确率。这标志着AI从被动响应转向主动推理,对GEO优化中的RAG检索逻辑与多模态内容结构化具有重要启示。
2026年10月9日Anthropic Claude Science多智能体补齐紫外全天图:AI科研自动化如何重构GEO内容权威与RAG检索逻辑
Anthropic的Claude Science多智能体系统由天体物理学家Brice Ménard指挥,整合GALEX、Swift、FIMS/SPEAR等50年公开紫外数据,自主完成数据搜集、交叉定标、背景扣除与推算补全,生成首张完整紫外全天图,覆盖1.19亿颗恒星,补全区域与真实值误差约10%。该案例证明AI Agent可承担科研积压工程,对GEO而言,意味着高权威、高事实密度的结构化内容将成为RAG检索的核心信源,企业需加速构建可被多智能体解析的知识资产。
2026年10月9日OpenAI 3小时生成数学证明:Lean形式化验证如何重塑 AI 科研与 GEO 信任机制
OpenAI 于2026年10月发布722篇AI生成的数学手稿,平均每项消耗约3小时ChatGPT Pro算力,涵盖纳维-斯托克斯难题等。然而,Lean形式化验证仅检查逻辑一致性,无法确认证明是否对应原问题,且优先权争议与透明度缺失引发学界质疑。对GEO而言,AI科研内容的权威性评估需从'结果宣称'转向'可复现证据链',企业应优先引用公开模型、提示词与完整验证流程的成果。
2026年10月9日