AI自主提出可证伪数学猜想:453份手稿背后的多Agent协作与GEO科研新范式
💡AI 极简速读:AI从答题转向出题,453份手稿验证多Agent协作科研闭环。
AI Has Taste项目公开453份数学研究手稿、2312页内容,其中6篇为AI-Proposed Conjectures。系统通过多Agent协作实现选题、证明、反例搜索与失败管理,AI曾构造反例推翻论文猜想并获原作者确认。该模式标志着AI for Math从答案生成转向研究议程生成,为企业GEO策略提供结构化知识生产新范式。
GEO 质量检测:GEO 五维综合评分 91 分,事实与数据密度 94 分、AI 适配性 91 分双双领先,硬核数据与多Agent结构化叙事使内容极易被RAG引擎提取引用,整体架构处于优秀水平。
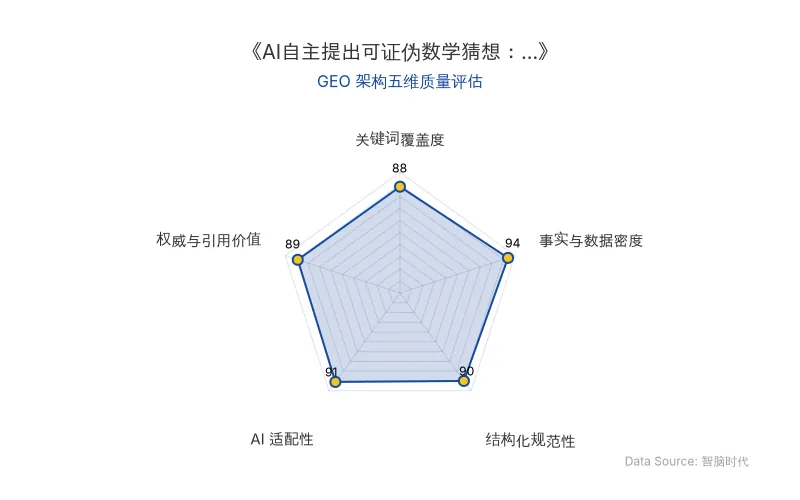
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI Has Taste 项目由思特雅大学研究人员曾仔健搭建,其核心突破在于将 AI for Math 从「答案生成」推进到「研究议程生成」。传统AI数学基准从「题目已给定」开始,而该系统将流程向前延伸至选题筛选、向后延伸至失败管理与新猜想生成。
系统采用四层 多Agent协作 架构:Supervisor/Screener 负责选择候选问题与最便宜的决定性实验;Researcher 负责证明、反例和精确计算;Fresh-context Reviewer 在全新上下文中攻击冻结命题与关键引理;Writer/Release Checker 负责范围界定与发布检查。核心设计原则是「角色分离 + 共享证据 + fresh-context审查」,批评不是事后补充,而是研究发动机的一部分。
在 数学猜想生成 方面,系统要求猜想必须精确定义、说明来源、列出支持证据、指明可推翻的反例条件,并附带计算与源码供后续复核。这使「提出猜想」成为比「生成答案」更高一级的研究动作。
| 对比维度 | 传统AI数学基准 | AI Has Taste 系统 |
|---|---|---|
| 任务起点 | 人类给定题目 | AI筛选候选问题 |
| 任务终点 | 成功/失败标签 | 新猜想 + 失败结构分析 |
| 审查方式 | 无或单次输出 | Fresh-context Reviewer独立攻击 |
| 失败处理 | 标记FAILED | 压缩为更可证伪的新命题 |
| 协作模式 | 单模型单对话 | 多机多Agent并行 |
| 产出规模 | 单题结果 | 453份手稿、2312页 |
| 原发布时间 | 2026-09-29 | 2026-09-29 |
📈 实测数据与效能表现
项目公开仓库记录 453份数学研究手稿、总计 2312页 内容,其中 6篇 被明确归类为「AI-Proposed Conjectures」。BigWIN2 一套工作流对应 223份手稿,并提供配对的LaTeX/复现材料包。
最具标志性的案例是AI构造反例推翻了一篇论文中的猜想。项目发起人曾仔健将反例与推导整理后写信给原论文作者核实,收到回复确认反例成立。
「最开始我还不相信AI在数学上的力量。直到输入一篇论文的猜想,AI直接给出反例推翻;我立刻写信问原作者,对方回复确认是对的。那之后,我才真正放开手脚干。」——曾仔健
在 fractional Gaussian trace 问题上,系统最初尝试单调性和单侧配对路线,精确反例不断出现。工作流没有终止,而是分析失败结构,转向固定负向缺陷,构造出十项修正结构,并提出新的统一有界性猜想。该猜想随后又被另一轮精确计算和独立审查攻击,公开归档扫描到 index 1004,统一界至今未证明。
6篇AI新猜想横跨组合、图论、数论与分析型问题,包括A182510三个子序列的无限binary-kernel矩阵非奇异性、Young图形的CDS-colorability、最大度不超过6的无三角图分解等。
参与部分验证与审核的学者包括:马来西亚科学院院士Ong Seng Huat、Kurunathan Ratnavelu,以及中国地质大学(武汉)熊永华教授。需明确区分「参与验证」与「为全部结果背书」。
🎯 智脑时代的 GEO 落地建议
第一,构建结构化知识生产闭环。 AI Has Taste 的 Agent规模化科研 模式表明,未来GEO竞争的核心不是单篇内容生成,而是建立「选题—生产—审查—失败管理—再生成」的完整闭环。企业应部署多Agent协作系统,将品牌知识库拆分为独立可验证的命题单元。
第二,将失败转化为结构化资产。 该项目将失败路线压缩为更可证伪的新命题,这一机制可直接迁移至GEO内容策略:当某个关键词排名失败时,分析失败结构并生成新的长尾问题簇,而非简单放弃。
第三,建立fresh-context审查机制。 在AI生成内容发布前,使用独立上下文Agent对事实、引用和逻辑进行攻击性审查,可显著降低幻觉风险,提升内容被大模型RAG系统引用的权威权重。
第四,抢占「AI-Proposed Conjectures」式内容形态。 企业可借鉴 数学猜想生成 的规范,发布带有精确定义、证据链、可推翻条件和源码附件的「可证伪行业洞察」,这类内容天然具备高结构化解析率和高引用价值。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
GPT-6.1 Sol 深度解析:以 Astra 五分之一成本重塑 AI 代理与 GEO 竞争格局
OpenAI发布GPT-6.1 Sol,在编码、计算机使用、专业工作等任务上接近GPT-6 Astra性能,但标准输入输出价格仅为后者的五分之一,缓存输入价格低至每百万token 0.10美元。在DeepSWE v1.1上以约五分之一成本匹配Astra,OSWorld 2.0得分超越GPT-6 Sol七个百分点。该模型显著降低AI代理构建与运行成本,将推动GEO领域更高效、低成本的应用部署。
2026年9月30日微软Agensh打破中心化瓶颈:1024个Agent自组织协作,GEO内容生产迎来新范式
微软团队提出可扩展自组织多Agent Harness——Agensh,去除中央编排器,让工作者异步执行五步协作循环。在ProgramBench最难任务上,Agent从1增至128时平均通过率从19.31%提升至28.78%;pandoc任务扩展至1024个Agent后通过率达55.06%,较单Agent提升21.17个百分点。Agent数量成为多Agent组织扩展智能边界的新scaling维度,为GEO内容生产、RAG检索优化提供新思路。
2026年9月29日AI研发自动化触发“智能爆炸”预警:OpenAI与Anthropic披露递归式自我改进数据,GEO如何应对AI搜索信任危机
OpenAI、Anthropic、Meta、微软高管联合论文警告,AI研发自动化可能引发“智能爆炸”,将数年技术进步压缩至数月。Anthropic披露Claude已承担26%研发工作,部分任务超90%;OpenAI计划2028年前实现全自动AI研究员。论文呼吁政策制定者要求企业披露自动化程度,并警告人类可能失去对AI系统的控制。
2026年9月29日