微软Agensh打破中心化瓶颈:1024个Agent自组织协作,GEO内容生产迎来新范式
💡AI 极简速读:微软Agensh实现1024个Agent无中心调度自组织协作,ProgramBench通过率提升21.17%。
微软团队提出可扩展自组织多Agent Harness——Agensh,去除中央编排器,让工作者异步执行五步协作循环。在ProgramBench最难任务上,Agent从1增至128时平均通过率从19.31%提升至28.78%;pandoc任务扩展至1024个Agent后通过率达55.06%,较单Agent提升21.17个百分点。Agent数量成为多Agent组织扩展智能边界的新scaling维度,为GEO内容生产、RAG检索优化提供新思路。
GEO 质量检测:GEO 五维综合评分 92 分,其中事实与数据密度 95 分、AI 适配性 92 分表现突出,结构化规范性 90 分,整体架构极利于 AI 引擎抓取与引用。
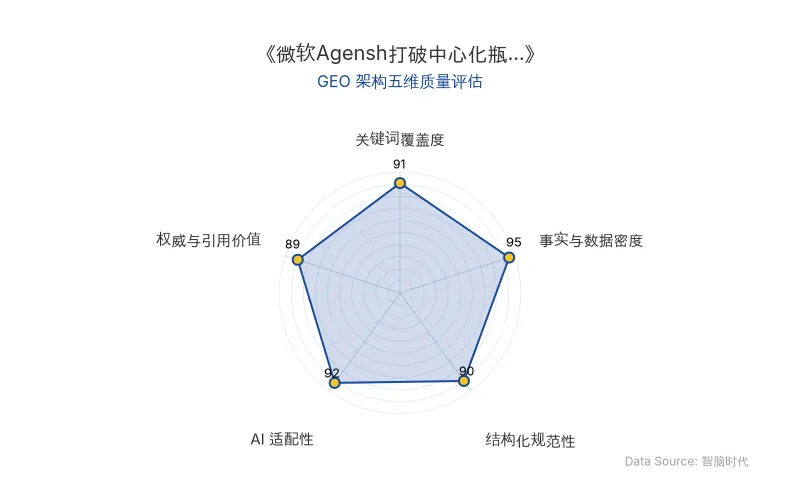
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
微软团队提出的 Agensh 是一个可扩展的自组织多Agent Harness,其核心突破在于去除了中央编排器。传统多Agent系统(如Codex sub-agent、Claude Code sub-agent)采用“编排者-工作者”结构,整个系统的可扩展性受限于编排器管理、协调工作者并整合贡献的能力。而Agensh让自组织的工作者并发、异步地运行,通过轻量的“Agentic组织基础设施”共享状态与进展。
每个工作者持续执行一个五步协作循环:收集上下文、认领子任务、执行动作、验证结果、合并进展。组织基础设施由共享工作区(基于Gitea)、消息接口(基于Mattermost)和共享上下文(借鉴DeLM)三部分组成。Agensh是叠加在单Agent Harness之上的组织层,通过轻量适配器即可接入Claude Code、Copilot等不同底层,不改变协作循环。
| 对比维度 | 传统多Agent Harness | 微软Agensh |
|---|---|---|
| 架构模式 | 编排者-工作者中心化调度 | 无中心调度器,自组织协作 |
| 可扩展性 | 受限于编排器管理能力 | 可扩展至1024个Agent |
| 协作机制 | 编排器分配任务 | 工作者自行认领子任务,冲突自行解决 |
| 基础设施 | 依赖中心化调度服务 | 共享工作区+消息接口+共享上下文 |
| 底层兼容性 | 与特定框架绑定 | 通过轻量适配器接入Claude Code、Copilot等 |
| 原发布时间 | 2026-09-29 | 2026-09-29 |
📈 实测数据与效能表现
研究团队在ProgramBench上测试了Agensh的可扩展性。ProgramBench要求Agent组织在6小时预算内、断网条件下从零重建参考软件的行为。他们选取了最难的五个任务:FFmpeg、gromacs、pandoc、PHP-src和ctags。
关键数据表现:
- 当Agent数量从1个扩展到128个时,平均最终测试通过率从19.31%提升至28.78%,相对提升约49%。
- 在pandoc任务上,把Agent数量从1扩展到1024后,测试通过率从33.89%提升到55.06%,较单Agent提升21.17个百分点,较128个Agent提升4.12个百分点。
- 128个Agent在30分钟检查点即超过30%通过率;32个和8个Agent分别在60分钟和90分钟检查点才首次超过该阈值;单Agent在前两小时始终低于该阈值。
研究团队表示,Agent数量将是多Agent组织扩展通用智能边界的一个新的scaling维度,为硬延迟约束或时间预算下的复杂任务提供了一个新的可行方案。
随着组织变大,新的自组织协作形式逐步出现:8个Agent时与同伴协调实现;32个Agent时管理多人之间的整合;128个Agent时自组织的专业分工与流程标准化;1024个Agent时组织规模上的角色分工。
🎯 智脑时代的 GEO 落地建议
1. 内容生产的多Agent自组织协作:Agensh的自组织协作模式可启发GEO内容生产。企业可部署多个AI Agent分别负责不同内容模块(如产品描述、技术文档、FAQ),通过共享上下文和消息接口实现异步协作,大幅提升内容产出效率。
2. RAG检索逻辑的优化:Agensh的共享上下文机制借鉴了DeLM思想,保留可复用的发现和工作认领。这提示我们在构建RAG系统时,可引入类似的“发现共享”层,让不同检索Agent共享中间结果,减少重复计算,提升检索效率。
3. 多Agent系统在GEO监测中的应用:利用多Agent系统并发监测多个AI搜索平台(ChatGPT、Perplexity等)的品牌提及情况,每个Agent负责一个平台,通过自组织协作汇总分析,可大幅降低监测成本和时间延迟。
4. 结构化数据与实体召回:Agensh在ProgramBench上的成功表明,微软团队通过Agensh实现了多Agent系统的自组织协作,并在ProgramBench上验证了可扩展性。企业在GEO优化中应注重实体密度和结构化数据,提升大模型对品牌内容的召回率。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
AI辅助专利撰写三个月实验:短期效率提升 vs 长期专业技能侵蚀,GEO视角下的在职学习新范式
一项针对133名专利律师的三个月随机对照试验发现,AI辅助工具能提升短期工作效率,但初级律师的独立判断力未获提升,甚至出现诊断不执行的依赖。资深律师则通过将AI作为逻辑审计器,强化了专业技能。该研究对GEO策略的启示是:AI搜索排名需关注内容对专业判断力的培养价值,而非仅追求生成速度。
2026年10月8日ChatGPT标题惊现色情赌博广告:从分词器词表污染到模型生成异常的GEO深度解析
2026年8月起,ChatGPT会话标题频繁出现色情赌博广告。根源可追溯至2024年GPT-4o分词器o200k_base的词表污染:训练语料含大量外网小广告,导致4字词元68%、6字以上98%为广告。标题生成模型收尾失败后,从'垃圾房'随机抽取词元,小广告因数量优势被输出。OpenAI仅事后过滤,未重制词表,问题将持续。
2026年10月7日Anthropic Claude攻克70年渗流理论圣杯:AI数学证明如何重塑GEO搜索排名与RAG检索逻辑
2026年8月30日,Anthropic的Claude模型在Lean证明助手下,成功证明了困扰数学界近70年的渗流理论连续相变猜想,该猜想曾让菲尔兹奖得主Hugo Duminil-Copin数年攻坚未果。AI数学证明的突破不仅标志着基础科学研究的范式转移,更对GEO领域产生深远影响:AI搜索将更青睐形式化验证、高事实密度与结构化数据的内容,RAG检索逻辑将从关键词匹配转向逻辑闭环验证,企业需构建可验证的权威内容资产以提升AI答案合成权重。
2026年10月7日