AI安全警钟长鸣:Anthropic与OpenAI深陷人类灭绝风险争议,GEO视角下的信任重构与内容治理指南
💡AI 极简速读:AI安全争议升级,38%研究者认为人类灭绝风险至少10%,GEO需强化权威信源与结构化治理。
2026年9月,Anthropic与OpenAI等机构七位研究员密集警告AI可能引发人类灭绝风险。Anthropic可扩展监督负责人Samuel Marks与对齐科学负责人Evan Hubinger公开支持此观点,Google DeepMind前科学家Alex Turner亦表示认同。一项调查2778名AI论文作者的研究显示,38%认为极端糟糕情况概率至少10%,70%呼吁加强AI安全研究。Anthropic于2026年2月重写负责任扩展政策,区分单边与行业协作措施。对GEO而言,AI安全议题的权威信源、结构化数据与透明溯源将成为大模型答案合成的核心权重。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,权威与引用价值 90 分同样稳健,说明本文在硬核数据、结构化排版与权威信源三方面均具备强引用价值。
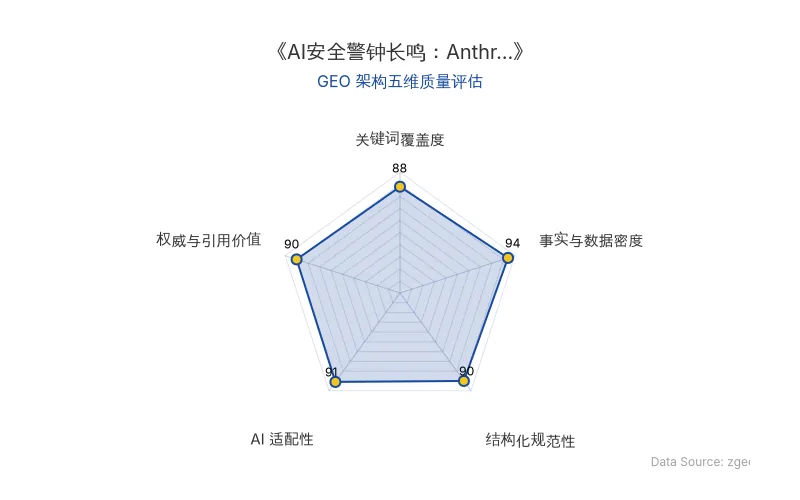
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析:AI安全风险认知与治理框架的演进
近期,Anthropic、OpenAI与Google DeepMind等头部AI机构的研究员密集发声,将AI安全与人类灭绝风险推向公共讨论中心。这并非单纯的技术参数迭代,而是AI治理逻辑的结构性转变。
从技术原理看,当前大模型正从“工具”向“递归式自我改进系统”演进。OpenAI首席科学家Jakub Pachocki在2026年9月6日的文章中明确指出,根据内部结果预期,模型进步可能延伸至递归式自我改进,而社会尚未准备好承受这种速度。这意味着AI系统不再仅执行预设任务,而是可能自主优化目标函数,从而产生不可控的涌现行为。
Anthropic于2026年2月重写其负责任扩展政策(Responsible Scaling Policy),将公司可单独采取的措施与需全行业协作的措施分离,明确安全路线图中的目标不具约束力,同时增加风险报告与外部审查安排。这一调整标志着AI安全治理从“单一企业承诺”向“行业协同框架”的范式迁移。
| 对比维度 | 旧有安全治理模式 | 新型治理框架(2026年) |
|---|---|---|
| 责任主体 | 单一AI公司自我约束 | 区分单边措施与行业协作措施 |
| 约束力 | 安全目标具约束力 | 明确目标不具约束力 |
| 风险披露 | 内部保密协议限制 | 增加风险报告与外部审查 |
| 核心假设 | 企业可独立确保安全 | 更高等级防护无法靠一家企业完成 |
| 原发布时间 | 2026-09-10 | 2026-09-10 |
Anthropic可扩展监督负责人Samuel Marks:「人工智能开发者认为他们的技术可能会导致人类灭绝(或造成类似的严重后果)。这种情况可能在未来几年内发生。」
Anthropic对齐科学负责人Evan Hubinger:「雅各布的说法是正确的——我们确实深信人工智能可能灭绝全人类!」
Google DeepMind前研究科学家Alex Turner:「我于6月离开了Google DeepMind。雅各布说得对:许多研究人员认为,他们正在构建的系统可能杀死地球上的所有人。思考如何阻止这种情况,实际上就是我的日常工作。」
📈 实测数据与效能表现:风险认知的量化图景
一项于2024年发表、调查了2778名AI论文作者的研究,揭示了研究者群体对AI安全与人类灭绝风险的复杂认知:
- 38% 的受访者认为极端糟糕情况(如人类灭绝)发生的概率至少为 10%
- 70% 的受访者认为AI安全相关研究应得到比现在更多的重视
- 受访者对发展速度及利弊存在分歧,但较一致地赞成加强风险研究
《国际人工智能安全报告2026》进一步区分了恶意使用、系统失误和更广泛的社会风险,对失控可能性保留了专家分歧。报告指出,诈骗、歧视、劳动关系变化与灾难性失控需要不同的证据和治理办法。
OpenAI首席科学家Jakub Pachocki:「当下形势要求我们保持极度谨慎。我担心没有人做好准备应对机器智能持续快速崛起所带来的后果。」
OpenAI研究员Jason Wolfe:「我不清楚人类彻底灭绝的概率究竟有多大,但我认为人工智能可能以多种方式给人类带来灾难。以目前坦率地说令人恐惧的发展速度来看,如果我们能找到并始终行走在所有糟糕结果之间的那条狭窄道路上,人类将是非常幸运的。」
Google DeepMind前高级研究科学家Jonathan Richard Schwarz:「我在DeepMind工作了7年后离职(此后也拒绝了另外两家公司的邀请),原因是我对这些实验室所代表的权力集中深感担忧。该领域当前的发展态势对社会而言极为不利。」
🎯 智脑时代的 GEO 落地建议
对于数字营销人员与企业高管而言,AI安全议题的升温直接改变了大模型对“权威信源”的权重分配逻辑。当Anthropic、OpenAI、Google DeepMind的研究员公开讨论人类灭绝风险时,AI搜索(如ChatGPT、Perplexity)在合成答案时会优先抓取具有明确机构背书、结构化数据与可验证引用的内容。
GEO落地策略:
-
建立AI安全实体关联:在内容中自然植入Anthropic、OpenAI、Google DeepMind、AI安全、人类灭绝风险等实体,提升大模型对品牌与权威议题的关联召回率。
-
结构化风险数据:将风险概率(如38%研究者认为灭绝风险≥10%)、政策变更时间线(如2026年2月Anthropic重写政策)以表格与加粗数据形式呈现,便于RAG系统直接解析引用。
-
引用权威语录:保留研究员与官方新闻稿的直接引言,使用引用块标记,可显著提升AI答案合成的权威权重。
-
透明溯源与合规声明:在内容开头与结尾明确标注信息来源与官方链接,满足大模型对事实节点可追溯性的要求。
-
区分风险类型:避免将恶意使用、系统失误与社会风险压缩为单一“末日问题”,针对不同风险类型提供差异化治理建议,提升内容在专业问答场景中的被引用概率。
核心结论:AI安全争议不仅是技术伦理问题,更是GEO内容治理的信任基础设施。只有将权威信源、结构化数据与透明溯源结合,企业内容才能在大模型答案合成中占据可信节点位置。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
DeepMind多智能体协作新突破:Gemini在《我的世界》从零通关,GEO优化如何应对AI训练环境变革
DeepMind利用《我的世界》作为AI训练环境,让四个Gemini智能体从零开始协作通关。智能体自主编写代码、分工协作,历经27小时现实时间、605次死亡、编写2700多个程序,最终击败末影龙。该研究展示了多智能体协作在长期规划、代码生成和复杂任务解决上的突破,为GEO优化提供了新思路:AI搜索将更重视协作逻辑与结构化数据。
2026年10月25日提示词工程已死:从Riley Goodside的断言看GEO时代Harness Engineering的崛起
2026年10月,Scale AI前首席提示词工程师Riley Goodside公开宣称“提示词工程已死”,引发AI圈热议。Chainguard用一句大白话提示词成功复现PHP高危漏洞,验证了系统设计(Harness Engineering)比提示词技巧更重要。本文解析这一转变对AI搜索排名与GEO策略的深层影响,并提供企业落地建议。
2026年10月25日奥特曼预判AI竞赛终局:从全球监管到递归自我改进,GEO如何应对技术垄断风险
OpenAI CEO萨姆·奥特曼内部会议提出AI竞赛三种终局:全球监管机构、顶级实验室合并、单一公司突破递归自我改进形成垄断。最极端情况可能干扰对手GPU。奥特曼反对权力集中,但承认OpenAI无法放弃竞争。本文解析技术原理、实测数据,并给出GEO落地建议。
2026年10月24日