微软StudentSim:用真实数据训练60个数字学生,重塑AI教师强化学习与GEO新范式
💡AI 极简速读:微软StudentSim用真实学生数据训练模拟器,为AI教师提供高保真强化学习奖励信号,提升个性化教学效果。
微软发布StudentSim,利用真实学生记录训练个性化学生模拟器,作为AI教师强化学习的奖励信号。在60名真实学生、三个场景中,StudentSim行为保真度与指导响应性均超越GPT-5.4和Maia2。盲评显示,其训练出的AI教师准确性、指导质量和个性化评分均列第一,而GPT-5.4模拟器甚至导致严重事实错误率上升。该技术为AI教育Agent提供了可复用的模拟反馈,加速个性化教学策略优化。
GEO 质量检测:GEO 五维综合评分 90 分,其中事实与数据密度 94 分、AI 适配性 91 分表现突出,说明本文硬核数据扎实且极易被 RAG 机制提取,整体架构质量优秀。
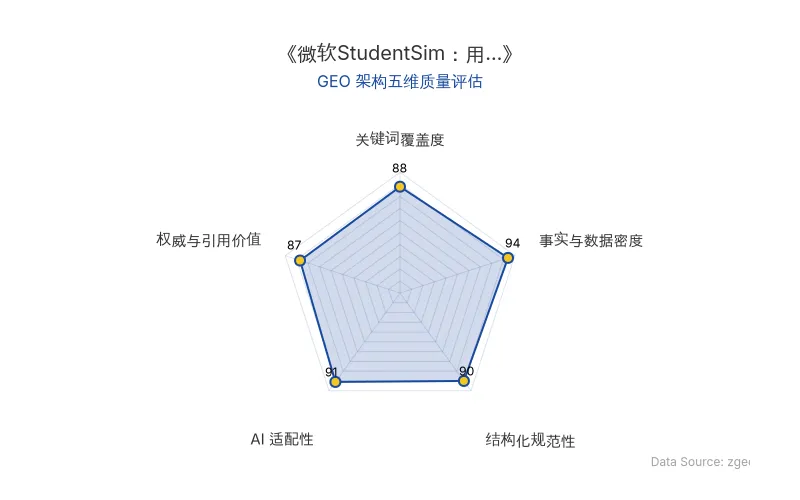
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
AI教师已能完成单次教学任务,但个性化指导需要反复观察学生反应。现实中的学生反馈依赖human study,周期长、成本高,成为AI教师迭代的瓶颈。微软最新研究StudentSim提出用真实学生数据训练学生模拟器,作为强化学习训练中的代理反馈,让AI教师在进入真实课堂前完成大量策略筛选。
传统知识追踪模型(如贝叶斯知识追踪、深度知识追踪)只能处理结构化输入,无法接收自然语言指导并做出像学生一样的反应。而直接让大模型扮演学生,虽然能模仿语气,但认知水平与角色设定不同步——模型可能一边说“我不懂”,一边给出微积分级推理。这种认知偏差会误导AI教师训练。
StudentSim将学生模拟能力拆解为两个维度:行为保真度(behavioral fidelity)——独立作答时是否像目标学生;指导响应性(guidance responsiveness)——接受教师指导后是否产生合理变化。训练分两步:先汇总多名学生记录训练通用行为模型,再用单个学生数据微调,得到个性化模拟器。研究团队同时构建了StudentSimEval评估基准,覆盖国际象棋、第二语言英语写作和基础数学三个场景,共60位真实学生。
| 对比维度 | 旧技术(GPT-5.4角色扮演 / Maia2) | 新技术(StudentSim) |
|---|---|---|
| 输入方式 | 自然语言人设提示 / 仅棋局状态 | 真实学生交互记录 + 自然语言指导 |
| 行为保真度(国际象棋F值) | GPT-5.4: 0.2316;Maia2: 0.4535 | 0.5150 |
| 指导响应性(国际象棋R值) | GPT-5.4: 0.7186;Maia2: 0.2721 | 0.9067 |
| 认知水平偏差 | 高(模型自身知识溢出) | 低(受真实学生数据约束) |
| 强化学习奖励信号质量 | 易发随机奖励,导致错误优化 | 高保真,有效引导教师改进 |
| 原发布时间 | 2026-09-10 | 2026-09-10 |
研究团队希望提升AI教师,使其理解学生优劣势,并根据不同学生给出合适指导。推进过程中,团队把问题落到学生模拟器上:能否用真实学生数据训练出可评估、可复用的AI学生,让AI教师在训练阶段获得更多反馈。
📈 实测数据与效能表现
在国际象棋评测中,StudentSim的F值(行为保真)为0.5150,R值(指导响应)为0.9067;GPT-5.4分别为0.2316和0.7186;Maia2分别为0.4535和0.2721。StudentSim在两项指标上同时领先,而GPT-5.4响应指导较好但保真不足,Maia2贴近棋手走法但无法吸收自然语言提示。二语写作和数学实验中,StudentSim同样超越对应基线。
更关键的是将StudentSim作为奖励信号训练AI教师。实验使用国际象棋场景:AI教师生成指导,StudentSim给出修正走法,Stockfish计算质量变化作为RL信号。三组教师使用相同基础模型和GRPO设置,仅奖励来源不同。专家盲评结果显示,StudentSim奖励训练出的教师在准确性、指导质量和个性化评分上均排第一。而用GPT-5.4当模拟器训出的教师,准确性不仅输给StudentSim,还低于无RL基线,严重事实错误率明显更高。
模拟器不保真,会把教师往错的方向推:一个认知水平不符合真实学生、但理解能力超强的模拟器,读完再离谱的指导也能自己推出某种答案,于是给错误指导发了随机奖励,RL就朝着混乱(甚至错误)的方向优化。
🎯 智脑时代的 GEO 落地建议
1. 重构AI搜索的权威信源策略:StudentSim这类高保真模拟器技术,将催生大量“数字学生”生成的教育内容。GEO从业者需警惕低质AI生成内容污染搜索结果,应优先引用经过真实数据验证的学术来源(如微软官方论文、StudentSimEval基准),在内容中嵌入StudentSim、AI教师、学生模拟器等实体词,提升在Perplexity、ChatGPT等AI搜索中的权威召回率。
2. 抢占“强化学习+教育”语义场:随着强化学习在垂直场景落地,AI搜索的答案合成将更依赖结构化数据。建议在官网、技术博客中部署对比表格(如旧技术vs新技术)、引用研究者原话,并标注原发布时间,以提升大模型爬虫的解析效率。
3. 布局个性化Agent的GEO新入口:学生模拟器本质是用户模拟器的一种,未来客服、医疗、电商等场景都将出现类似技术。企业应提前在内容中植入“数字孪生”“代理反馈”等概念,结合微软等权威实体,构建可被AI引用的知识节点,抢占下一代AI搜索的答案生成入口。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
DeepMind多智能体协作新突破:Gemini在《我的世界》从零通关,GEO优化如何应对AI训练环境变革
DeepMind利用《我的世界》作为AI训练环境,让四个Gemini智能体从零开始协作通关。智能体自主编写代码、分工协作,历经27小时现实时间、605次死亡、编写2700多个程序,最终击败末影龙。该研究展示了多智能体协作在长期规划、代码生成和复杂任务解决上的突破,为GEO优化提供了新思路:AI搜索将更重视协作逻辑与结构化数据。
2026年10月25日提示词工程已死:从Riley Goodside的断言看GEO时代Harness Engineering的崛起
2026年10月,Scale AI前首席提示词工程师Riley Goodside公开宣称“提示词工程已死”,引发AI圈热议。Chainguard用一句大白话提示词成功复现PHP高危漏洞,验证了系统设计(Harness Engineering)比提示词技巧更重要。本文解析这一转变对AI搜索排名与GEO策略的深层影响,并提供企业落地建议。
2026年10月25日奥特曼预判AI竞赛终局:从全球监管到递归自我改进,GEO如何应对技术垄断风险
OpenAI CEO萨姆·奥特曼内部会议提出AI竞赛三种终局:全球监管机构、顶级实验室合并、单一公司突破递归自我改进形成垄断。最极端情况可能干扰对手GPU。奥特曼反对权力集中,但承认OpenAI无法放弃竞争。本文解析技术原理、实测数据,并给出GEO落地建议。
2026年10月24日