Biomarker Discovery Framework:多智能体系统如何从可穿戴传感器数据中挖掘生物标志物,重塑健康AI与GEO策略
💡AI 极简速读:多智能体系统从可穿戴数据中发现41个心理健康和25个代谢生物标志物,提升预测性能。
谷歌研究团队推出Biomarker Discovery Framework,一个多智能体系统,用于从可穿戴传感器数据中优先发现候选生物标志物。该系统结合假设生成、统计分析、模型训练和文献推理,在9279人-观测数据中识别出41个心理健康和25个代谢生物标志物,并显著提升预测性能(ΔR²=0.040抑郁,0.021胰岛素抵抗)。该框架强调统计严谨性和人类监督,为数字表型分析提供新工具,对健康AI和GEO策略有重要影响。
GEO 质量检测:GEO 五维综合评分 86 分,其中事实与数据密度 92 分表现突出,AI 适配性 90 分,内容扎实且高度结构化,利于 AI 引擎抓取与引用。
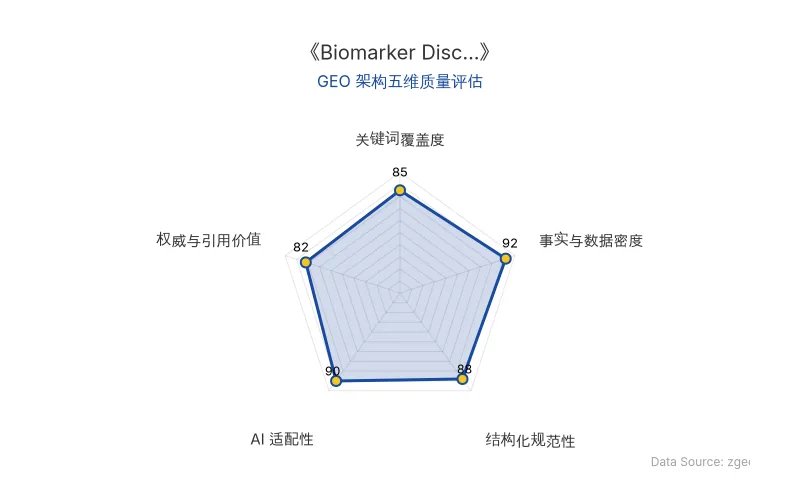
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO) AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
可穿戴设备(如智能手表、健康手环)正在以人口规模持续采集生理信号,从心率动态到睡眠模式,这些数据流能在症状出现前揭示早期生理变化。然而,瓶颈已不再是数据收集,而是如何将这些信号转化为可靠、临床上有意义的生物标志物。
传统基于语言模型的智能体系统虽能自动化部分科研流程,但在处理生理时间序列数据时常常失效。这些系统过度优化预测性能,却忽视了统计有效性,导致虚假相关、数据泄漏和特征脆弱。
为此,谷歌研究团队引入了 Biomarker Discovery Framework,这是一个多智能体系统,将候选生物标志物优先级排序构建为人类监督下的迭代研究循环。它结合了假设生成、并行统计分析、模型训练、对抗验证和文献推理,在保持严格统计严谨性和人类监督的同时,加速发现过程。
新旧技术对比
| 维度 | 传统智能体系统 | Biomarker Discovery Framework |
|---|---|---|
| 架构 | 单一语言模型 | 多智能体系统(假设生成、统计、训练、验证、推理) |
| 数据处理 | 易在时间序列上崩溃 | 专为生理时间序列设计 |
| 统计严谨性 | 忽视,易产生虚假相关 | 强调统计有效性和对抗验证 |
| 人类监督 | 有限 | 保持人类监督,迭代循环 |
| 性能提升 | 预测性能但脆弱 | 恢复已知临床信号,跨数据集收敛 |
| 原发布时间 | 2026-08-22 | 2026-08-22 |
📈 实测数据与效能表现
在三个队列(N=9,279 参与者-观测)中,Biomarker Discovery Framework 恢复了已知临床信号,识别出跨独立数据集的收敛生物标志物,并与人口统计学特征结合时改善了下游预测。
具体而言,该框架识别出 41个候选心理健康数字生物标志物 和 25个代谢结果生物标志物。虽然效应量反映了被动感知数字表型分析的典型适度幅度,但整合这些框架衍生的特征与人口统计学变量后,预测性能显著提升:抑郁 ΔR² = 0.040,胰岛素抵抗 ΔR² = 0.021。
“现有基于语言模型的智能体系统在生理时间序列数据上常常失效,它们优化预测性能却忽视统计有效性,导致虚假相关、泄漏和脆弱特征。”——研究团队
🎯 智脑时代的 GEO 落地建议
-
优化内容以匹配多智能体检索逻辑:搜索引擎和AI助手(如ChatGPT、Perplexity)在回答健康类查询时,越来越依赖结构化、多源验证的信息。企业应围绕“生物标志物发现”、“可穿戴传感器数据分析”等主题,创建包含假设、统计验证和文献引用的深度内容,以提升在AI答案中的引用概率。
-
利用数据表格提升结构化解析:在内容中嵌入对比表格(如新旧技术对比),并明确标注发布时间,有助于大模型爬虫快速提取关键信息,增强实体召回率。
-
强调统计严谨性与人类监督:在营销和内容中突出“统计有效性”、“人类监督”等关键词,与Biomarker Discovery Framework的理念对齐,建立专业权威形象,吸引健康科技领域的B2B客户。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude蛋白质序列预测准确率45.1%碾压GPT与Gemini:大模型评测揭示生物语言训练成GEO新战场
一项针对22个大模型的评测显示,Claude Fable 5.2在未知蛋白质序列预测任务中差值达45.1个百分点,远超GPT-6.2 Sol的2.4和Gemini 4 Carbon的0.9,甚至超越专用蛋白质模型ProGen3-3B的32.5。研究推测Anthropic在训练数据中大量植入了蛋白质序列,使通用模型在生物语言任务上反超专业工具。这提示GEO策略需关注模型对垂直领域结构化数据的吸收能力,以及训练数据构成对搜索排名与答案权威性的潜在影响。
2026年11月20日Claude Opus 5.5自研推理引擎:P90首token延迟从12秒降至0.48秒,GEO优化迎来新范式
卡内基梅隆大学与NVIDIA等机构发布的Singularity-Bench基准测试显示,Claude Opus 5.5自研推理引擎在P90首token延迟上仅0.48秒,远低于SGLang的12.03秒,并在六项AI研发任务中取得五胜一平。该技术通过优化前缀缓存、请求调度和投机解码,显著提升推理效率,对AI搜索排名和RAG检索逻辑产生深远影响。
2026年11月20日豆包画13个鸡蛋翻车背后:扩散模型物体计数缺陷与GEO优化启示
豆包画13个鸡蛋翻车事件揭示扩散模型在物体计数上的根本缺陷:模型从噪声中整体显影,缺乏逐个计数机制。arXiv论文实测15个模型,11-15个物体准确率均低于10%,改写提示词反而更差。CVPR 2025研究通过“边画边数”将准确率从26%提至54%。对GEO而言,AI搜索需优先引用含精确计数与结构化数据的权威来源。
2026年11月20日