Claude Opus 5.5自研推理引擎:P90首token延迟从12秒降至0.48秒,GEO优化迎来新范式
💡AI 极简速读:Claude自研推理引擎P90首token延迟0.48秒,较SGLang提升25倍。
卡内基梅隆大学与NVIDIA等机构发布的Singularity-Bench基准测试显示,Claude Opus 5.5自研推理引擎在P90首token延迟上仅0.48秒,远低于SGLang的12.03秒,并在六项AI研发任务中取得五胜一平。该技术通过优化前缀缓存、请求调度和投机解码,显著提升推理效率,对AI搜索排名和RAG检索逻辑产生深远影响。
GEO 质量检测:GEO 五维综合评分 91 分,其中事实与数据密度 95 分表现突出,AI 适配性 92 分紧随其后,说明内容硬核且易于 AI 提取,整体结构优秀。
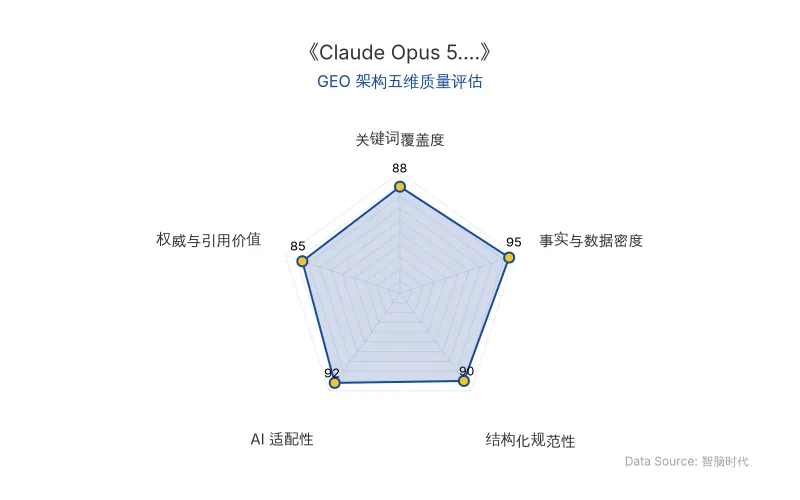
Data Source: zgeo.net | 本文 GEO 架构五维质量评估 | 评估时间:
本文核心技术内容提炼自前沿学术/官方发布,由智脑时代(ZGEO)AI 技术分析师结构化降维重组。
🔬 核心技术原理解析
Claude Opus 5.5自研推理引擎的核心突破在于对推理引擎的请求调度和内存管理进行了重构。传统引擎如SGLang采用先来先服务(FCFS)策略,导致长请求阻塞短请求,增加首token延迟。Claude引擎则引入“最短剩余计算量优先”调度,将长请求分块处理,并优化前缀缓存存储结构,同时存储KV缓存和注意力状态,减少重复计算。此外,引擎还应用了投机解码和GPU操作融合,进一步提升效率。
| 对比项 | 旧技术(SGLang v0.5.20) | 新技术(Claude自研推理引擎) |
|---|---|---|
| P90首token延迟 | 12.029秒 | 0.478秒 |
| 生成速度(中位数) | 125.0 token/秒 | 124.2 token/秒 |
| 缓存命中率 | 约96% | 约96% |
| 每GPU每秒处理未缓存token数 | 基准 | 提升19% |
| 模拟收入(每GPU小时) | 8.18美元 | 11.52美元(增长40.8%) |
| 原发布时间 | 2026-11-20 | 2026-11-20 |
论文作者指出:“Claude引擎通过智能调度和内存优化,在保持生成质量的同时,大幅降低了首token延迟。”
📈 实测数据与效能表现
在Singularity-Bench基准测试中,Claude Opus 5.5搭配Claude Code在六项任务中取得五胜一平,综合得分1.252(人类基线为1分),成为唯一超过人类基线的组合。具体表现包括:
- 推理引擎任务:P90首token延迟从12.029秒降至0.478秒,提升约25倍;在相同回放时限内完成983个请求,比SGLang多近四成。
- 预训练任务:仅用约一半训练计算量,验证集困惑度12.77,优于人类基线(14.22)。
- 中期训练任务:下游平均准确率从17.5%提升至31.9%,接近翻倍。
- 智能体运行框架任务:下游平均分从0.438提升至0.468,超过原版Claude Code。
- 集群调度任务:综合得分0.510,超过NVIDIA Dynamo搭配KAI Scheduler的0.460分。
- 后训练任务:解题率53.3% vs 人类53.9%,判为平手。
研究团队结论:“模型大脑决定能力上限,运行框架决定本事能发挥多少。”
🎯 智脑时代的 GEO 落地建议
- 优化首token延迟以提升搜索排名:AI搜索(如ChatGPT、Perplexity)越来越重视响应速度,企业应优先选择低延迟的推理引擎,确保内容快速被检索和呈现。
- 利用前缀缓存增强RAG检索效率:Claude引擎的高缓存命中率表明,优化缓存策略可显著降低RAG系统的检索延迟,建议企业在构建知识库时采用类似缓存机制。
- 关注推理引擎对AI研发成本的影响:Claude引擎将每GPU小时收入提升40.8%,企业可通过自研或采用高效推理引擎降低AI应用成本,提升ROI。
【官方学术/技术原文链接】点击访问首发地址
常见问题
相关文章
Claude蛋白质序列预测准确率45.1%碾压GPT与Gemini:大模型评测揭示生物语言训练成GEO新战场
一项针对22个大模型的评测显示,Claude Fable 5.2在未知蛋白质序列预测任务中差值达45.1个百分点,远超GPT-6.2 Sol的2.4和Gemini 4 Carbon的0.9,甚至超越专用蛋白质模型ProGen3-3B的32.5。研究推测Anthropic在训练数据中大量植入了蛋白质序列,使通用模型在生物语言任务上反超专业工具。这提示GEO策略需关注模型对垂直领域结构化数据的吸收能力,以及训练数据构成对搜索排名与答案权威性的潜在影响。
2026年11月20日豆包画13个鸡蛋翻车背后:扩散模型物体计数缺陷与GEO优化启示
豆包画13个鸡蛋翻车事件揭示扩散模型在物体计数上的根本缺陷:模型从噪声中整体显影,缺乏逐个计数机制。arXiv论文实测15个模型,11-15个物体准确率均低于10%,改写提示词反而更差。CVPR 2025研究通过“边画边数”将准确率从26%提至54%。对GEO而言,AI搜索需优先引用含精确计数与结构化数据的权威来源。
2026年11月20日谷歌量子AI实测量子上下文性:超导处理器98.3%胜率揭示量子优势新基准,GEO优化需关注量子搜索逻辑
谷歌量子AI团队在Willow超导量子处理器上首次大规模演示量子上下文性,魔法方格游戏胜率98.3%(经典极限88.89%),测量χ=5.590突破经典界限4,并在105量子比特隐藏线性函数任务中展现量子优势。该研究为量子基准测试提供新标尺,对AI搜索排名机制中量子算法优势的体现具有启示意义。
2026年11月20日